SQL-voorbeelden gebruiken PostgreSQL, tenzij een andere dialect wordt genoemd. Korte fragmenten gaan ervan uit dat hun verwijderde tabellen al bestaan. Valideer DDL in uw doeldatabase voordat u deze toepast.
SQL-relatiepatronen begrijpen
Relationele databases ontlenen hun kracht aan de verbindingen tussen tabellen. Of u nu een kleine applicatie of een enterprise datawarehouse ontwerpt, het kiezen van het juiste relatiepatroon bepaalt hoe efficiënt u uw gegevens kunt opslaan, opvragen en onderhouden. De drie fundamentele patronen—een-op-een, een-op-veel, en veel-op-veel— dekken veelvoorkomende associaties af; recursieve relaties en relaties van hogere graad vereisen aanvullende modellering.
In deze handleiding lichten we elk patroon toe met PostgreSQL-voorbeelden, verkennen we de rol van koppeltabellen en tonen we hoe deze relaties verschijnen op een Entiteit-Relatiediagram (ERD). Als u uw eigen schema nu wilt visualiseren, open dan de Erd Go-editor en plak ondersteunde CREATE TABLE definities om een diagram te genereren.
Eén-op-veel-relaties
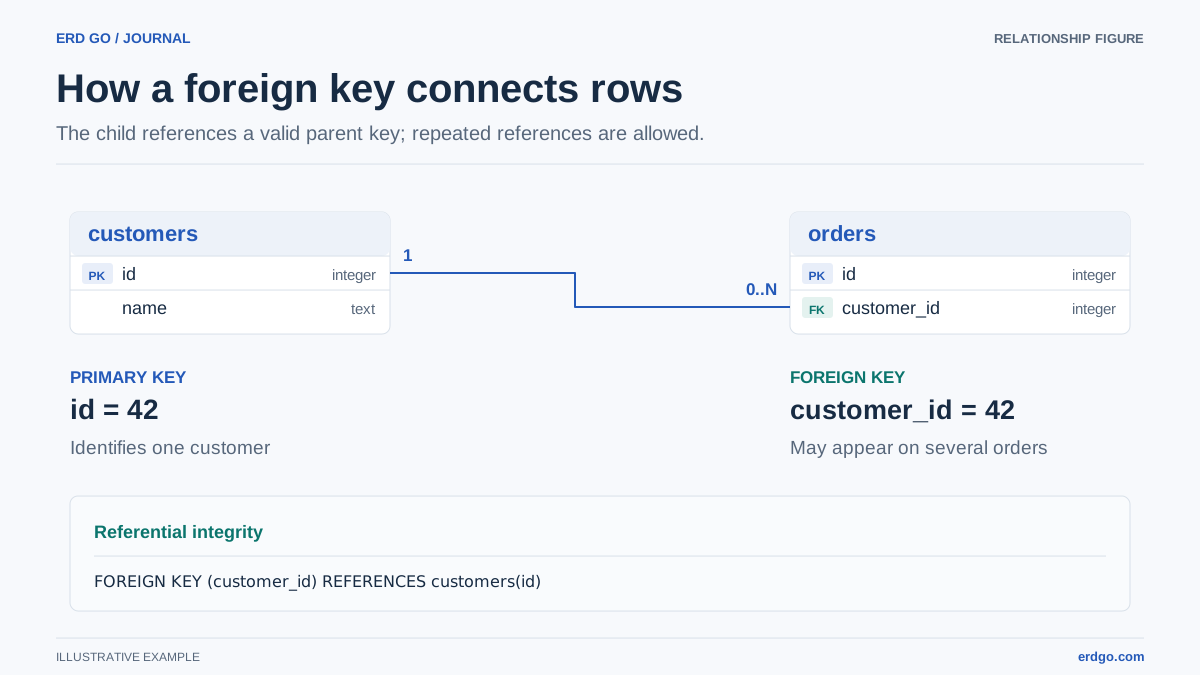
A een-op-veel (1:N)-relatie is het meest voorkomende patroon in databaseontwerp. Dit betekent dat een enkele rij in de ouder tabel kan worden waarnaar wordt verwezen door veel rijen in de kind tabel, en een niet-null kind foreign key wijst naar één ouder. Een nullable foreign key staat een kind toe zonder ouder.
Klassiek voorbeeld: Afdelingen en Werknemers
Een bedrijf heeft vele afdelingen en elke afdeling bevat meerdere werknemers. Elk bedrijf behoort echter op elk moment tot precies één afdeling.
CREATE TABLE departments (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(100) NOT NULL,
    location    VARCHAR(255),
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE employees (
    id              SERIAL PRIMARY KEY,
    first_name      VARCHAR(50) NOT NULL,
    last_name       VARCHAR(50) NOT NULL,
    email           VARCHAR(255) UNIQUE NOT NULL,
    department_id   INT NOT NULL,
    hire_date       DATE DEFAULT CURRENT_DATE,
    CONSTRAINT fk_department
        FOREIGN KEY (department_id)
        REFERENCES departments (id)
        ON DELETE RESTRICT
        ON UPDATE CASCADE
);
Belangrijke implementatiedetails
- De foreign key (
department_id) bevindt zich altijd op de veel zijde—deemployeestabel in dit geval. ON DELETE RESTRICTvoorkomt het per ongeluk verwijderen van een afdeling waaraan nog werknemers zijn toegewezen.ON UPDATE CASCADEzorgt ervoor dat als de primaire sleutel van een afdeling verandert, alle werknemersrijen automatisch worden bijgewerkt.- Het toevoegen van een index op
department_idkan helpen bij joins en afdelingsfilters; bevestig het voordeel met representatieve gegevens en een uitvoeringsplan.
Een-op-veelgegevens opvragen
-- All employees in the Engineering department
SELECT e.first_name, e.last_name, d.name AS department
FROM employees e
JOIN departments d ON d.id = e.department_id
WHERE d.name = 'Engineering';

-- Count employees per department
SELECT d.name, COUNT(e.id) AS headcount
FROM departments d
LEFT JOIN employees e ON e.department_id = d.id
GROUP BY d.id, d.name
ORDER BY headcount DESC;
Andere alledaagse één-op-veel-voorbeelden zijn onder andere auteurs → blogposts, klanten → bestellingen, en categorieën → producten.
Veel-op-veel-relaties
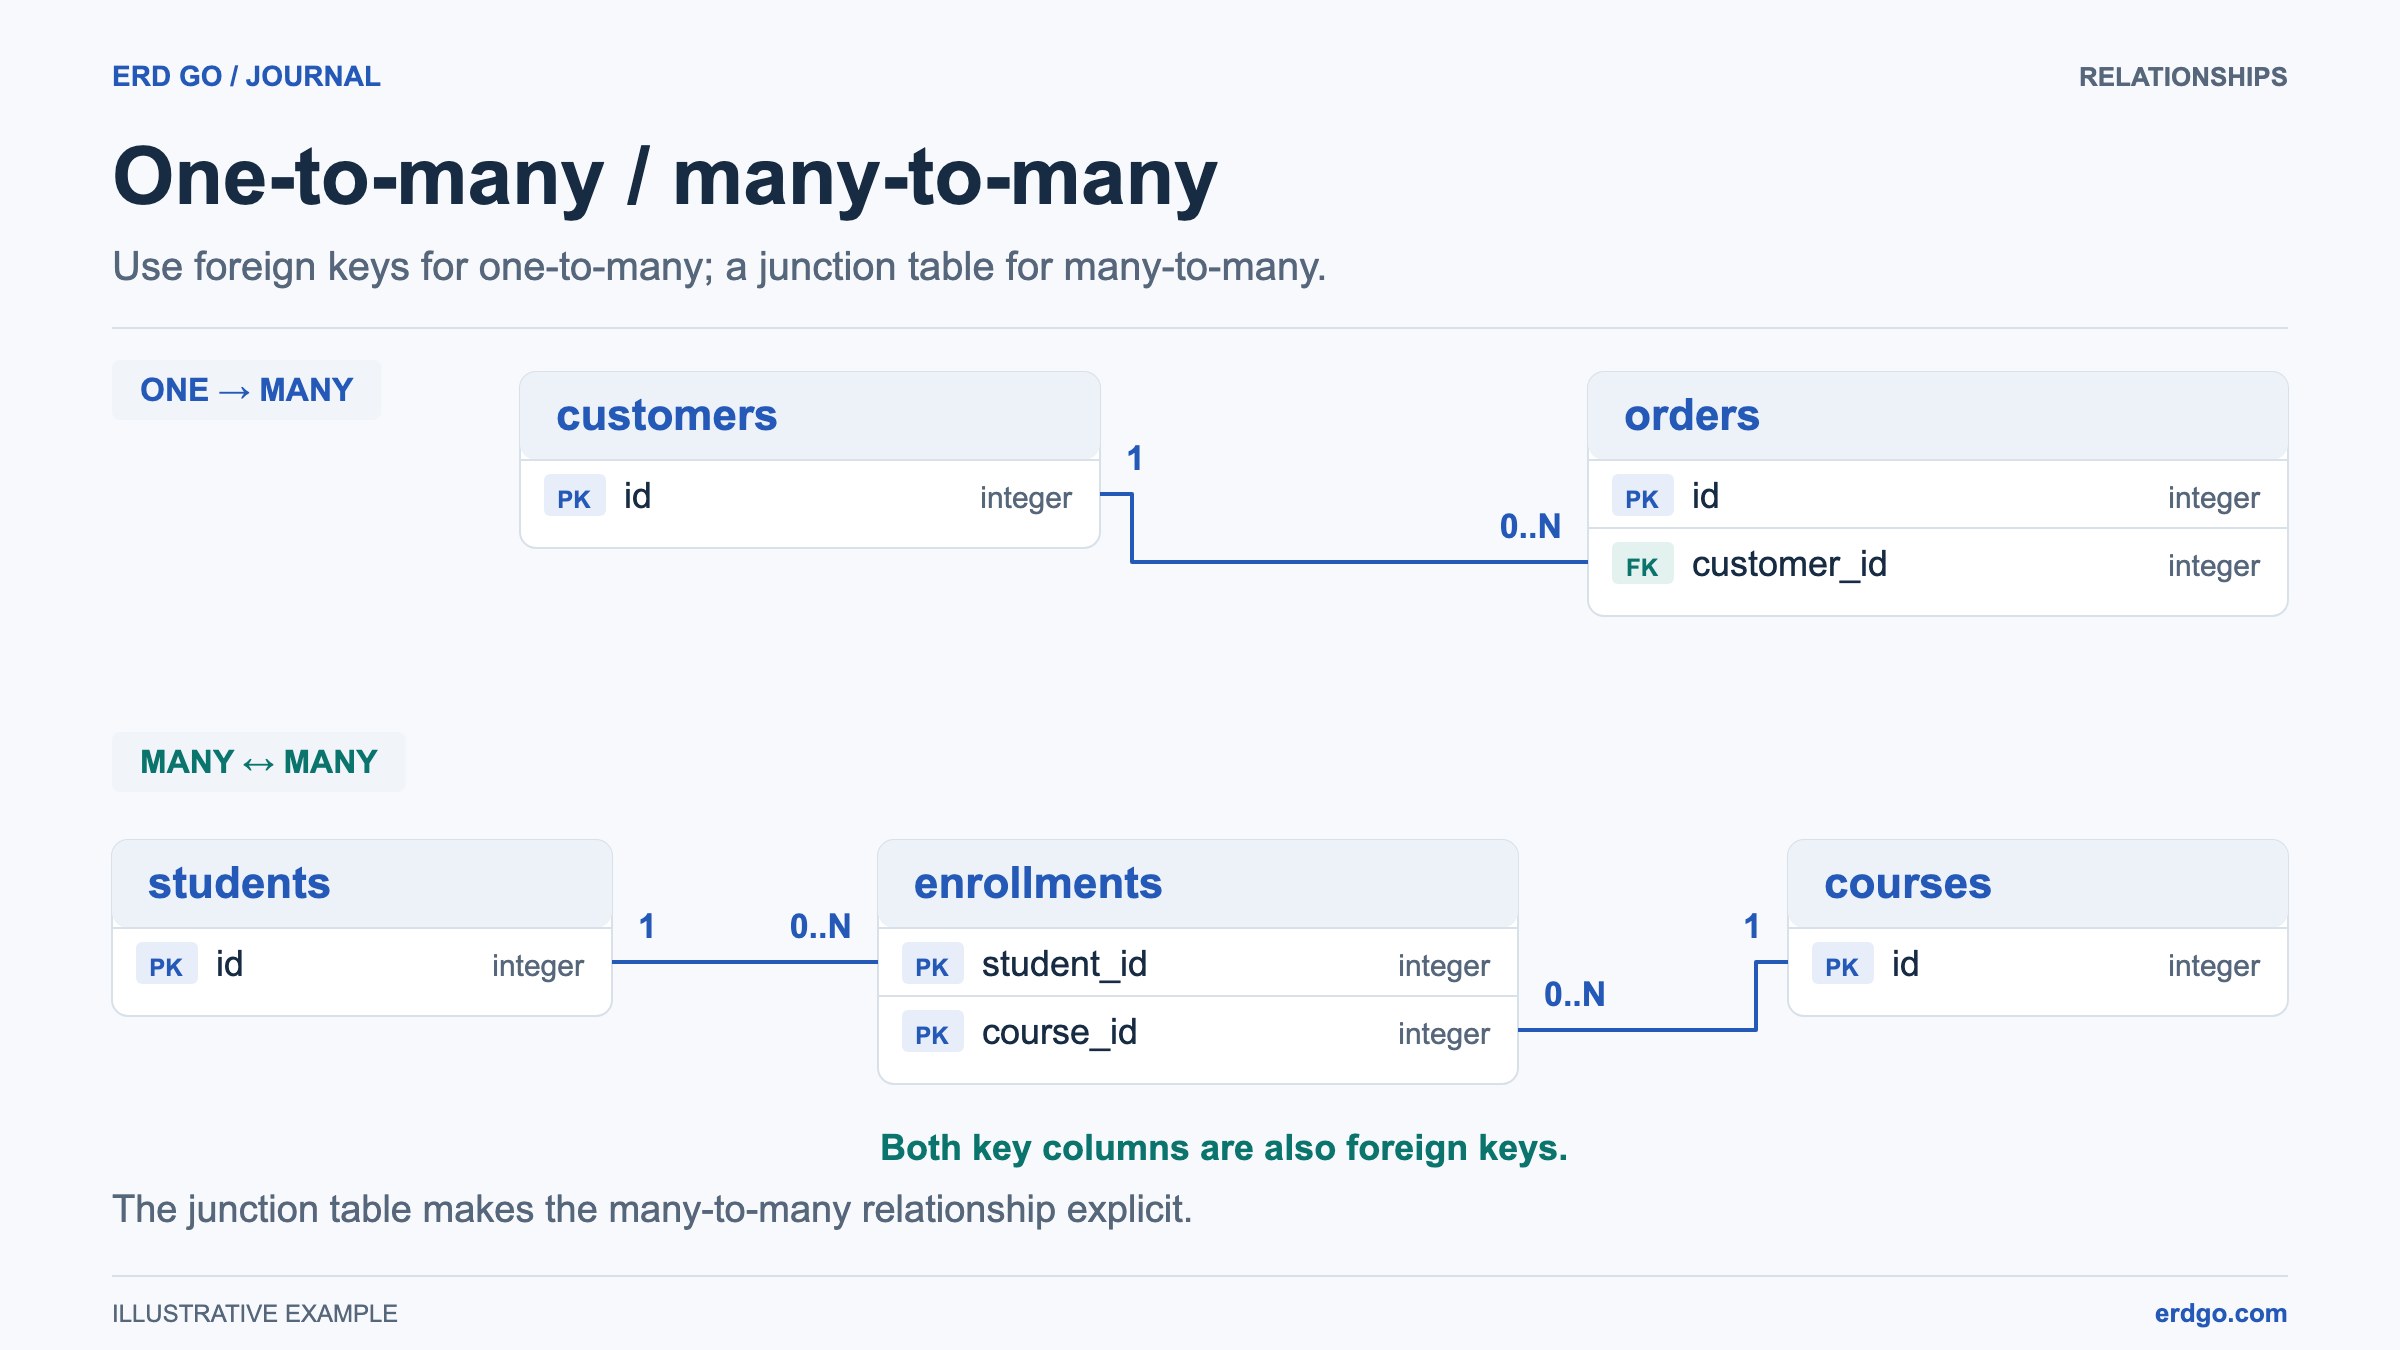
A veel-op-veel (M:N)-relatie bestaat wanneer rijen op beide zijden kunnen worden geassocieerd met meerdere rijen aan de andere kant. Relationele databases kunnen dit niet direct weergeven met een enkele vreemde sleutel, dus introduceren we een koppeltabel (ook wel een brug, join, of associatief tabel).
Klassiek voorbeeld: Studenten en Cursussen
Een student kan zich voor vele cursussen inschrijven en elke cursus kan vele studenten hebben. De koppeltabel enrollments zit ertussen en bevat de vreemde sleutels naar beide zijden.
CREATE TABLE students (
    id          SERIAL PRIMARY KEY,
    full_name   VARCHAR(120) NOT NULL,
    email       VARCHAR(255) UNIQUE NOT NULL,
    enrolled_on DATE DEFAULT CURRENT_DATE
);

CREATE TABLE courses (
    id          SERIAL PRIMARY KEY,
    title       VARCHAR(200) NOT NULL,
    credits     SMALLINT NOT NULL DEFAULT 3,
    department  VARCHAR(100)
);

CREATE TABLE enrollments (
    student_id  INT NOT NULL REFERENCES students (id) ON DELETE CASCADE,
    course_id   INT NOT NULL REFERENCES courses (id) ON DELETE CASCADE,
    enrolled_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    grade       CHAR(2),
    PRIMARY KEY (student_id, course_id)
);
Waarom een koppeltabel?
- De samengestelde primaire sleutel (
student_id, course_id) staat één rij per student-cursuspaar toe. Als herhaalde inschrijving per periode vereist is, neem dan een periode op in de bedrijfssleutel of modeleer elke inschrijving apart. - U kunt extra attributen koppelen aan de relatie zelf, zoals
gradeofenrolled_at, die bij geen enkele entiteit afzonderlijk horen. ON DELETE CASCADEop zowel vreemde sleutels betekent dat het verwijderen van een student of cursus automatisch de inschrijvingsrijen opschoont.
Veel-op-veelgegevens opvragen
-- All courses for a specific student
SELECT c.title, c.credits, e.grade
FROM enrollments e
JOIN courses c ON c.id = e.course_id
WHERE e.student_id = 42;

-- Students enrolled in 'Database Systems'
SELECT s.full_name, s.email
FROM enrollments e
JOIN students s ON s.id = e.student_id
JOIN courses c ON c.id = e.course_id
WHERE c.title = 'Database Systems';
Voorbeelden van veel-op-veel uit de echte wereld omvatten gebruikers ↔ rollen, producten ↔ tags, acteurs ↔ films, en bestellingen ↔ producten (via een order_items koppeltabel die ook hoeveelheid en prijs opslaat).
Eén-op-één-relaties
A een-op-een (1:1)-relatie betekent dat elke rij in Tabel A naar maximaal één rij in Tabel B verwijst, en vice versa. Dit patroon komt minder vaak voor, maar is nuttig om zelden geraadpleegde of gevoelige kolommen in een afzonderlijke tabel te plaatsen.
CREATE TABLE users (
    id          SERIAL PRIMARY KEY,
    username    VARCHAR(60) UNIQUE NOT NULL,
    email       VARCHAR(255) UNIQUE NOT NULL
);

CREATE TABLE user_profiles (
    user_id     INT PRIMARY KEY REFERENCES users (id) ON DELETE CASCADE,
    bio         TEXT,
    avatar_url  VARCHAR(500),
    birthdate   DATE,
    updated_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
Merk op dat user_profiles.user_id is zowel de primaire sleutel en de vreemde sleutel. Deze beperking dwingt de één-op-één-toewijzing af op databaseniveau: elke gebruiker kan maximaal één profielrij hebben.
Hoe relaties worden weergegeven in ERD's
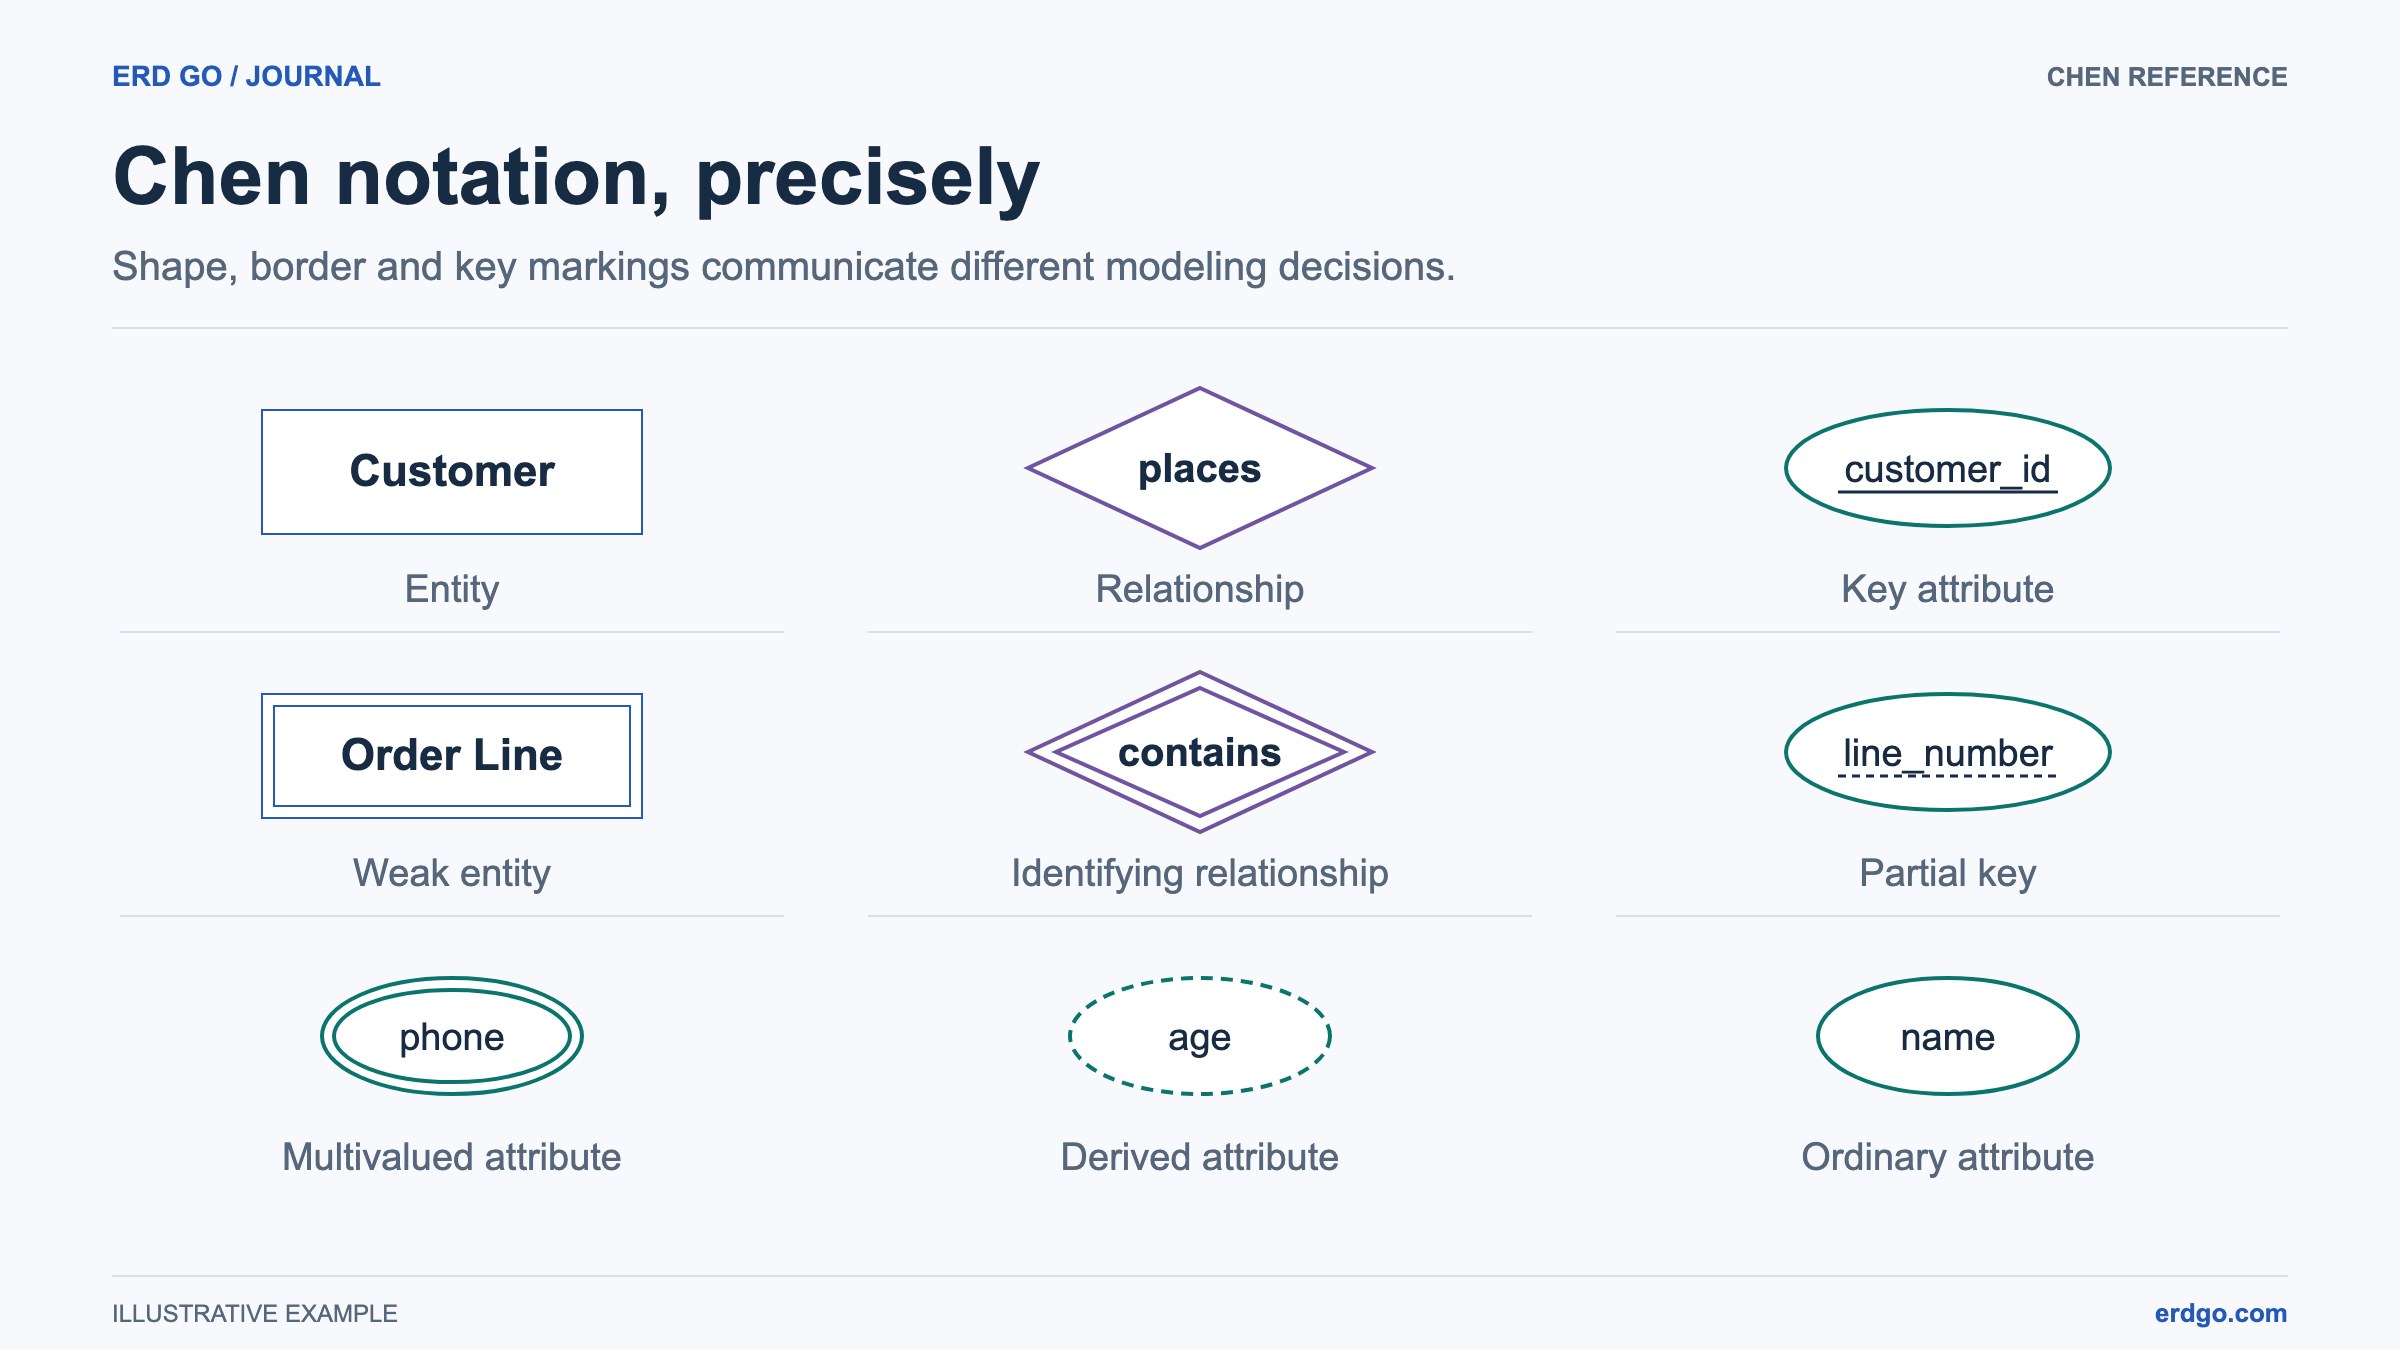
Een entiteit-relatiediagram gebruikt lijnen en symbolen tussen tabellen om cardinaliteit in één oogopslag over te brengen. De twee populairste notaties zijn Kraaienpoot (Crow’s Foot) en Chen notatie.
| Relatie | Kraaienpootsymbool (Crow’s Foot Symbol) | Hoe te lezen |
|---|---|---|
| Eén-op-één | ||—|| | Precies één aan elke kant |
| Eén-op-veel | ||—< | Één aan de linkerkant, vele aan de rechterkant (kraaienpoot-uiteinde) |
| Veel-op-veel | >—< | Veel aan beide kanten; geïmplementeerd via een koppeltabel |
Deze tekstsymbolen zijn een afkorting voor maximale cardinaliteit. Optionaliteit vereist een extra nul- of eenmarkering; een vreemde sleutel alleen vereist niet dat een ouder enige kinderen heeft.
Wanneer je een veel-op-veel-relatie modeleert in een ERD-tool, zie je typisch drie blokken: twee entiteitstabellen en de koppeltabel daartussen, elk verbonden door een één-op-veel-lijn.
Plak een van de SQL-voorbeelden uit dit artikel in de Erd Go-editor om het automatisch gegenereerde diagram te zien, compleet met foreign-key-pijlen en cardinaliteitsindicatoren.
Het juiste relatiepatroon kiezen
Het selecteren van de verkeerde cardinaliteit leidt tot gegevensduplicatie, complexe query's en integriteitsfouten. Gebruik dit beslissingskader:
- Kan één rij aan kant A relateren aan vele rijen aan kant B, maar niet omgekeerd? → Eén-op-veel. Plaats de vreemde sleutel aan kant B.
- Kunnen rijen aan beide kanten relateren aan vele rijen aan de andere kant? → Veel-op-veel. Maak een koppeltabel met samengestelde sleutel.
- Is de mapping strikt 1:1 en heeft u tabelscheiding nodig? → Eén-op-één. Gebruik dezelfde primaire sleutel als de vreemde sleutel.
Schets bij twijfel eerst je schema. Een snelle ERD toont relatieproblemen veel eerder dan dat je tegen constraintfouten in productie aanloopt. Probeer je diagram te bouwen in de Erd Go-editor— het duurt seconden en kan uren aan debugging besparen.