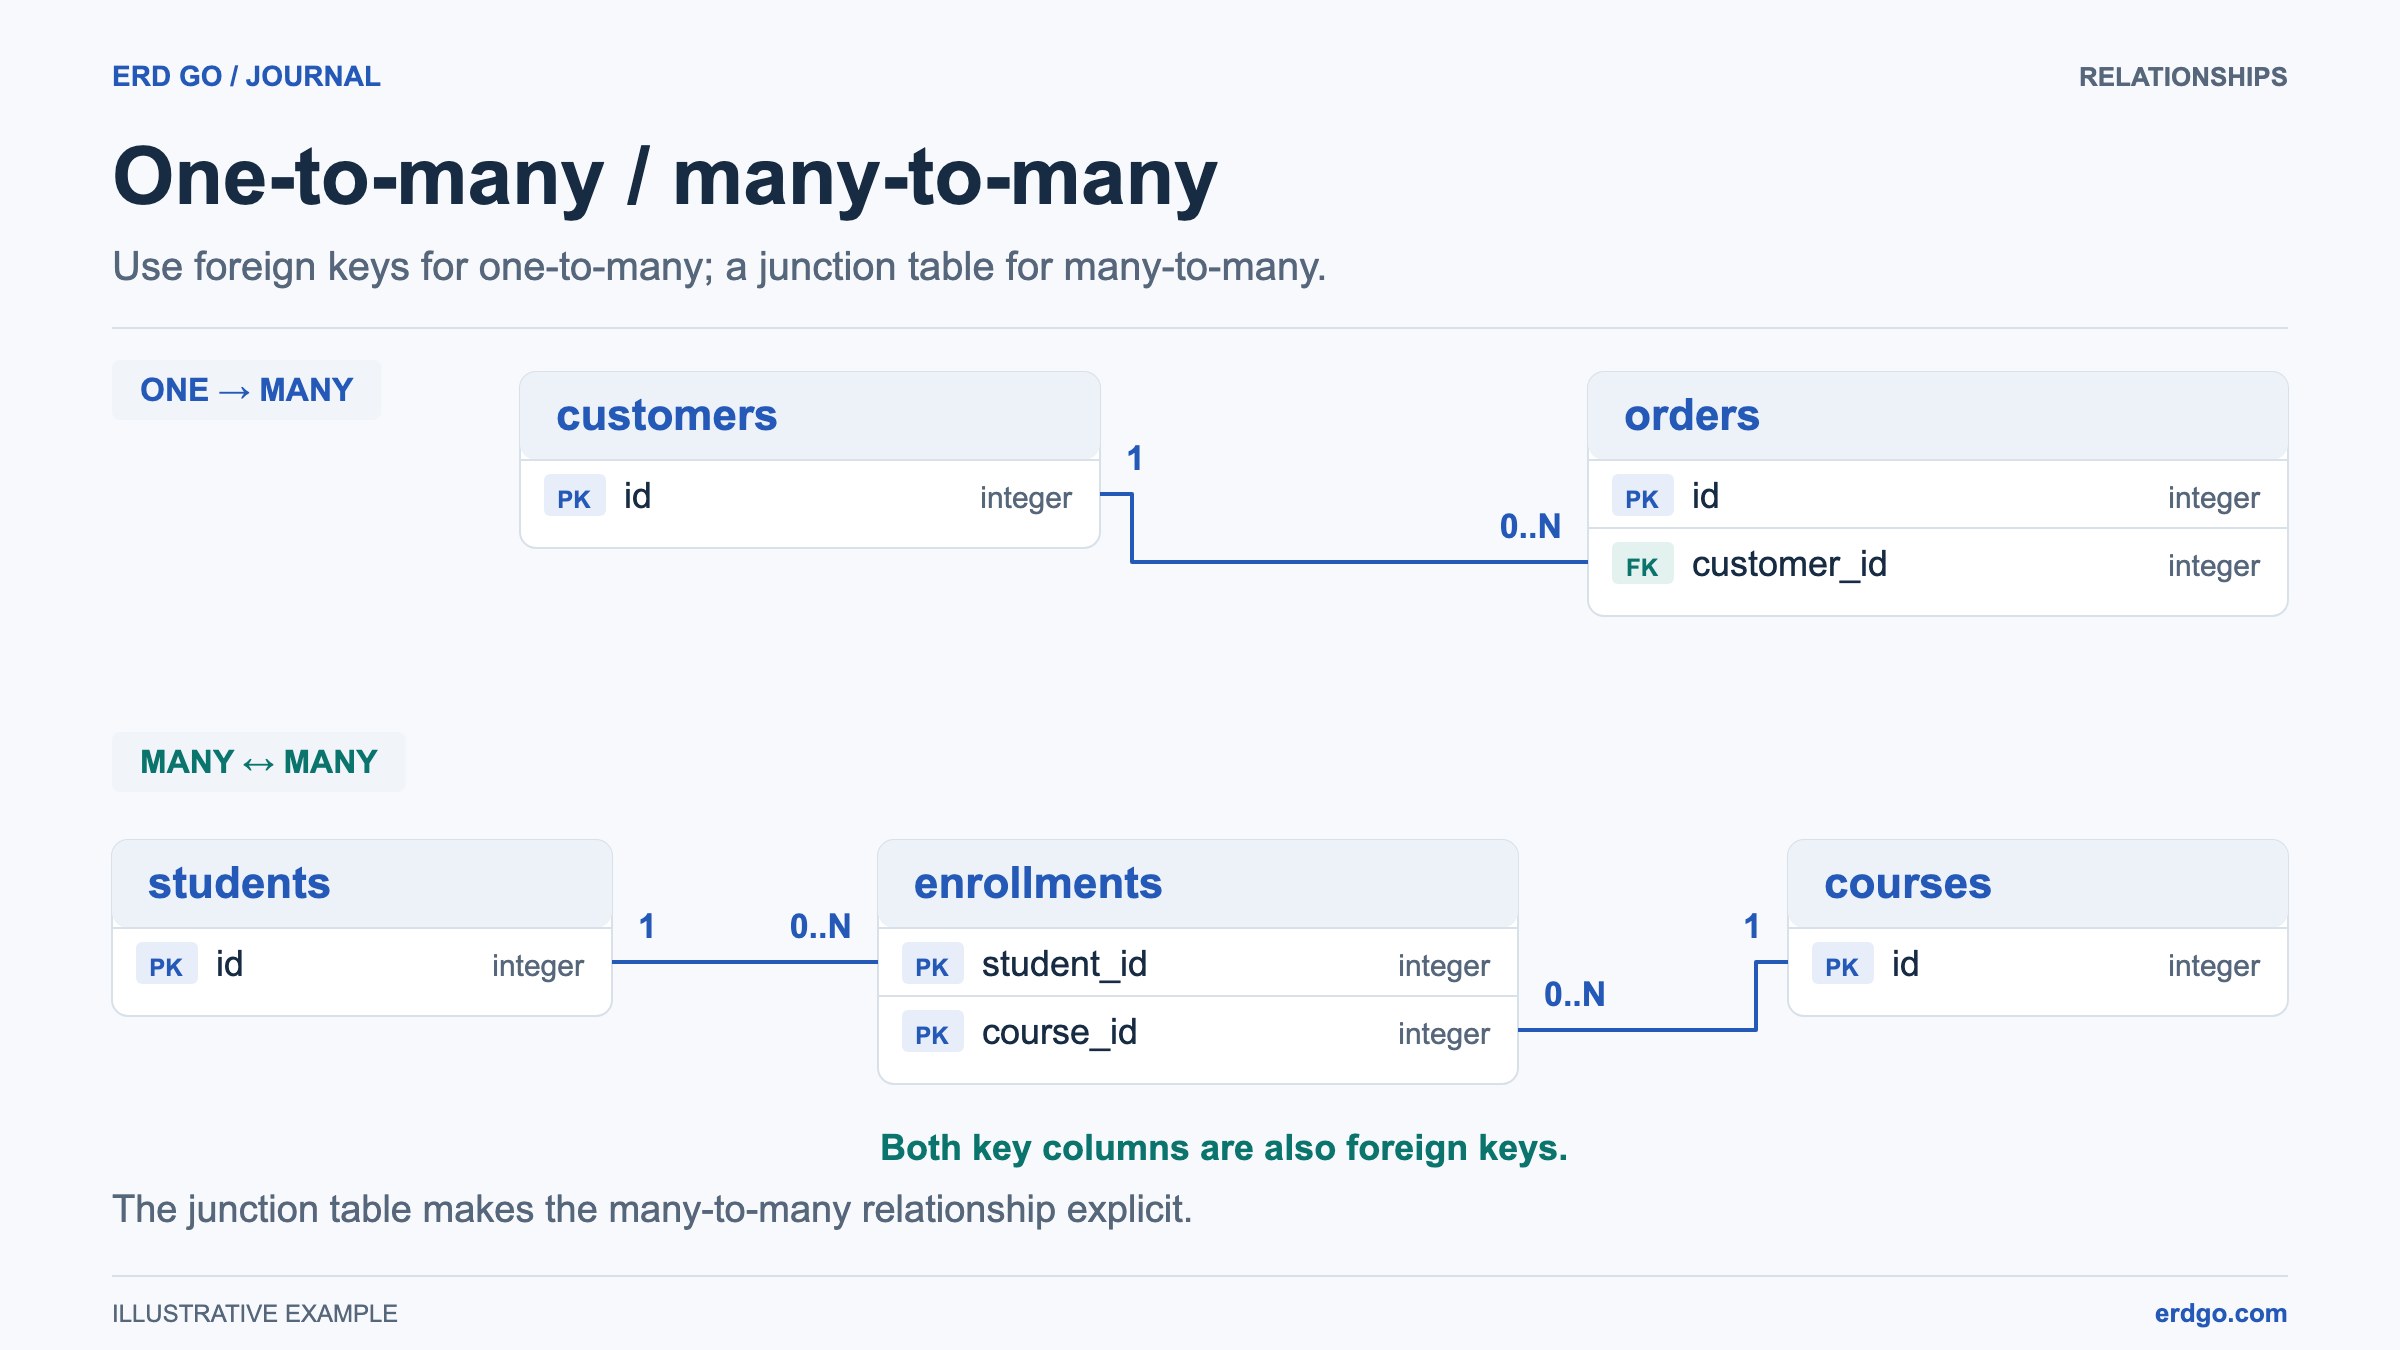
SQL-voorbeelden gebruiken PostgreSQL, tenzij een andere dialect wordt genoemd. Korte fragmenten gaan ervan uit dat hun verwijderde tabellen al bestaan. Valideer DDL in uw doeldatabase voordat u deze toepast.
Wat is Database-normalisatie?
Databasenormalisatie is het proces van het organiseren van een relationele database om gegevensredundantie te verminderen en de gegevensintegriteit te verbeteren. Normalisatie, geïntroduceerd door Edgar F. Codd in de jaren 70, houdt in dat grote tabellen worden opgedeeld in kleinere, gerelateerde tabellen en dat er relaties tussen worden gedefinieerd.
Het doel is om afhankelijkheden consistent weer te geven en onnodige duplicatie te verminderen. Historische momentopnamen, zoals een verkoopprijs, kunnen in een andere tabel horen omdat ze verschillende feiten vertegenwoordigen.
Waarom normaliseren?
- Redundantie elimineren — Vermijd het opslaan van dezelfde gegevens op meerdere plaatsen.
- Bijwerkanomalieën voorkomen — Wijzigingen in gegevens hoeven slechts op één plaats te gebeuren.
- Invoeganomalieën voorkomen — U kunt nieuwe gegevens toevoegen zonder gerelateerde gegevens te vereisen.
- Verwijderingsanomalieën voorkomen — Het verwijderen van een record verwijdert niet per ongeluk gerelateerde gegevens.
- Ondersteun onderhoudbare queries — Duidelijke afhankelijkheden maken query's gemakkelijker te begrijpen. Prestaties zijn afhankelijk van toegangspatronen, indexen en joins; normalisatie alleen maakt een query niet sneller.
Eerste normaalvorm (1NF)
Een tabel bevindt zich in 1NF wanneer:
- Elke kolom bevat alleen atomische (onverdeelbare) waarden
- Elke kolom bevat waarden van één enkel type
- Rijen zijn te onderscheiden door een kandidaatsleutel; declareer een primaire sleutel om een gekozen identifier af te dwingen in SQL
- Er zijn geen herhalende groepen of arrays
Vóór 1NF (schending)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
Na 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
Tweede Normaalvorm (2NF)
Een tabel bevindt zich in 2NF wanneer:
- Het is al in 1NF
- Elk niet-primair attribuut hangt af van elk gehele kandidaatsleutel, zonder afhankelijkheid van slechts een deel van een sleutel
Een kandidaatsleutel is een minimale set attributen die een rij uniek identificeert. Attributen die in een kandidaatsleutel voorkomen, zijn priemattributen. Partiële afhankelijkheden spelen een rol wanneer een kandidaatsleutel meerdere kolommen bevat; kandidaatsleutels omvatten alternatieve unieke identificatoren, niet alleen de gekozen primaire sleutel. Als een niet-sleutelkolom van slechts een deel van de sleutel afhangt, moet deze naar een aparte tabel worden verplaatst.
Vóór 2NF (schending)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
Na 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Derde Normale Vorm (3NF)
Een tabel bevindt zich in 3NF wanneer:
- Het is al in 2NF
- Voor elke niet-triviale functionele afhankelijkheid X → A is X een supersleutel of behoort A tot een kandidaatsleutel. In de onderstaande voorbeelden verwijdert dit transitieve afhankelijkheden tussen niet-sleutelattributen.
Vóór 3NF (schending)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
Na 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Een volledig genormaliseerd voorbeeld
Hier is een e-commerce-schema dat producten, klanten, adressen, bestellingen en bestelregels scheidt. Ervan uitgaande dat elke vermelde identifier de resterende attributen bepaalt, voldoen deze tabellen aan de geïllustreerde normaalvormen. Opgeslagen verkooprijzen zijn historische feiten, geen kopieën van de huidige productprijs.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Plak dit in De editor van Erd Go om de visuele ERD te zien met alle automatisch gemapte relaties.
Wanneer te denormaliseren
Hoewel normalisatie over het algemeen een goede praktijk is, zijn er gevallen waarin denormalisatie de prestaties verbetert:
- Leesintensieve workloads — Als uw applicatie veel meer leest dan schrijft, kan het opslaan van berekende of gedupliceerde gegevens dure JOINs vermijden.
- Rapportage en analyse — Gedenormaliseerde tabellen of gematerialiseerde weergaven worden vaak gebruikt voor dashboards.
- Hete gegevens cachen — Opslaan van frequent toegankelijke geaggregeerde waarden direct in een tabel.
- NoSQL-stijl toegangspatronen — Wanneer uw query's altijd een specifieke combinatie van gegevens nodig hebben.
De sleutel is om normaliseer eerst, denormaliseer dan bewust waar prestaties dit vereisen, met documentatie waarom de afweging is gemaakt.