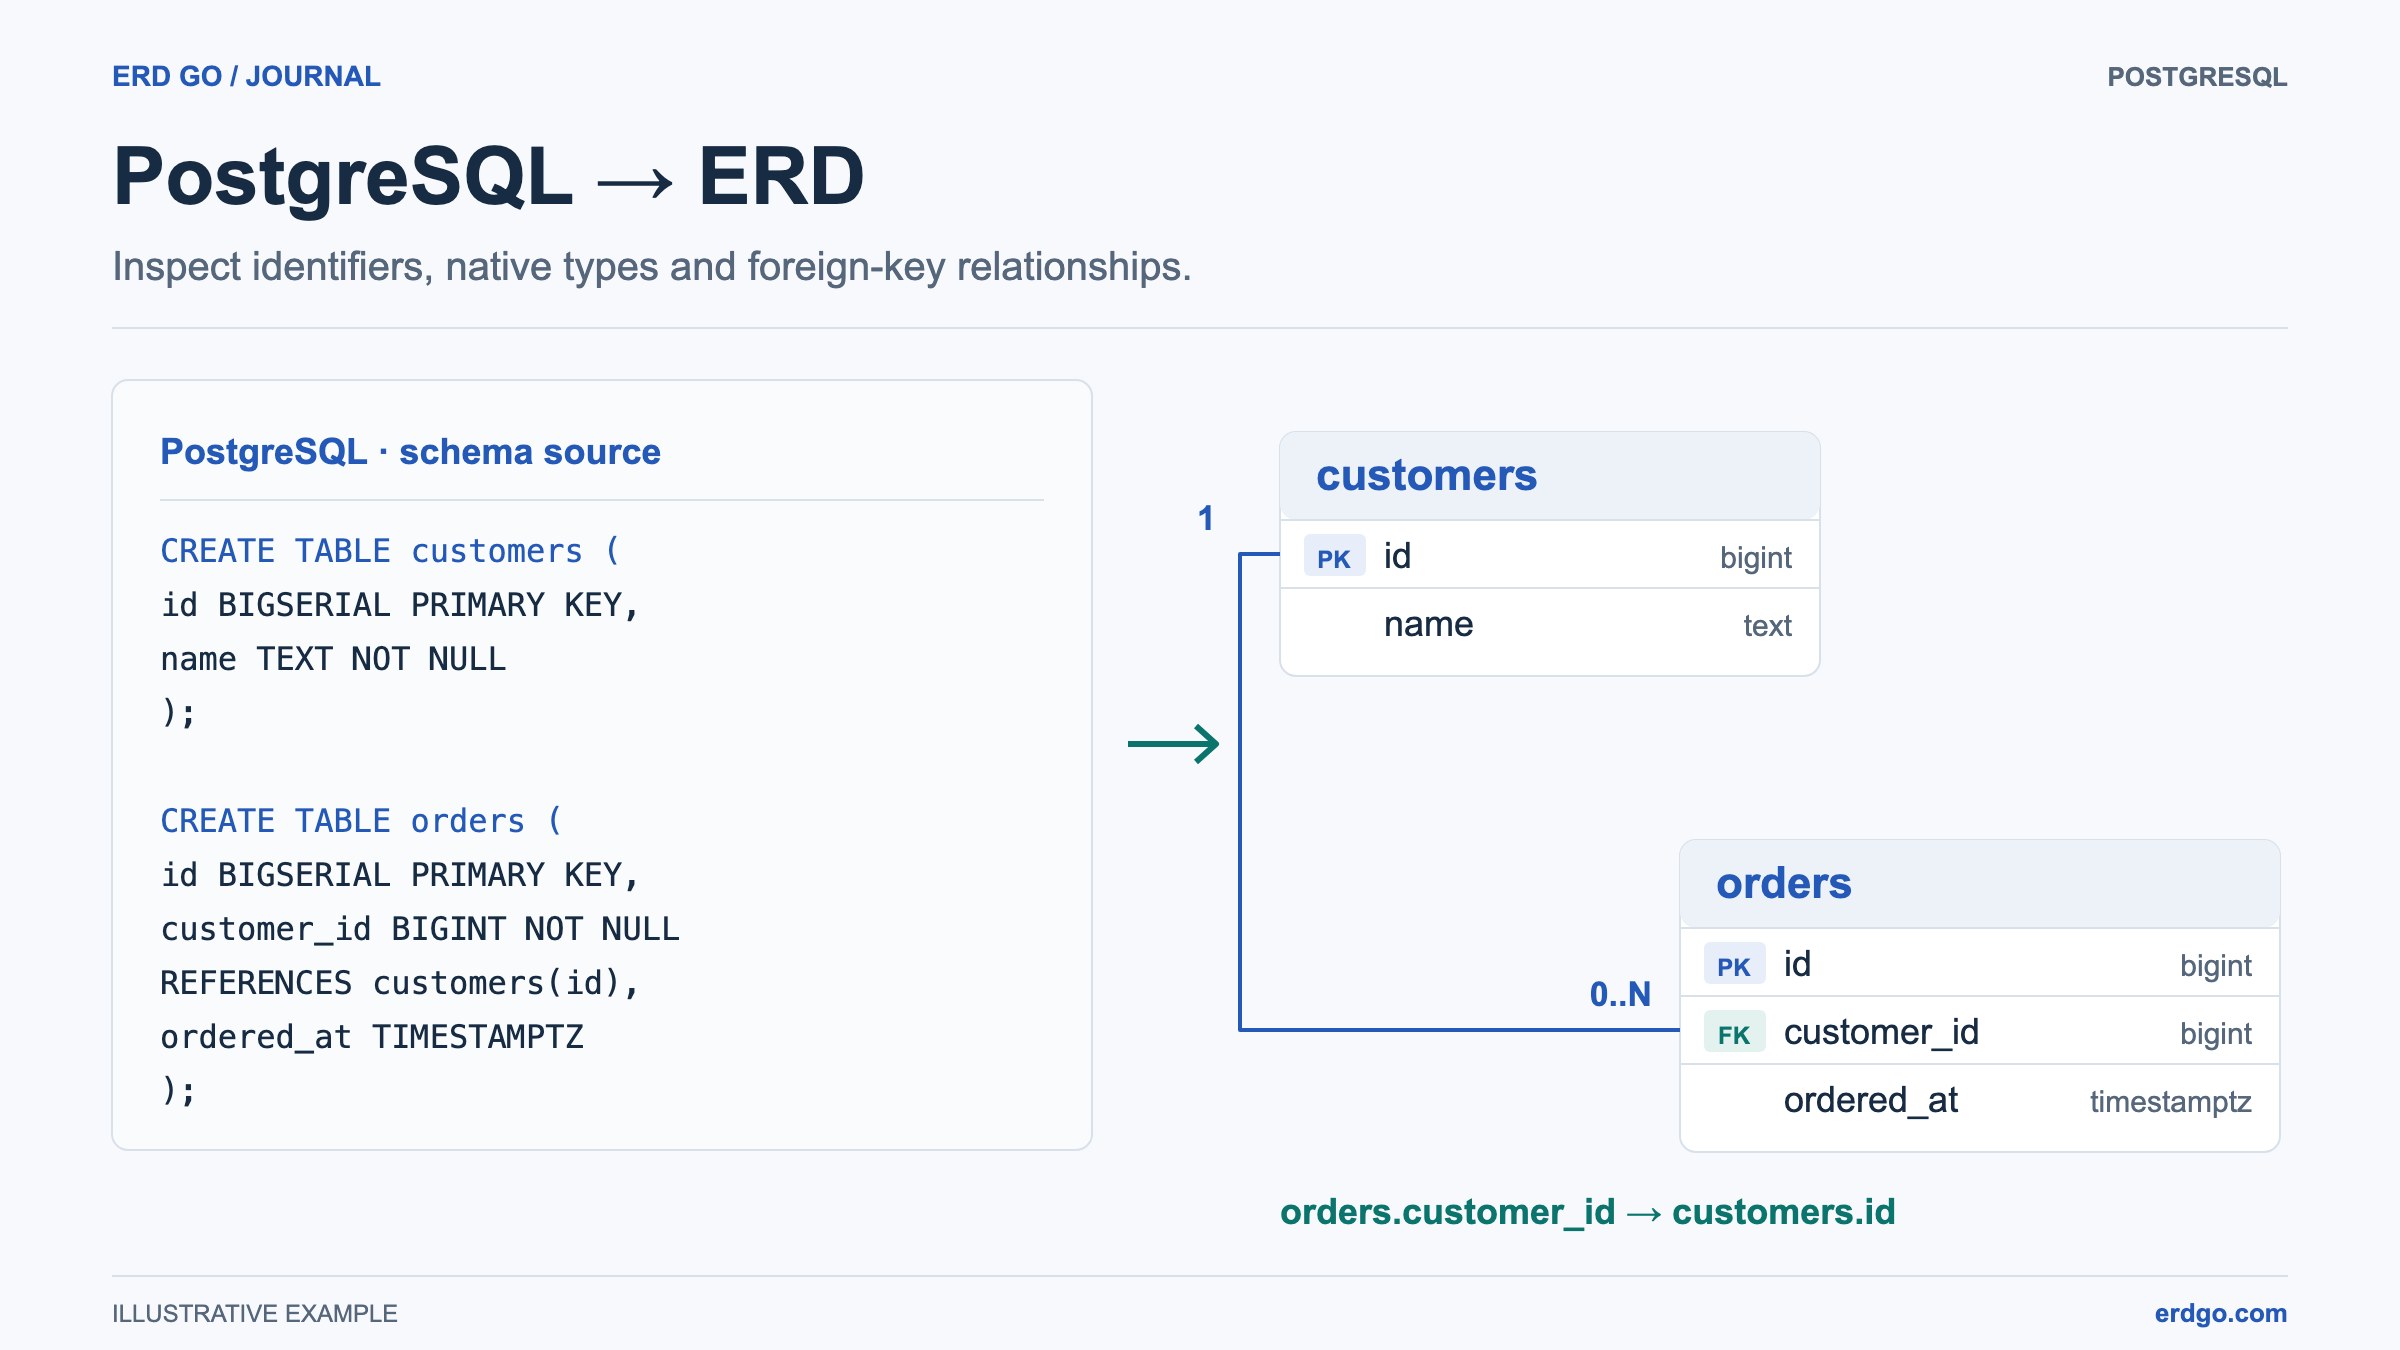
SQL-voorbeelden gebruiken PostgreSQL, tenzij een andere dialect wordt genoemd. Korte fragmenten gaan ervan uit dat hun verwijderde tabellen al bestaan. Valideer DDL in uw doeldatabase voordat u deze toepast.
Waarom je SQL-schema visualiseren?
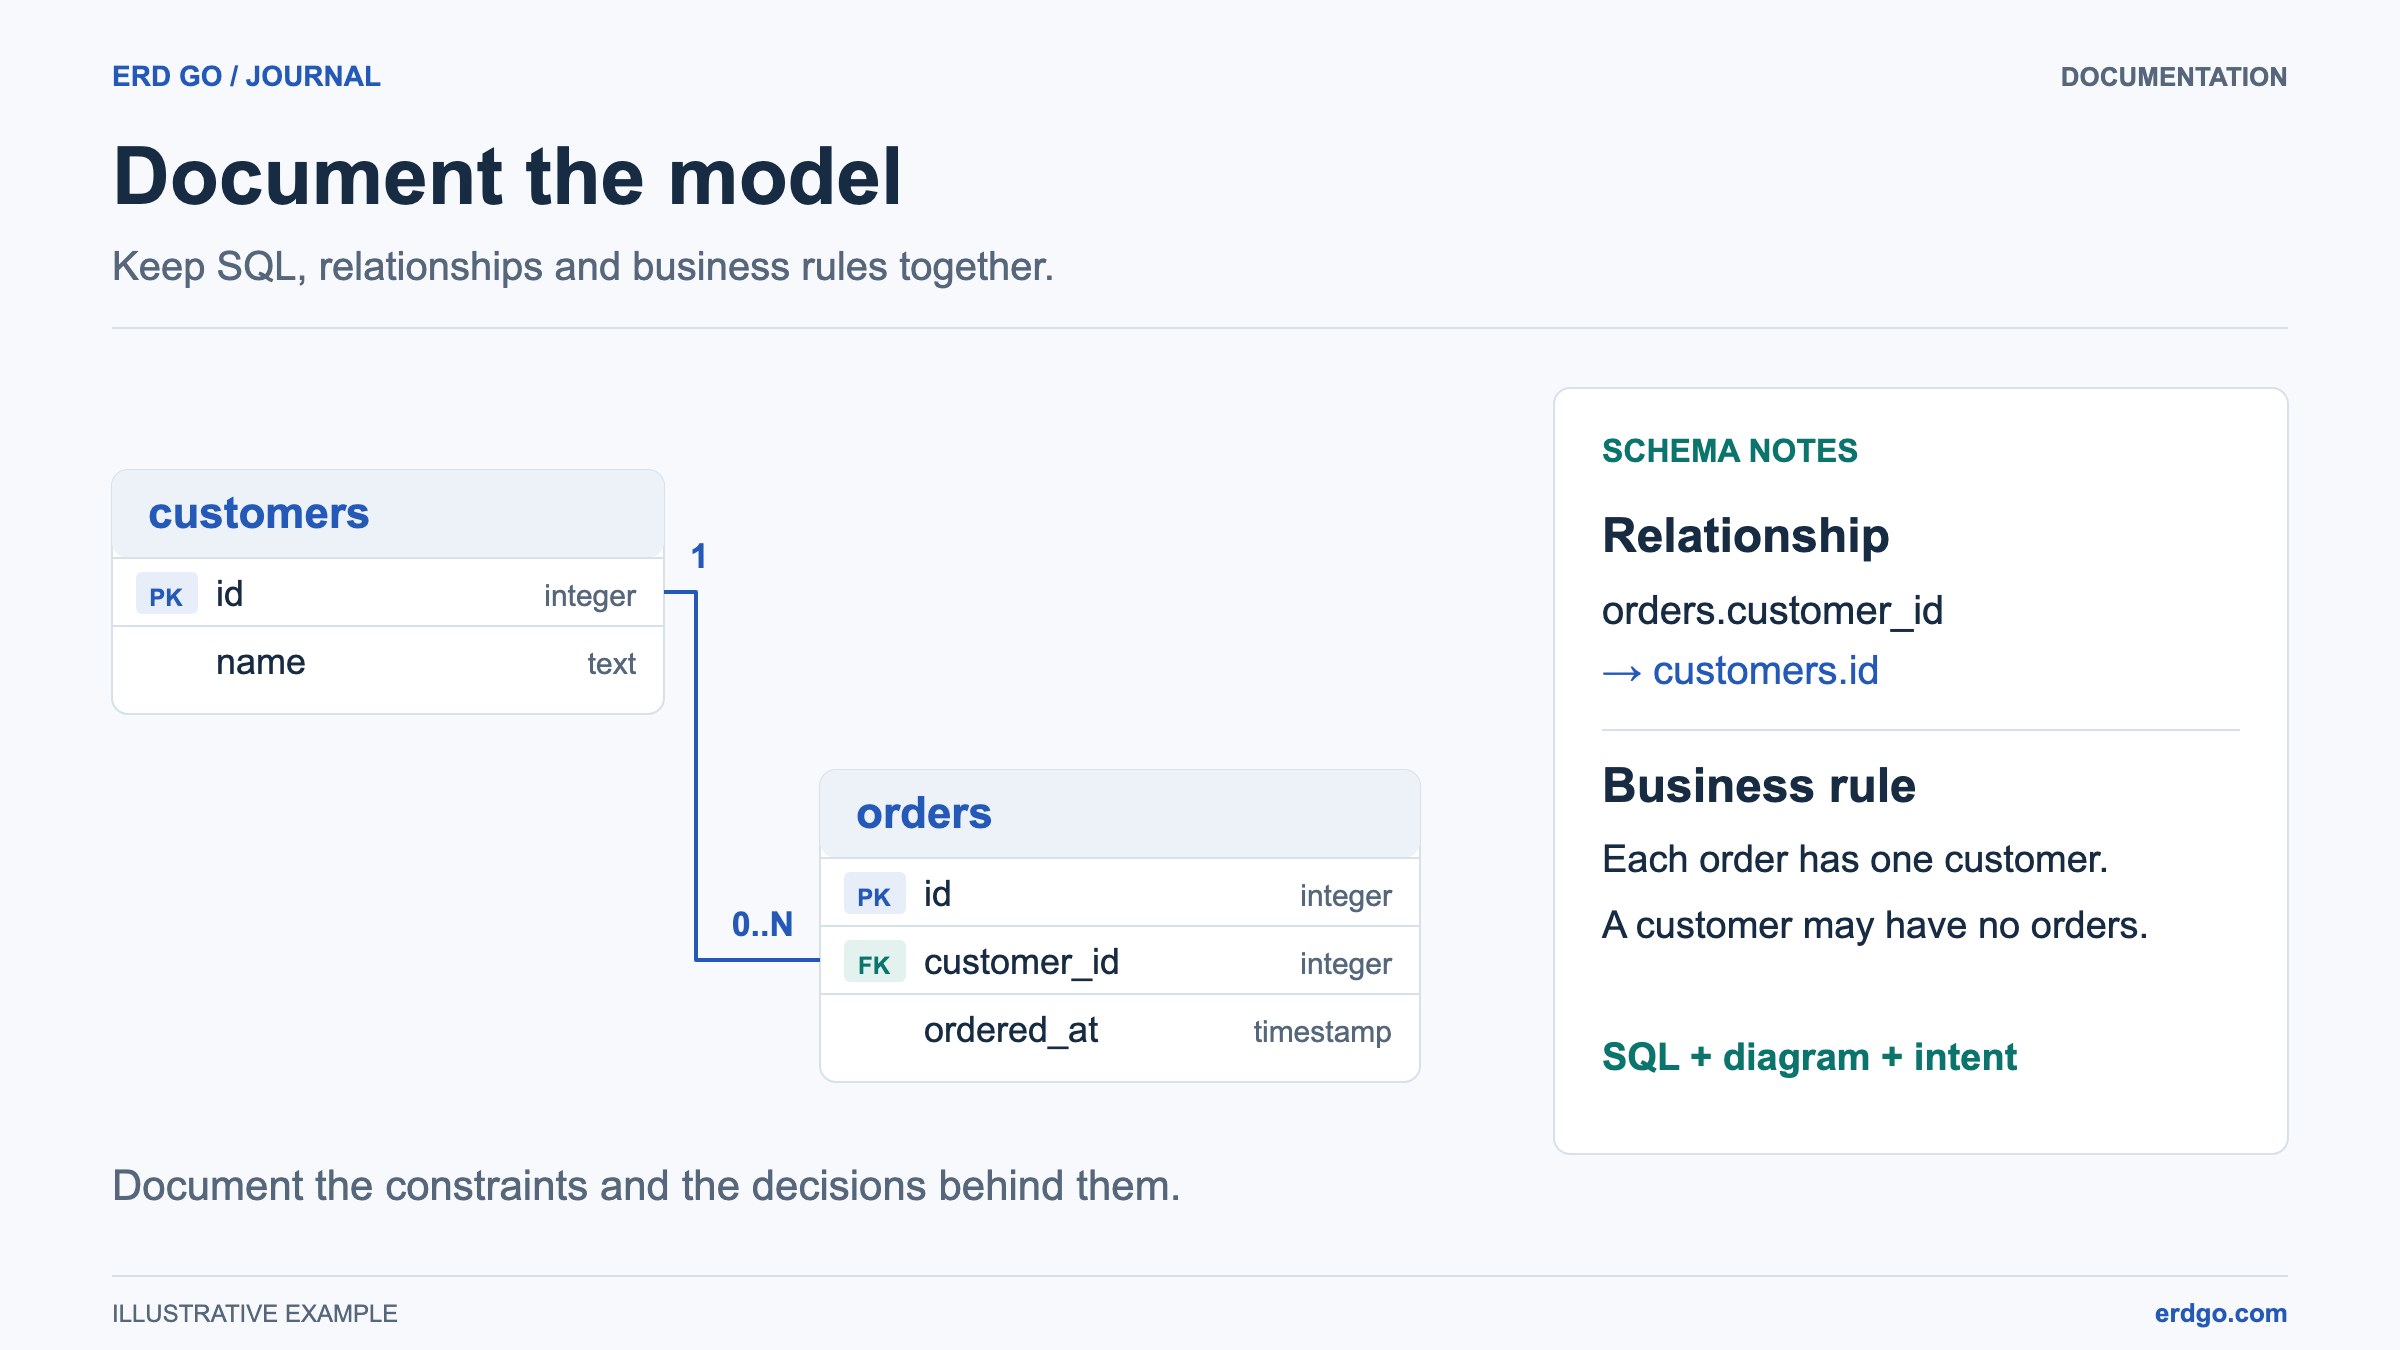
Een goed gestructureerde database kan tientallen of zelfs honderden tabellen bevatten, elk gekoppeld via vreemde sleutels (foreign keys), beperkingen (constraints) en indexen. Het lezen van ruwe CREATE TABLE statements vertellen slechts een deel van het verhaal. Een Entiteit-relatiediagram (ERD) zet die SQL om in een visuele kaart, waardoor het veel eenvoudiger wordt om:
- Ontdek ontbrekende of onjuiste foreign-key relaties in één oogopslag.
- Nieuwe teamleden inwerken die het datamodel snel moeten begrijpen.
- Communiceer schemabeslissingen bij pull-requestbeoordelingen, architectuurdocumenten en belanghebbendenvergaderingen.
- Detecteer normalisatieproblemen zoals redundante kolommen of circulaire verwijzingen.
- Plan migrations en refactors door de volledige afhankelijkheidsgraaf te bekijken.
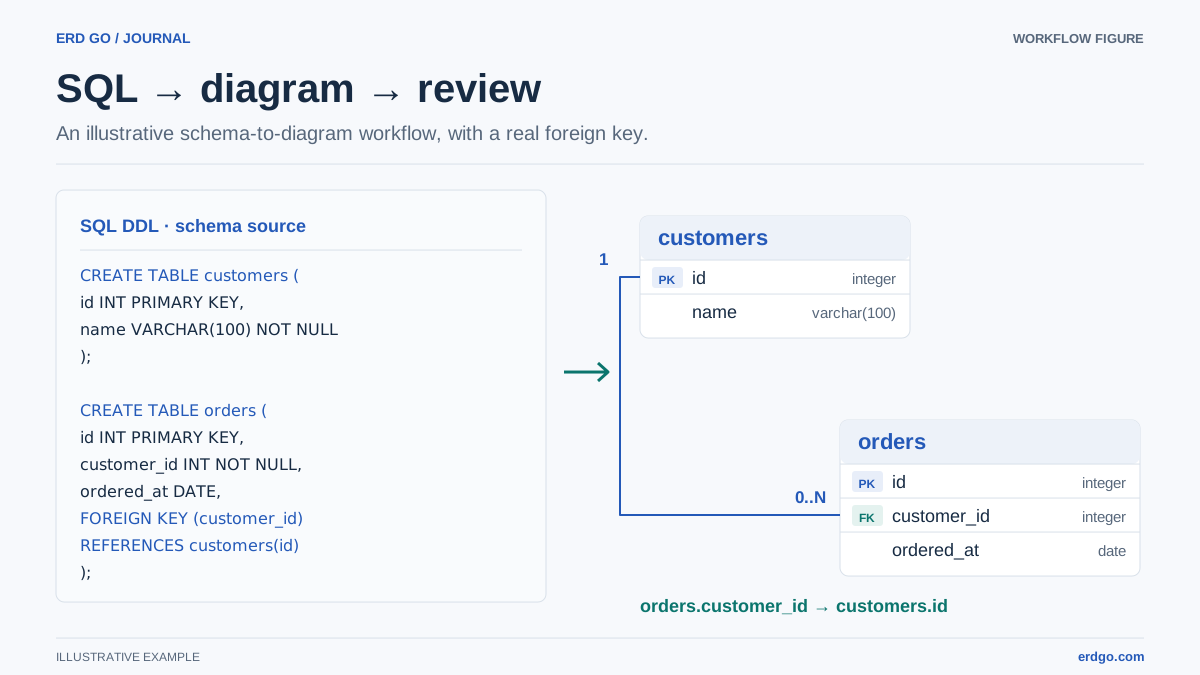
De snelste manier om van SQL naar diagram te gaan is door een automatische ERD-generator te gebruiken. Met de Erd Go-editor, plakt u eenvoudig uw SQL en ontvangt u binnen enkele seconden een interactief, bewerkbaar diagram—handmatig tekenen is niet nodig.
Handmatige versus automatische ERD-generatie
Er zijn twee brede benaderingen om een ERD te maken van een bestaand schema, en het begrijpen van de afwegingen helpt u bij het kiezen van het juiste hulpmiddel voor de klus.
Handmatig diagrammen maken
- U tekent elke tabelbox handmatig in een tool zoals Lucidchart, draw.io, of zelfs een whiteboard.
- Volledige creatieve controle over lay-out en visuele stijl.
- Nadelen: extreem tijdrovend voor grote schema's, gemakkelijk om discrepanties te introduceren tussen het diagram en de daadwerkelijke database, en u moet de tekening bijwerken elke keer dat het schema verandert.
Automatische generatie
- Een hulpmiddel ontleedt uw SQL DDL (Data Definition Language) en bouwt programmatisch het diagram.
- Leidt het diagram af van ondersteunde SQL-definities. Controleer parserwaarschuwingen en ontbrekende verwijzingen; geautomatiseerde parsing bewijst niet dat de SQL of bedrijfsregels juist zijn.
- Opnieuw genereren na een migratie kost seconden in plaats van een handmatige bewerkingssessie.
- Nadelen: automatische lay-out ziet er mogelijk niet meteen perfect uit, dus u moet soms tabellen naar een schonere rangschikking slepen.
Voor de meeste teams, automatische generatie met lichte handmatige aanpassingen is de ideale workflow. U krijgt snelheid en nauwkeurigheid.
Stap-voor-stap: Genereer een ERD met Erd Go
Volg deze stappen om een ondersteund SQL-schema om te zetten in een leesbaar ERD. Grote schema's en onvolledige dumps moeten mogelijk worden opgeschoond voor beoordeling.
Stap 1 — Open de Editor
Navigeer naar de Erd Go-editor. Kies een leeg SQL-bestand of een startervoorbeeld. De werkruimte biedt een SQL-paneel en een diagramcanvas; op kleinere schermen kunt u naar wens schakelen tussen weergaven.
Stap 2 — Plak Uw SQL
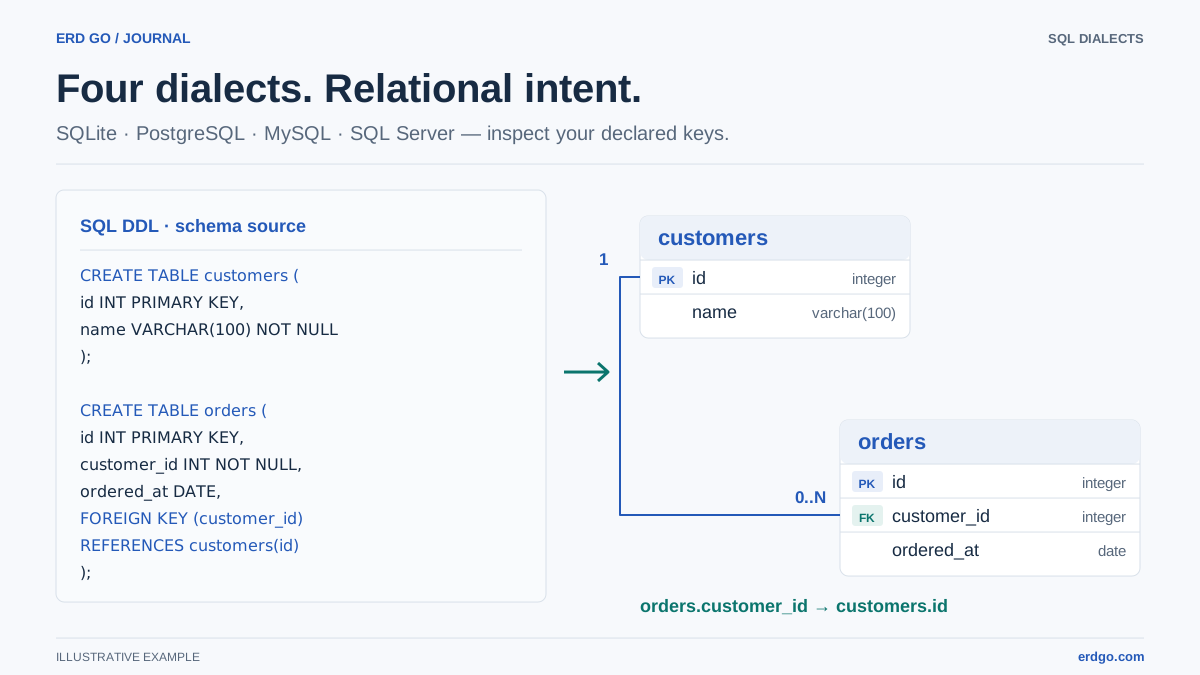
Kopieer je CREATE TABLE statements (inclusief vreemde sleutels) en plak ze in het SQL-paneel. Erd Go ondersteunt standaard SQL-syntaxis van PostgreSQL, MySQL, SQLite en SQL Server.
Stap 3 — Zie de Diagram Verschijnen
De editor parseert uw DDL in realtime en rendert tabelboxen met kolommen, gegevenstypen, primaire sleutels en foreign-key pijlen. Relaties worden automatisch gedetecteerd uit FOREIGN KEY en REFERENCES clausules.
Stap 4 — Verfijn de Indeling
Sleep tabellen om ze te verplaatsen. Groepeer gerelateerde entiteiten samen voor duidelijkheid. De editor behoudt posities voor overeenkomstige tabellen terwijl u het huidige document bewerkt. Het hernoemen of vervangen van tabellen kan een nieuwe lay-outcontrole vereisen; sla het document op om dit te bewaren voor een latere sessie.
Stap 5 — Exporteren of Delen
Exporteer een PNG, SVG of PDF voor documentatie en presentaties. Om een alleen-lezen openbare link te delen, meldt u zich aan en slaat u het document eerst op; controleer gevoelige schemadetails voordat u het openbaar maakt.
Ondersteunde SQL Functies
De parser van Erd Go verwerkt een breed scala aan DDL-constructies, maar de dekking is niet identiek aan die van een databaseserver. Raadpleeg de ondersteunde syntaxis en beperkingen en bekijk diagnostiek bij het importeren van een dump.
| SQL-functie | Voorbeeld | Hoe het wordt weergegeven in ERD |
|---|---|---|
CREATE TABLE | CREATE TABLE users (...); | Weergegeven als een tabelvak met kolomlijst |
PRIMARY KEY | id SERIAL PRIMARY KEY | Kolom gemarkeerd met een sleutelpictogram |
FOREIGN KEY / REFERENCES | REFERENCES users (id) | Pijl getrokken tussen de twee tabellen |
ENUM types | CREATE TYPE status AS ENUM (...); | Weergegeven als een aangepast type in de kolomdefinitie |
ALTER TABLE | ALTER TABLE orders ADD COLUMN ...; | Kolom toegevoegd aan het bestaande tabelvak |
UNIQUE / NOT NULL | email VARCHAR(255) UNIQUE NOT NULL | Beperkingsbadges weergegeven op de kolom |
DEFAULT values | created_at TIMESTAMP DEFAULT NOW() | Standaardwaarde behouden in schemametagegevens en SQL; inspecteer de kolongegevens |
Een compleet voorbeeld: E-commerceschema
Kopieer de onderstaande SQL en plak deze rechtstreeks in de Erd Go-editor om een volledig gerenderde e-commerce ERD te zien.
-- Enum for order status
CREATE TYPE order_status AS ENUM (
    'pending', 'processing', 'shipped', 'delivered', 'cancelled'
);

CREATE TABLE customers (
    id          SERIAL PRIMARY KEY,
    full_name   VARCHAR(120) NOT NULL,
    email       VARCHAR(255) UNIQUE NOT NULL,
    phone       VARCHAR(20),
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE categories (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(100) NOT NULL,
    slug        VARCHAR(100) UNIQUE NOT NULL,
    parent_id   INT REFERENCES categories (id)
);

CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    description TEXT,
    price       NUMERIC(10, 2) NOT NULL CHECK (price > 0),
    category_id INT REFERENCES categories (id),
    sku         VARCHAR(50) UNIQUE,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE orders (
    id          SERIAL PRIMARY KEY,
    customer_id INT NOT NULL REFERENCES customers (id),
    status      order_status DEFAULT 'pending',
    total       NUMERIC(12, 2) NOT NULL DEFAULT 0,
    ordered_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE order_items (
    order_id    INT NOT NULL REFERENCES orders (id) ON DELETE CASCADE,
    product_id  INT NOT NULL REFERENCES products (id),
    quantity    SMALLINT NOT NULL DEFAULT 1 CHECK (quantity > 0),
    unit_price  NUMERIC(10, 2) NOT NULL,
    PRIMARY KEY (order_id, product_id)
);

ALTER TABLE products ADD COLUMN stock INT NOT NULL DEFAULT 0;
Dit schema demonstreert verschillende patronen tegelijk: één-op-veel ("customers → orders), veel-op-veel (orders ↔ products via order_items), een naar zichzelf verwijzende vreemde sleutel (categories.parent_id), een ENUM type, CHECK constraints, en een ALTER TABLE statement. De Erd Go-editor verwerkt ze allemaal.
Tips voor Schone, Leesbare ERD's
Zelfs met automatische generatie maken een paar best practices uw diagrammen een stuk nuttiger:
- Gebruik consistente naamgevingsconventies. Houd je aan
snake_casevoor tabellen en kolommen. Benoem koppeltabellen naar de twee entiteiten die ze koppelen (bijv.order_items,student_courses). - Groepeer gerelateerde tabellen visueel. Plaats de
users,roles, enpermissionstabellen dicht bij elkaar, weg van niet-gerelateerde producttabellen. - Minimaliseer kruisende lijnen. Schik tabellen zo dat foreign key-pijlen in dezelfde algemene richting stromen (van boven naar beneden of van links naar rechts).
- Markeer belangrijke entiteiten. Plaats je belangrijkste tabellen (bijv.
users,orders) in het midden van het diagram. - Genereer opnieuw na migraties. Behandel uw ERD als een levend document. Plak na elke schemawijziging de bijgewerkte SQL opnieuw in de Erd Go-editor om het diagram gesynchroniseerd te houden.