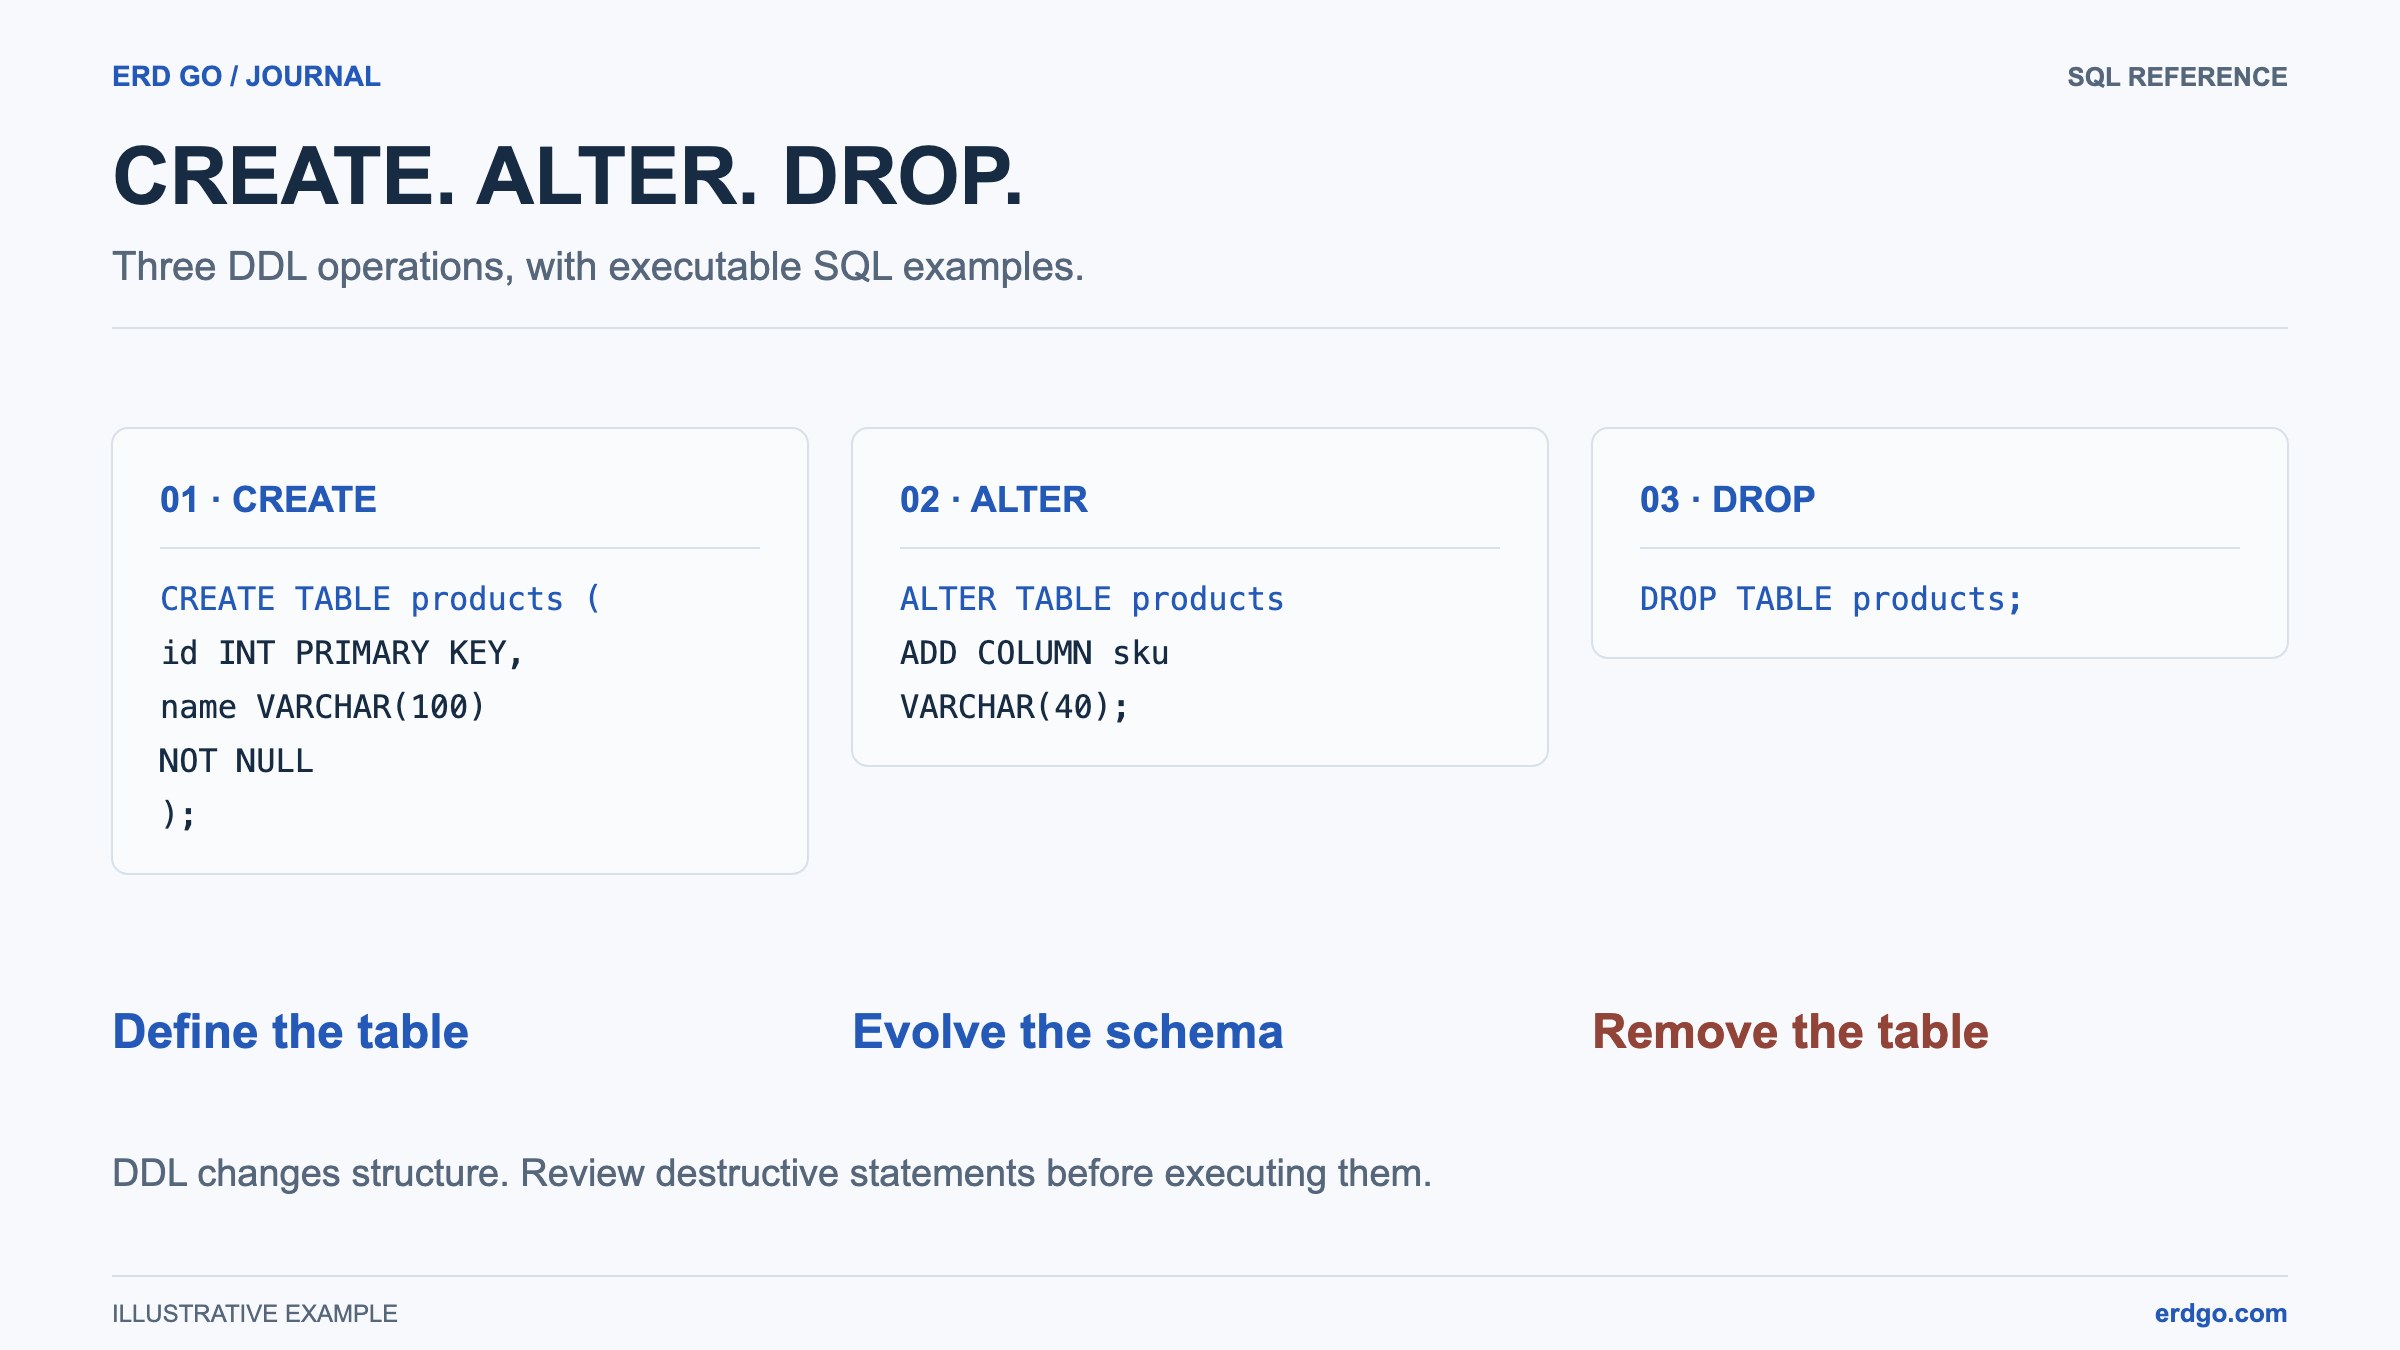
SQL-voorbeelden gebruiken PostgreSQL, tenzij een andere dialect wordt genoemd. Korte fragmenten gaan ervan uit dat hun verwijderde tabellen al bestaan. Valideer DDL in uw doeldatabase voordat u deze toepast.
Waarom PostgreSQL-schema's goede diagrammen nodig hebben
PostgreSQL-schema's bevatten vaak meer dan eenvoudige tabellen. Echte projecten gebruiken ENUM typen, identity columns, schema-gekwalificeerde namen, JSON-velden, array-typen, samengestelde sleutels, gegenereerde kolommen, partiële indexen en foreign keys met cascade-regels. Een diagram helpt het team al die structuur sneller te begrijpen dan DDL regel voor regel te lezen.
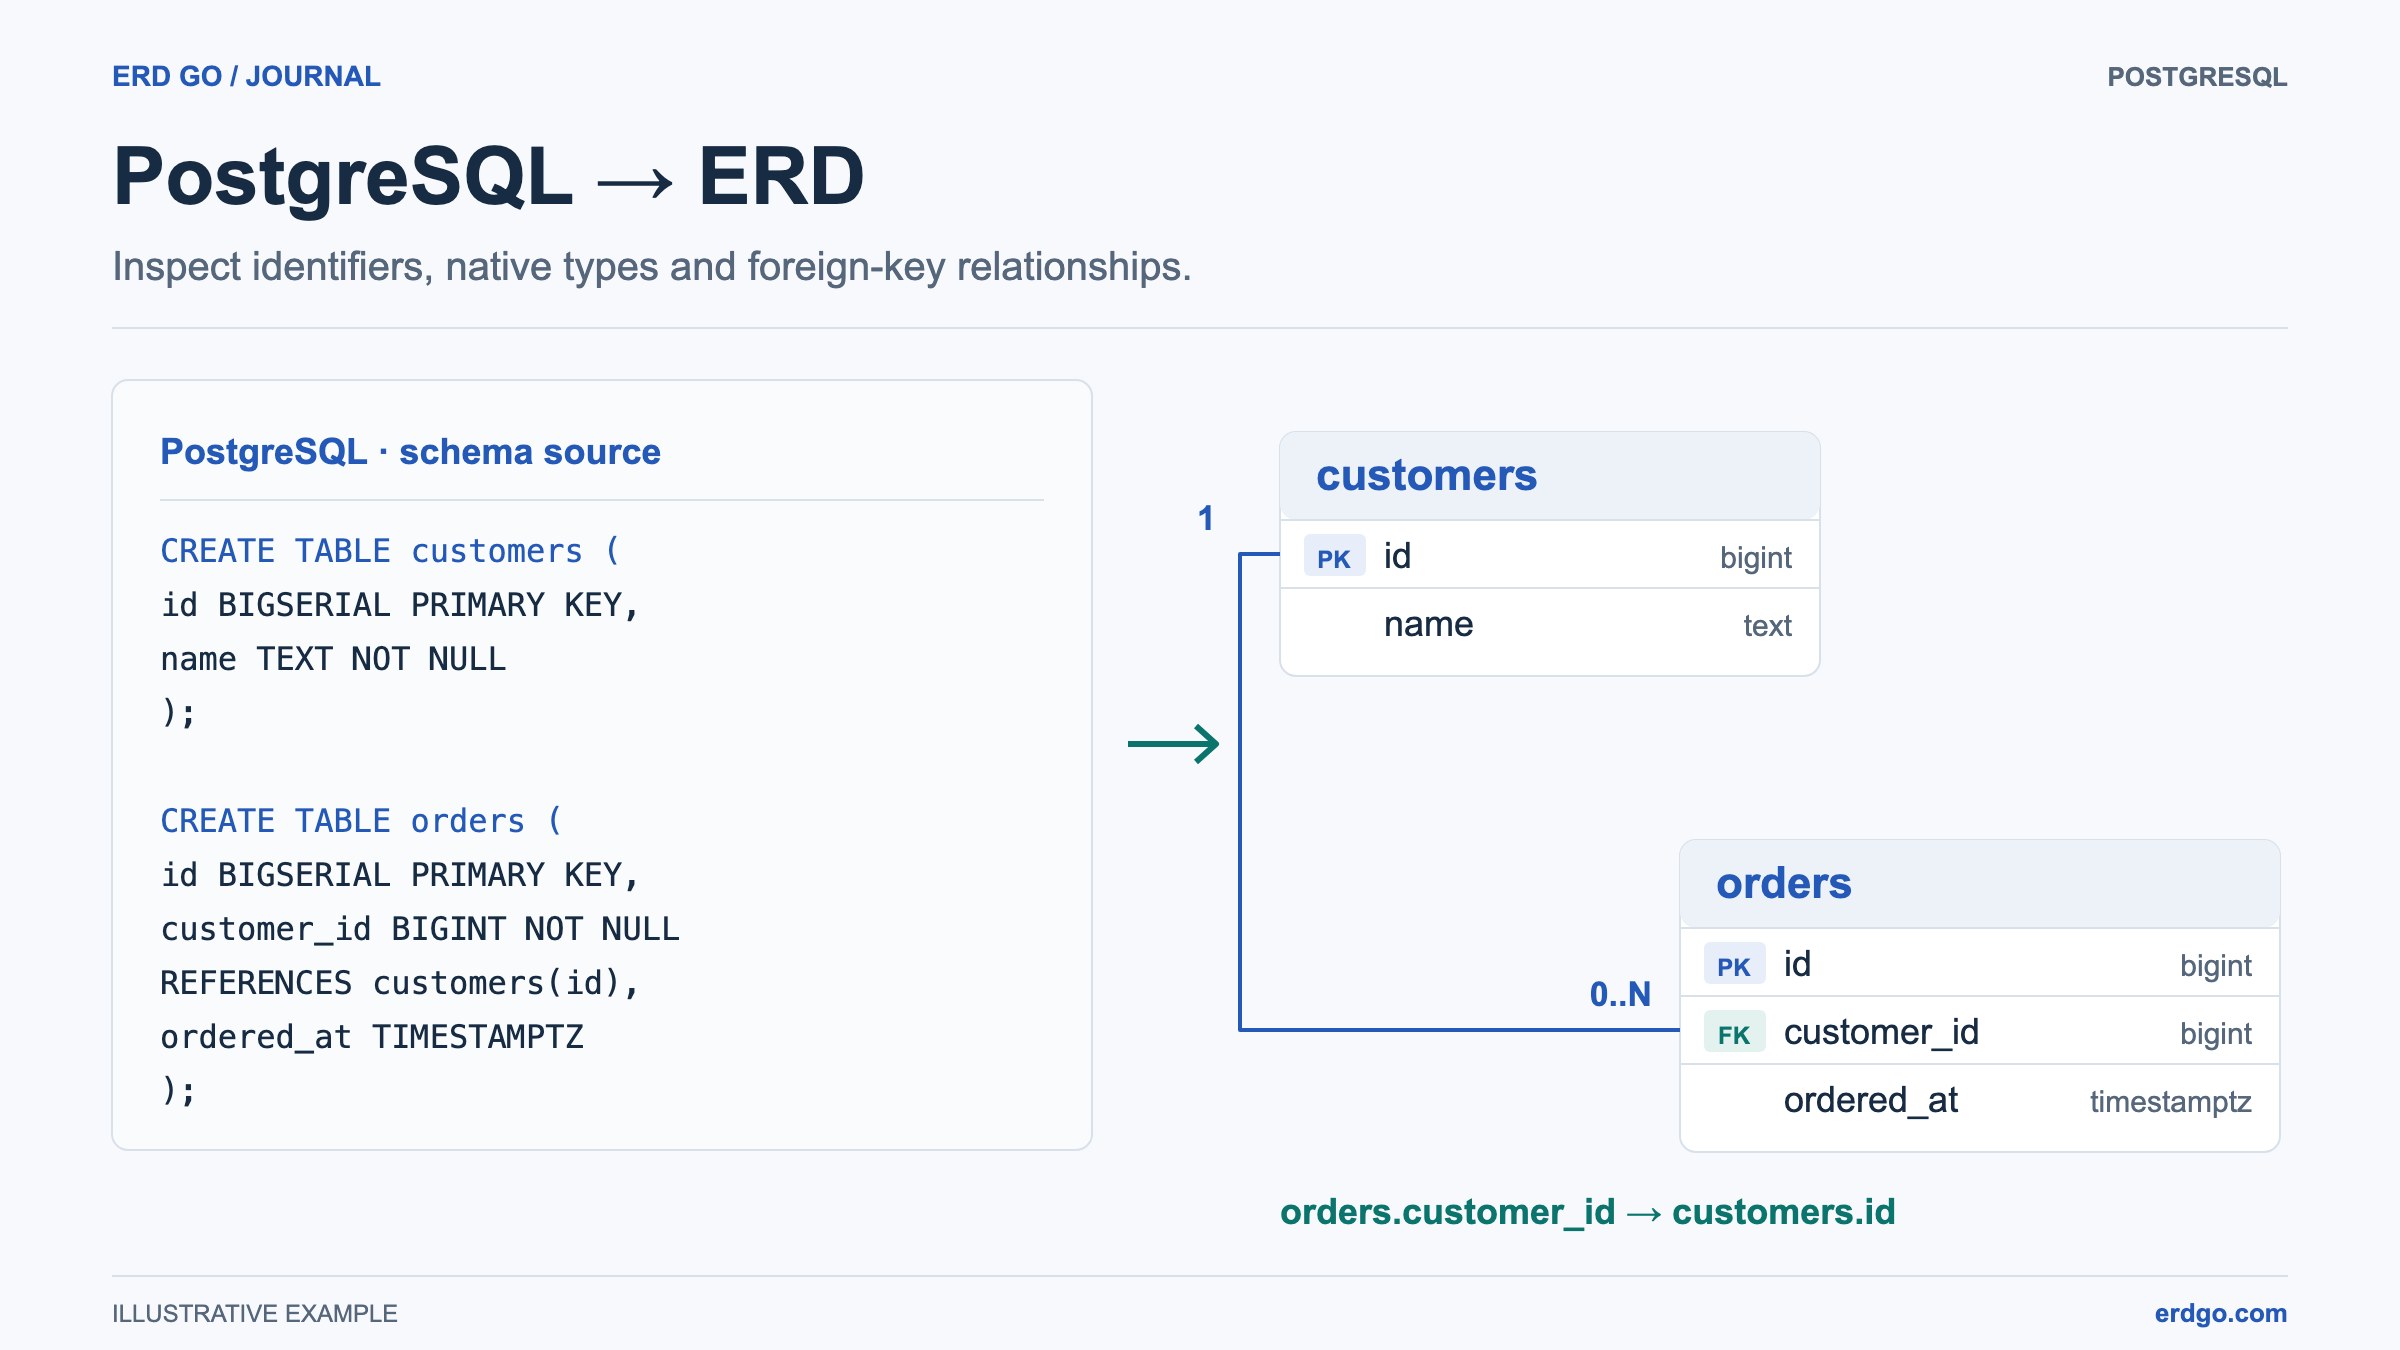
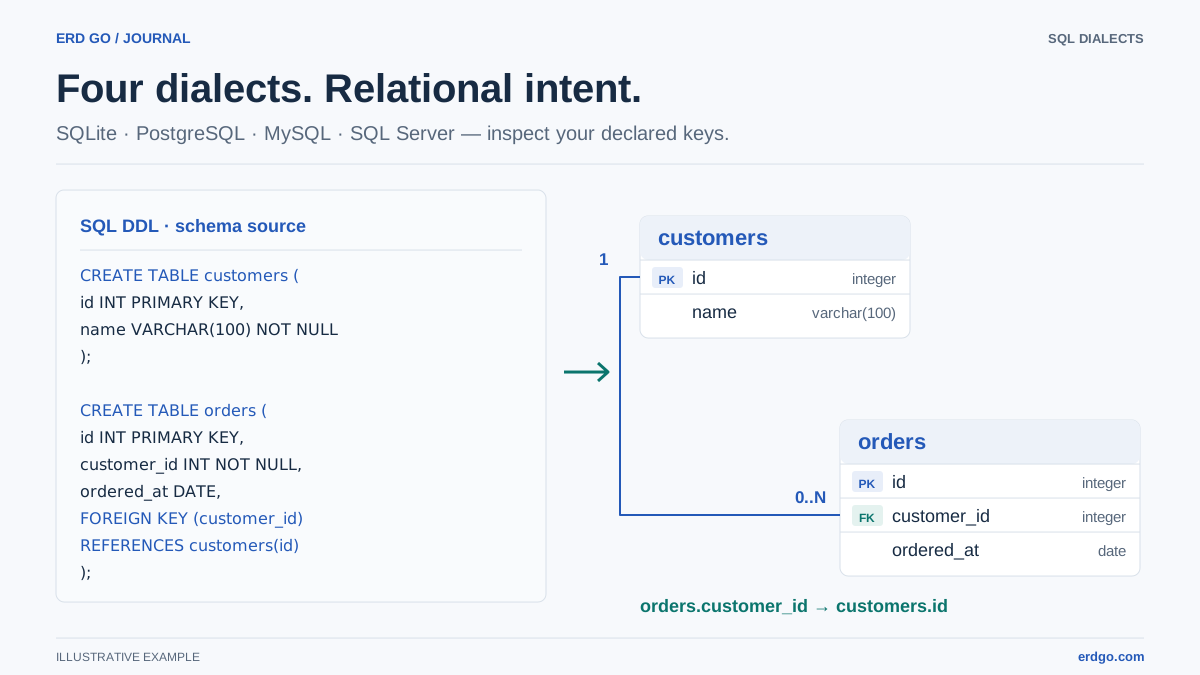
Een PostgreSQL ERD-generator leest uw DDL en maakt een entiteit-relatiediagram met tabellen, kolommen, primaire sleutels, vreemde sleutels en beperkingen. De Erd Go SQL naar ERD-editor ondersteunt PostgreSQL-stijl schema definities zodat u DDL kunt plakken en het model onmiddellijk kunt inspecteren.
PostgreSQL-functies die het waard zijn om te visualiseren
Zorg er bij het kiezen van een Postgres-diagramworkflow voor dat de tool de databasefuncties begrijpt die uw applicatie daadwerkelijk gebruikt.
- Identiteits- en serial-kolommen. Primary keys zoals
SERIAL,BIGSERIAL, enGENERATED ALWAYS AS IDENTITYmoeten worden herkend als gegenereerde identifiers. - Aangepaste typen.
CREATE TYPE ... AS ENUMwaarden zichtbaar blijven in plaats van te worden afgevlakt tot generieke tekenreeksen. - Vreemde sleutels. Inline
REFERENCESen benoemde tabelniveaubeperkingen moeten beide diagramrelaties produceren. - Schema-qualified objects. Namen zoals
billing.invoicesenauth.usersmoeten begrijpelijk blijven in het diagram.
Voorbeeld PostgreSQL DDL
Plak dit voorbeeld in de editor om een PostgreSQL-georiënteerd ERD te genereren:
CREATE TYPE order_status AS ENUM ('draft', 'paid', 'shipped', 'cancelled');

CREATE TABLE customers (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email       TEXT NOT NULL UNIQUE,
    full_name   TEXT NOT NULL,
    metadata    JSONB DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers (id),
    status      order_status NOT NULL DEFAULT 'draft',
    total       NUMERIC(12, 2) NOT NULL CHECK (total >= 0),
    tags        TEXT[] DEFAULT ARRAY[]::TEXT[],
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE order_events (
    id          BIGSERIAL PRIMARY KEY,
    order_id    BIGINT NOT NULL REFERENCES orders (id) ON DELETE CASCADE,
    event_name  TEXT NOT NULL,
    payload     JSONB NOT NULL DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_events_order_id ON order_events (order_id);
De belangrijke relaties zijn customers → orders en orders → order_events. De aangepaste enum, JSONB-kolommen, arrays, checks en indexen voegen implementatiedetails toe zonder het kerngegevensmodel te verbergen.
Postgres ERD-workflow
Voor teams die PostgreSQL gebruiken, is een SQL-first diagramworkflow meestal het meest betrouwbaar.
- Exporteer of kopieer de huidige DDL uit uw migratiebestanden, schemadump of pull-request.
- Plak het in Erd Go om het diagram automatisch te genereren.
- Verplaats belangrijke tabellen naar leesbare clusters zoals auth, billing, catalog en audit.
- Gebruik het diagram tijdens de beoordeling om ontbrekende vreemde sleutels en verwarrende eigenschapsgrenzen te controleren.
- Nadat de migratie is goedgekeurd, genereert u het ERD opnieuw vanuit de bijgewerkte DDL zodat het diagram synchroon blijft.