SQL-exempel använder PostgreSQL såvida inte en annan dialekt anges. Korta kodsnuttar förutsätter att deras refererade tabeller redan existerar. Validera DDL i din måldatabas innan du tillämpar den.
Varför PostgreSQL-scheman behöver bra diagram
PostgreSQL-scheman innehåller ofta mer än enkla tabeller. Verkliga projekt använder ENUM typer, identitetskolumner, schema-kvalificerade namn, JSON-fält, array-typer, sammansatta nycklar, genererade kolumner, partiella index och främmande nycklar med kaskadregler. Ett diagram hjälper teamet att förstå hela den strukturen snabbare än att läsa DDL rad för rad.
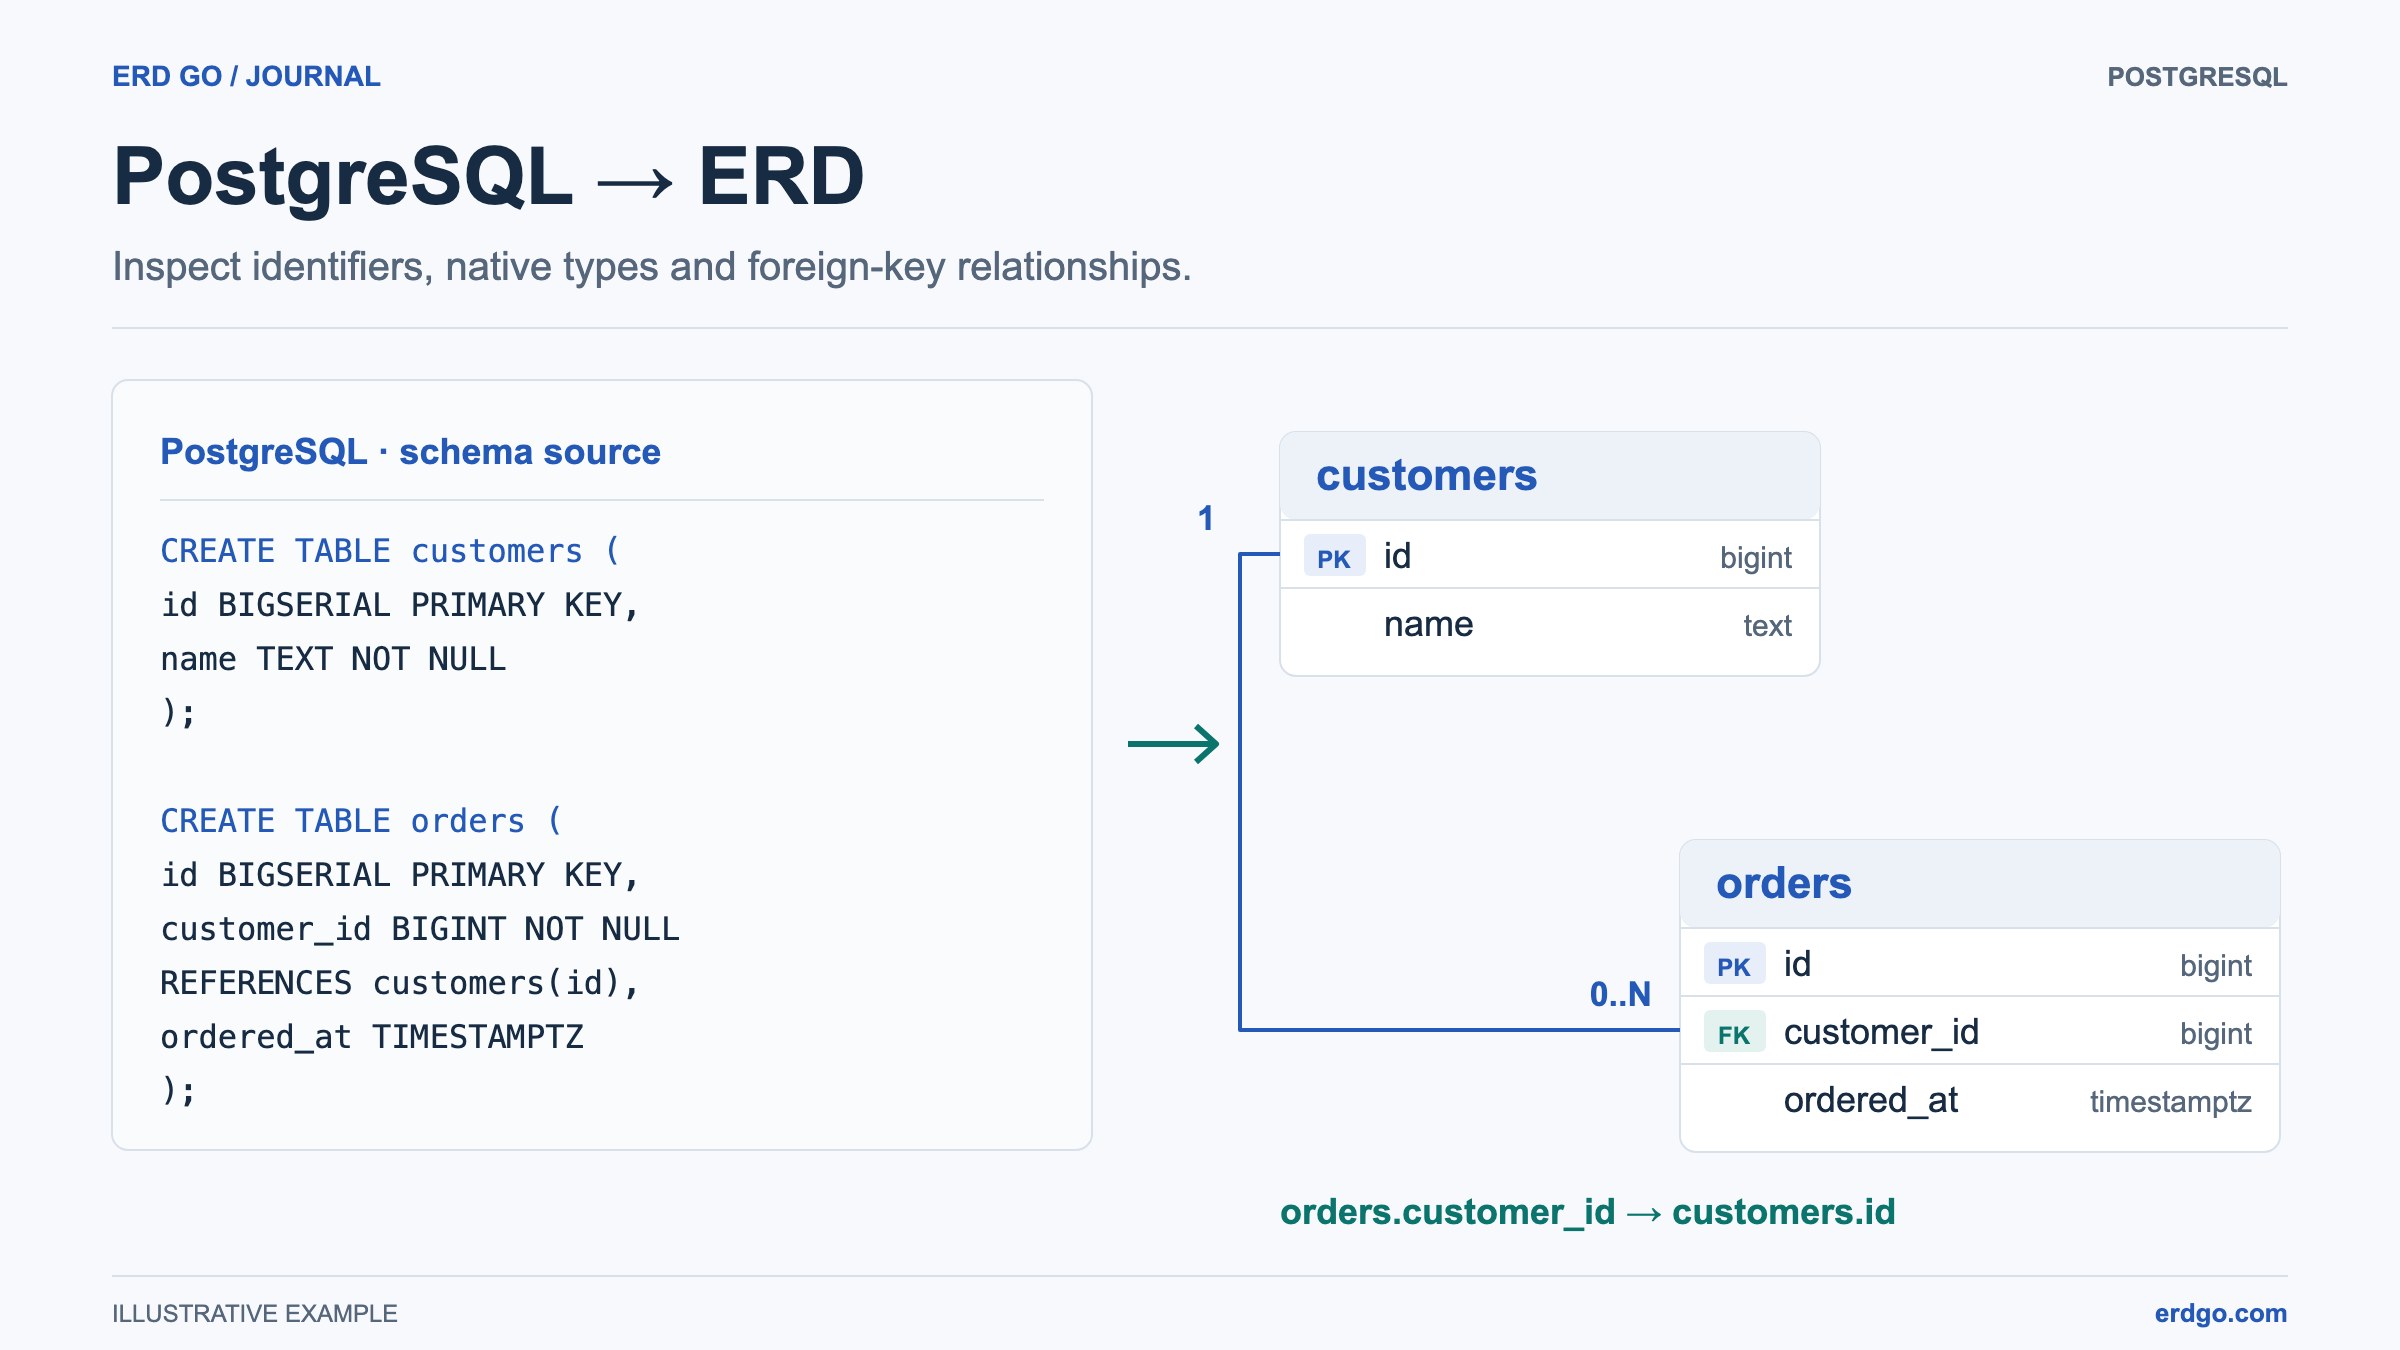
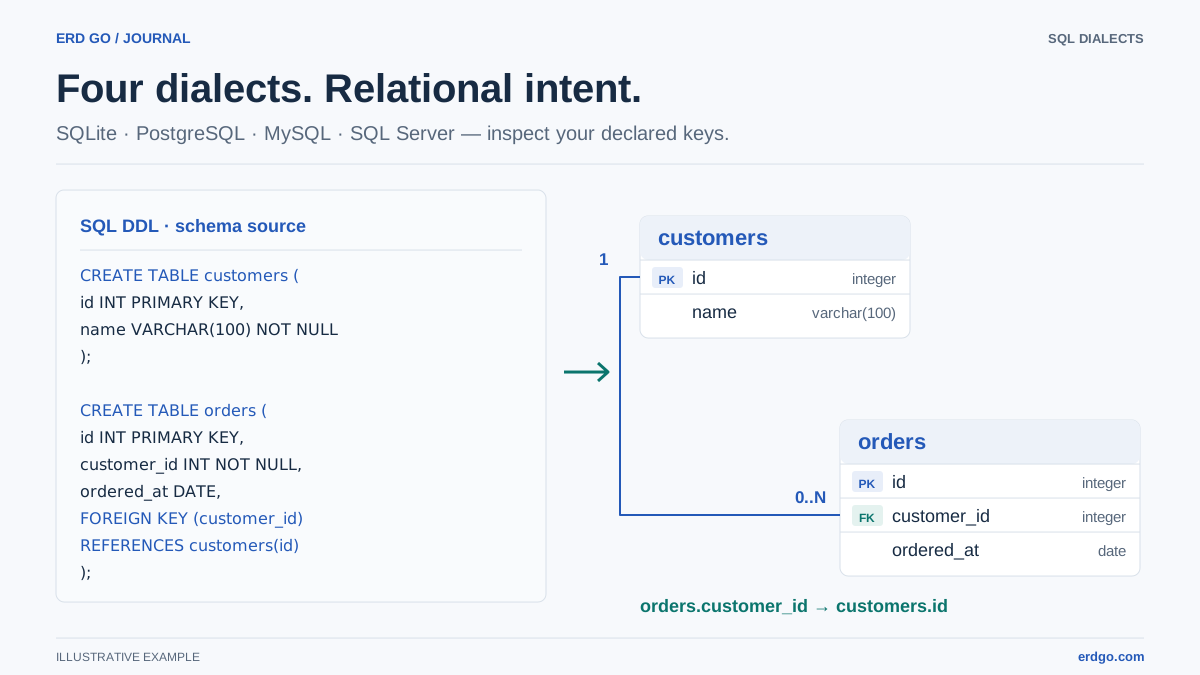
En PostgreSQL ERD-byggare läser din DDL och skapar ett entitets-relationsdiagram med tabeller, kolumner, primärnycklar, främmande nycklar och begränsningar. Den Erd Go SQL till ERD-redigerare stöder schemadefinitioner i PostgreSQL-stil så att du kan klistra in DDL och inspektera modellen omedelbart.
PostgreSQL-funktioner värda att visualisera
När du väljer ett arbetsflöde för Postgres-diagram, se till att verktyget förstår de databasfunktioner som din applikation faktiskt använder.
- Identity- och serial-kolumner. Primärnycklar såsom
SERIAL,BIGSERIAL, ochGENERATED ALWAYS AS IDENTITYbör kännas igen som genererade identifierare. - Anpassade typer.
CREATE TYPE ... AS ENUMvärden bör förbli synliga istället för att plattas ut till generiska strängar. - Främmande nycklar. Inline
REFERENCESoch namngivna begränsningar på tabellnivå behöver båda producera diagramrelationer. - Schemakvalificerade objekt. Namn såsom
billing.invoicesochauth.usersbör förbli begripliga i diagrammet.
Exempel på PostgreSQL DDL
Klistra in detta exempel i redigeraren för att generera ett PostgreSQL-anpassat ERD:
CREATE TYPE order_status AS ENUM ('draft', 'paid', 'shipped', 'cancelled');

CREATE TABLE customers (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email       TEXT NOT NULL UNIQUE,
    full_name   TEXT NOT NULL,
    metadata    JSONB DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers (id),
    status      order_status NOT NULL DEFAULT 'draft',
    total       NUMERIC(12, 2) NOT NULL CHECK (total >= 0),
    tags        TEXT[] DEFAULT ARRAY[]::TEXT[],
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE order_events (
    id          BIGSERIAL PRIMARY KEY,
    order_id    BIGINT NOT NULL REFERENCES orders (id) ON DELETE CASCADE,
    event_name  TEXT NOT NULL,
    payload     JSONB NOT NULL DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_events_order_id ON order_events (order_id);
De viktiga relationerna är customers → orders och orders → order_events. Den anpassade enum-typen, JSONB-kolumner, arrayer, kontroller och index lägger till implementeringsdetaljer utan att dölja kärndatamodellen.
Postgres ERD-arbetsflöde
För team som använder PostgreSQL är ett SQL-först-diagramarbetsflöde oftast det mest pålitliga.
- Exportera eller kopiera aktuell DDL från dina migreringsfiler, schemadump eller pull request.
- Klistra in det i Erd Go för att generera diagrammet automatiskt.
- Flytta viktiga tabeller till läsbara kluster såsom auth, billing, catalog och audit.
- Använd diagrammet under granskning för att kontrollera saknade främmande nycklar och förvirrande ägandegränser.
- När migreringen har godkänts, återskapa ERD från det uppdaterade DDL så att diagrammet förblir synkroniserat.