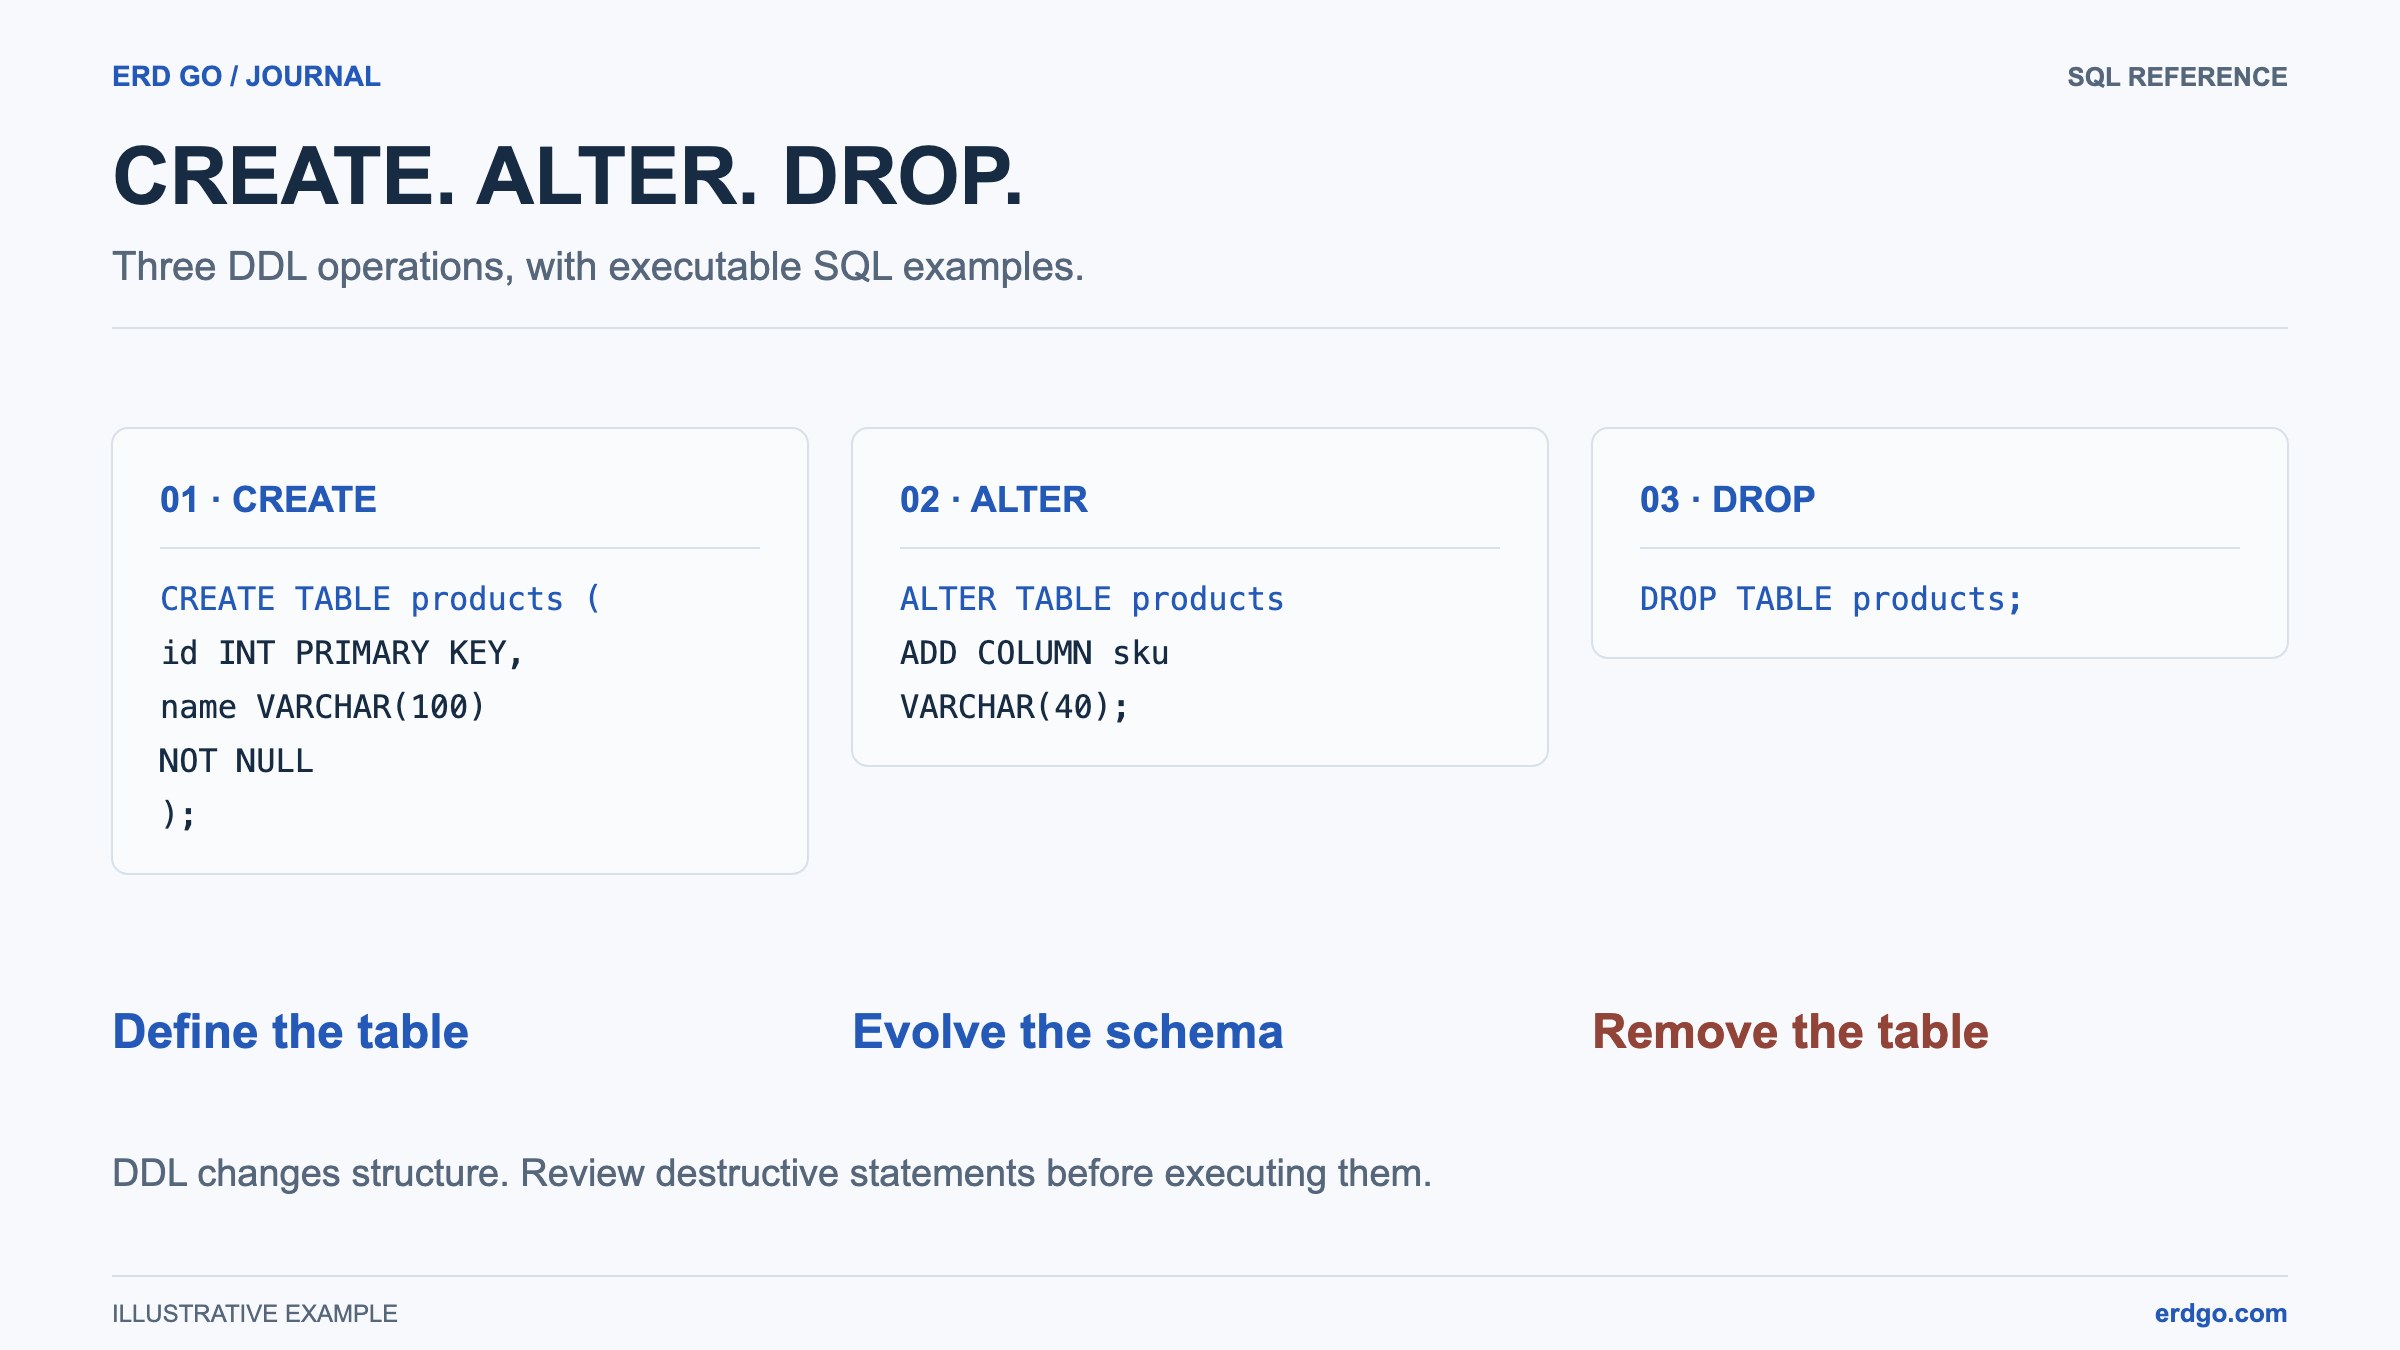
SQL-exempel använder PostgreSQL såvida inte en annan dialekt anges. Korta kodsnuttar förutsätter att deras refererade tabeller redan existerar. Validera DDL i din måldatabas innan du tillämpar den.
Vad är SQL-begränsningar?
Begränsningar är regler som tillämpas av databasmotorn för att garantera noggrannheten och tillförlitligheten hos data i en tabell. De fungerar som skyddsräcken — förhindrar ogiltiga infogningar, uppdateringar och raderingar vid databasgränsen. De skyddar de deklarerade reglerna; applikationsvalidering och transaktionsdesign är fortfarande viktiga.
SQL definierar flera typer av begränsningar. I den här guiden går vi igenom varje typ på djupet, visar när de ska användas och belyser vanliga fallgropar.
NOT NULL
Den NOT NULL villkor säkerställer att en kolumn alltid har ett värde. Varje INSERT eller UPDATE som försöker sätta kolumnen till NULL kommer att avvisas. En tom sträng är fortfarande ett värde; lägg till en CHECK när blank text är förbjuden.
CREATE TABLE products (
    id    SERIAL       PRIMARY KEY,
    name  VARCHAR(150) NOT NULL,   -- every product MUST have a name
    price NUMERIC(10,2) NOT NULL   -- every product MUST have a price
);

-- This will fail:
INSERT INTO products (name, price) VALUES (NULL, 9.99);
-- ERROR: null value in column "name" violates not-null constraint
Tips: Standard till NOT NULL för varje kolumn och ta endast bort det när du har ett tydligt affärsmässigt skäl för att tillåta null-värden. Null-värden introducerar trevärd logik i frågor och är en vanlig källa till subtila buggar.
UNIQUE
A UNIQUE villkor garanterar att inga två rader innehåller samma värde i den begränsade kolumnen (eller kombinationen av kolumner). Till skillnad från en primärnyckel, kan en UNIQUE kolumn kan innehåller NULL. PostgreSQL och MySQL tillåter normalt flera null-värden i en unik kolumn; SQL Server tillåter ett i en unik begränsning för en enskild kolumn. Detta är en unikhetsregel, inte resultatet av att utvärdera NULL = NULL.
CREATE TABLE users (
    id       SERIAL       PRIMARY KEY,
    email    VARCHAR(255) NOT NULL UNIQUE,
    username VARCHAR(50)  NOT NULL UNIQUE
);

-- Multi-column unique constraint
CREATE TABLE reservations (
    id        SERIAL PRIMARY KEY,
    room_id   INT    NOT NULL,
    date      DATE   NOT NULL,
    CONSTRAINT uq_room_date UNIQUE (room_id, date)
);
Den flerkolumniga UNIQUE villkor ovan säkerställer att samma rum inte kan bokas två gånger samma datum.
CHECK
CHECK villkor validerar att ett värde uppfyller ett booleskt uttryck innan det lagras. De framtvingar regler på radnivå som typsystemet ensamt inte kan uttrycka. En CHECK accepterar TRUE eller UNKNOWN; kombinera den med NOT NULL när ett värde krävs.
CREATE TABLE employees (
    id     SERIAL       PRIMARY KEY,
    name   VARCHAR(100) NOT NULL,
    age    INT          NOT NULL CHECK (age >= 18 AND age <= 120),
    salary NUMERIC(12,2) NOT NULL CHECK (salary > 0)
);

-- Named CHECK constraint with multiple columns
CREATE TABLE events (
    id         SERIAL      PRIMARY KEY,
    start_date DATE        NOT NULL,
    end_date   DATE        NOT NULL,
    CONSTRAINT chk_dates CHECK (end_date >= start_date)
);
Fallgrop: I MySQL-versioner före 8.0.16,CHECK villkor tolkas men tyst ignorerad. Verifiera alltid att din databasversion faktiskt framtvingar dem.
DEFAULT
Den DEFAULT tillhandahåller ett värde när en kolumn utelämnas från en INSERT eller DEFAULT begärs explicit. Ett explicit NULL anropar inte standardvärdet. Standardvärden minskar boilerplate i applikationskod och gör scheman självbeskrivande.
CREATE TABLE orders (
    id         SERIAL       PRIMARY KEY,
    status     VARCHAR(20)  NOT NULL DEFAULT 'pending',
    created_at TIMESTAMPTZ  NOT NULL DEFAULT now(),
    quantity   INT          NOT NULL DEFAULT 1
);

-- Inserting without specifying status, created_at, or quantity
INSERT INTO orders DEFAULT VALUES;
-- Result: status='pending', created_at=<current time>, quantity=1
DEFAULT med uttryck
PostgreSQL och SQL Server tillåter uttryck och funktionsanrop i standardvärden. MySQL stöder detta sedan version 8.0.13 för vissa typer.
-- PostgreSQL: UUID default
CREATE TABLE tokens (
    id    UUID DEFAULT gen_random_uuid() PRIMARY KEY,
    value TEXT NOT NULL
);
PRIMÄRNYCKEL & FRÄMMANDE NYCKEL-begränsningar
Dessa är de mest strukturella begränsningarna i relationsdatabaser. En PRIMARY KEY identifierar unikt varje rad och lägger implicit till NOT NULL + UNIQUE. En FOREIGN KEY länkar en tabell till en annan och upprätthåller referentiell integritet.
CREATE TABLE departments (
    id   SERIAL      PRIMARY KEY,
    name VARCHAR(80) NOT NULL UNIQUE
);

CREATE TABLE employees (
    id            SERIAL      PRIMARY KEY,
    name          VARCHAR(100) NOT NULL,
    department_id INT          NOT NULL,
    CONSTRAINT fk_emp_dept
        FOREIGN KEY (department_id)
        REFERENCES departments (id)
        ON DELETE RESTRICT
        ON UPDATE CASCADE
);
Se vår djupgående guide om Primärnycklar vs främmande nycklar för kaskadåtgärder, sammansatta nycklar och bästa praxis. Du kan också modellera dessa relationer visuellt i Erd Go-redigerare.
Kolumnnivå- kontra tabellnivåbegränsningar
Begränsningar kan definieras inline (kolumnnivå) eller som en separat klausul efter alla kolumner (tabellnivå). Resultatet är identiskt — men tabellnivå krävs när begränsningen sträcker sig över flera kolumner.
-- Column-level (single column)
CREATE TABLE items (
    id    SERIAL PRIMARY KEY,
    code  VARCHAR(20) NOT NULL UNIQUE,
    price NUMERIC(10,2) NOT NULL CHECK (price >= 0)
);

-- Table-level (multi-column constraint)
CREATE TABLE shipments (
    id          SERIAL PRIMARY KEY,
    origin      VARCHAR(3) NOT NULL,
    destination VARCHAR(3) NOT NULL,
    CONSTRAINT chk_different_locations CHECK (origin <> destination),
    CONSTRAINT uq_route UNIQUE (origin, destination)
);
Namngivna begränsningar & varför de är viktiga
Namnge alltid dina begränsningar explicit med hjälp av CONSTRAINT nyckelord. När en begränsning bryts returnerar databasen begränsningsnamnet i felmeddelandet — ett meningsfullt namn som chk_positive_salary är oändligt mycket mer hjälpsam än en autogenererad hash.
-- Good: named constraint
ALTER TABLE products
    ADD CONSTRAINT chk_positive_price CHECK (price > 0);

-- You can also drop a constraint by name
ALTER TABLE products
    DROP CONSTRAINT chk_positive_price;
En konsekvent namngivningskonvention gör migreringar, felsökning och team-introduktion mycket smidigare. Ett vanligt mönster är:
pk_<table>— primärnycklarfk_<table>_<column>— främmande nycklaruq_<table>_<column(s)>— unika begränsningarchk_<table>_<rule>— kontrollbegränsningar
Kombinera begränsningar & vanliga mönster
I praktiken bär kolumner flera begränsningar samtidigt. Här är mönster du kommer att använda om och om igen:
CREATE TABLE accounts (
    id         SERIAL       PRIMARY KEY,
    email      VARCHAR(255) NOT NULL,
    role       VARCHAR(20)  NOT NULL DEFAULT 'user'
                   CHECK (role IN ('user', 'admin', 'moderator')),
    balance    NUMERIC(12,2) NOT NULL DEFAULT 0.00
                   CHECK (balance >= 0),
    is_active  BOOLEAN      NOT NULL DEFAULT TRUE,
    created_at TIMESTAMPTZ  NOT NULL DEFAULT now(),
    deleted_at TIMESTAMPTZ           -- nullable: NULL means "not deleted"
);
Mjukt borttagningsmönster
Den deleted_at kolumn ovan implementerar en mjuk borttagning. Istället för att ta bort rader, sätter du deleted_at = now(). Para ihop detta med ett partiellt unikt index för att förhindra "aktiva" dubbletter samtidigt som rader med samma e-postadress som markerats som borttagna tillåts. Tabellen har avsiktligt ingen global UNIQUE-begränsning på e-post; att behålla en sådan skulle även avvisa dubbletter bland borttagna rader:
-- PostgreSQL: unique email only among active accounts
CREATE UNIQUE INDEX uq_accounts_active_email
    ON accounts (email)
    WHERE deleted_at IS NULL;
Vanliga fallgropar
- NULL och UNIQUE: De flesta databaser tillåter flera
NULLvärden i enUNIQUEkolumn eftersomNULLär inte lika med någonting — inklusive sig själv. SQL Server är undantaget och behandlarNULLsom en dubblett som standard; använd ett filtrerat index för att kringgå detta. - CHECK i äldre MySQL: Som nämnts ovan, MySQL före 8.0.16 tolkar men ignorerar
CHECKvillkor. Validera din MySQL-version eller framtvinga regler i applikationskoden. - Uppskjutna begränsningar: PostgreSQL stöder uppskjuten kontroll för foreign-key, unique, primary-key och exclusion-begränsningar deklarerade
DEFERRABLE INITIALLY DEFERRED. CHECK och NOT NULL kan inte skjutas upp. Detta är användbart för cirkulära referenser men kan göra felsökning svårare. - Prestanda för CHECK: Enkel
CHECKvillkor har försumbar overhead. Undvik att bädda in underfrågor eller funktionsanrop iCHECK— de kanske inte ens stöds och kan dölja långsam logik. - Ändring av begränsningar på stora tabeller: Lägger till en
NOT NULLvillkor i PostgreSQL kräva en tabellskanning såvida inte en befintlig validerad CHECK bevisar att kolumnen inte innehåller några nullvärden. På mycket stora tabeller, överväg att lägga till enCHECK (column IS NOT NULL) NOT VALIDförst, och validera det sedan separat.
Granska begränsningar i SQL och diagram tillsammans i SQL-till-ERD-redigerare, validera sedan deras beteende i måldatabasen. Ett diagram framtvingar inte dataintegritet.