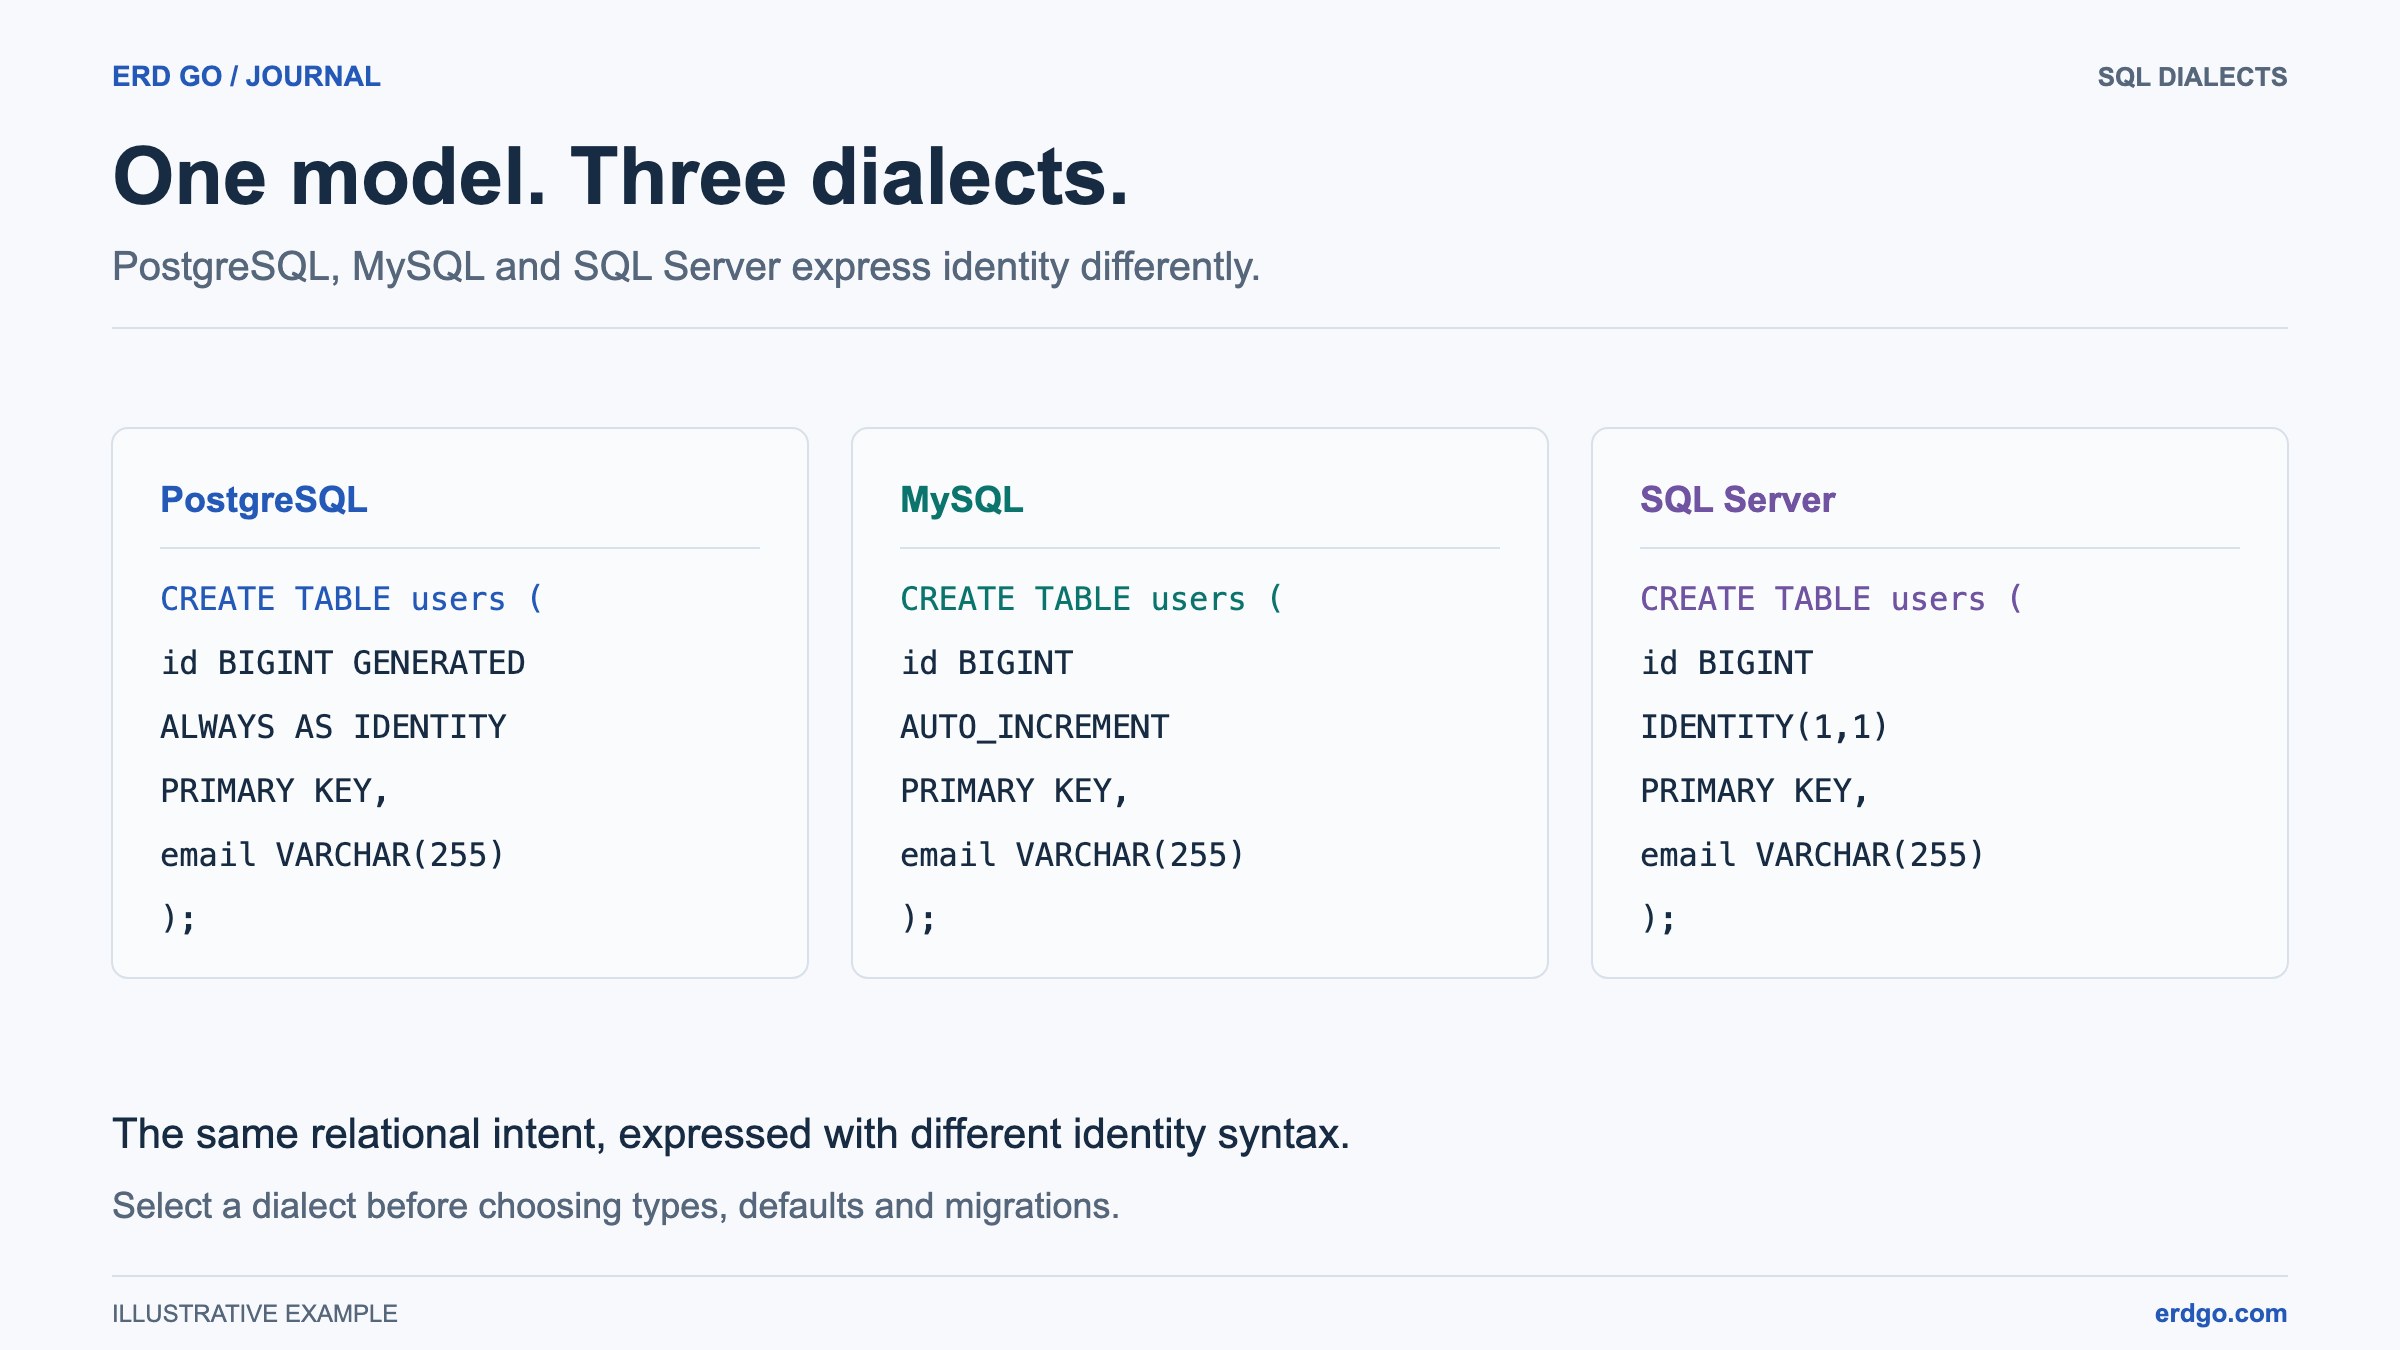
SQL-exempel använder PostgreSQL såvida inte en annan dialekt anges. Korta kodsnuttar förutsätter att deras refererade tabeller redan existerar. Validera DDL i din måldatabas innan du tillämpar den.
Vad är databasindex?
En index är en datastruktur som underhålls av databasmotorn och som ger en snabb sökväg till rader i en tabell. För selektiva filter kan ett index minska antalet rader eller sidor som läses. Optimeraren kan fortfarande välja en tabellskanning för små tabeller eller frågor som returnerar många rader. Mät planen och tidsåtgången istället för att anta en fast hastighetsökning.
Hur B-Tree-index fungerar
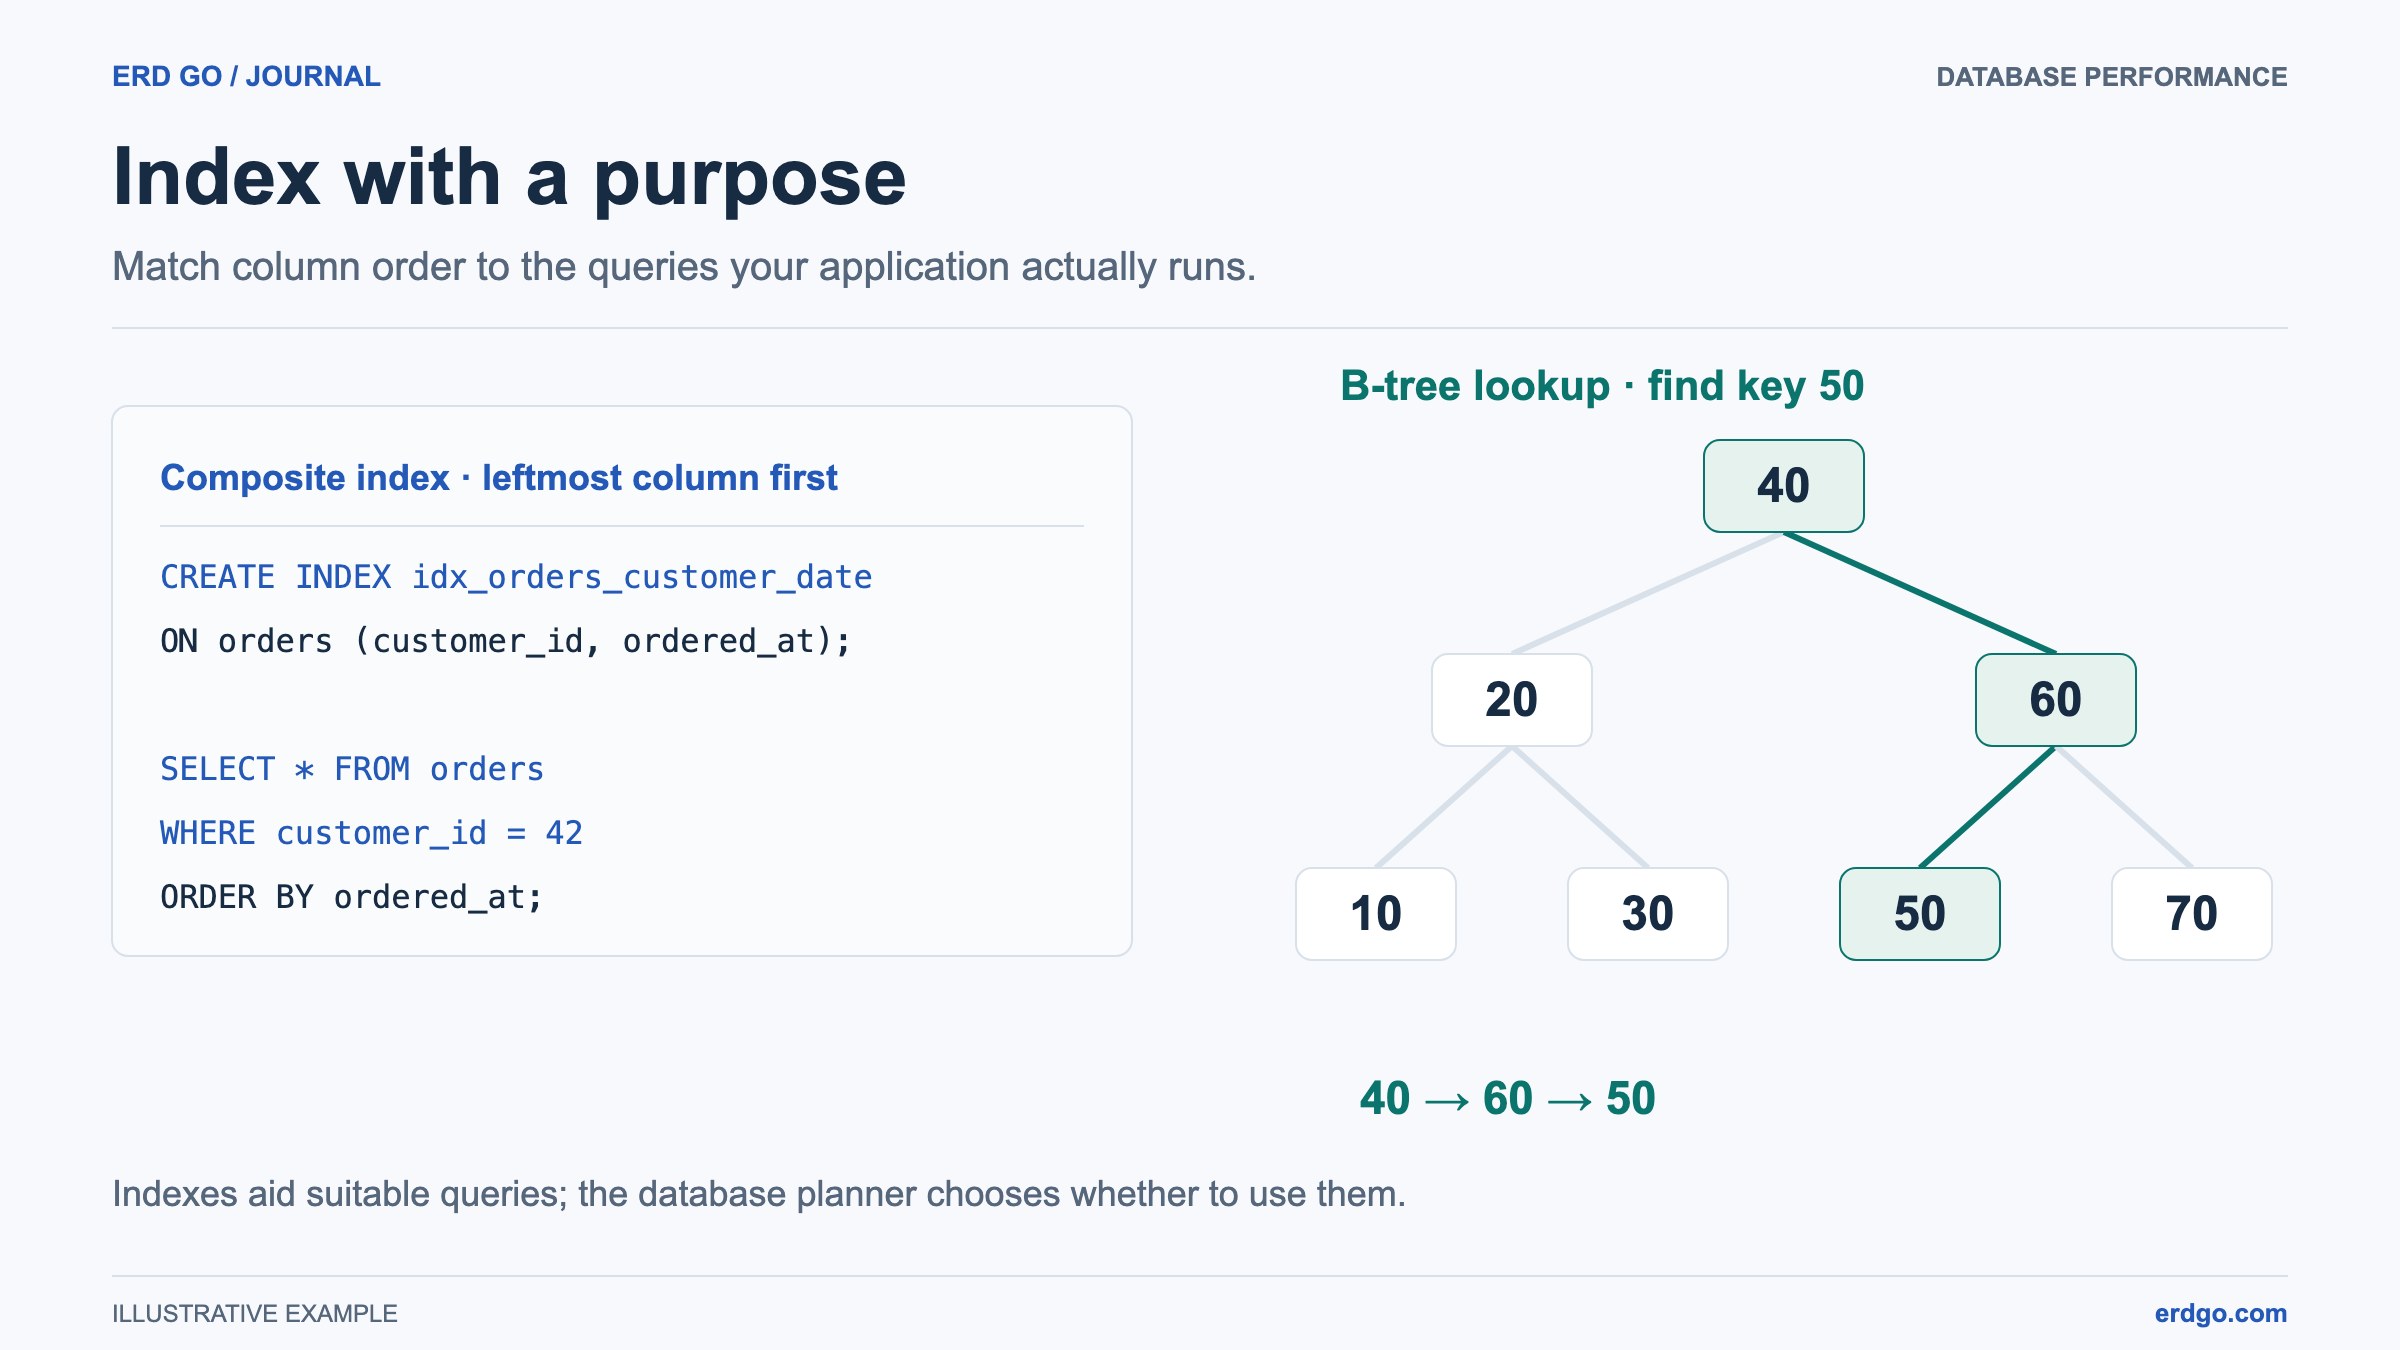
Den vanligaste indextypen i PostgreSQL, MySQL, SQL Server och SQLite är B-träd (balanserat träd). Tänk på det som en telefonbok: istället för att läsa varje namn från A till Ö, öppnar du på den ungefärliga sektionen, smalnar av till rätt sida och landar på posten. Ett B-träd fungerar på liknande sätt:
- Trädet är organiserat i noder. Varje intern nod innehåller sorterade nycklar och pekare till underordnade noder.
- En uppslagning börjar vid rot, jämför sökvärdet mot nodnycklar och följer rätt pekare ner genom gren noder.
- Den når ett löv innehållande matchande poster. Beroende på motor och index identifierar poster rader, innehåller en klustrad nyckel eller håller själva raddata.
- Trädet förblir balanserat, men dess djup och I/O beror på nyckelbredd, sidstorlek, radantal, cachning och om frågan även hämtar tabellsidor.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
När bör du använda index?
Index är inte gratis. De förbrukar diskutrymme och lägger till overhead för varje INSERT, UPDATE, och DELETE eftersom motorn måste hålla indexet synkroniserat med tabelldata. Använd dem strategiskt:
- Kolumner i
WHEREklausuler. Ett lämpligt index kan hjälpa ett frekvent selektivt filter; dess nytta beror på datadistributionen och den valda planen. - Kolumner i
JOINvillkor. Index kan hjälpa till vid kopplingar med främmande nycklar och uppdateringar eller borttagningar av föräldrar; en stor koppling kan fortfarande gynna en genomsökning. - Kolumner i
ORDER BYochGROUP BY. Ett index kan tillhandahålla försorterad data, vilket eliminerar en dyr sorteringsoperation. - Kolumner med hög kardinalitet. Kolumner med många distinkta värden (som e-post eller UUID) drar mer nytta än kolumner med få distinkta värden (som en boolean
is_activeflagga). - Stora tabeller. En tabell med 100 rader behöver sällan extra index. En tabell med 10 miljoner rader behöver det nästan säkert.
Som en allmän regel: börja utan extra index, mät frågeprestanda med EXPLAIN, lägg sedan till index där datan säger åt dig.
Typer av index
Enkolumnsindex
Den enklaste formen. Skapar ett B-träd på en kolumn. Idealisk för frågor som filtrerar eller sorterar på enbart den kolumnen.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Sammansatt (flerkolumns) index
Ett index på två eller flera kolumner. Likhetsfilter på inledande kolumner och ett intervall på nästa bildar ofta en effektiv B-träd-åtkomstväg. Andra villkor kan fortfarande använda en skanning eller hoppskanning; stöd och kostnad varierar beroende på motor och version.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Välj kolumnordning utifrån likhetsfilter, villkor för intervall, sortering och täckningsbehov. "Mest selektiva först" är inte en universell regel. PostgreSQL 18 kan använda B-träd-hoppskanningar för lämpliga icke-ledande filter.
Unikt index
Framtvingar en unikhetsbegränsning samtidigt som den ger indexbaserad sökprestanda. De flesta databaser skapar automatiskt ett unikt index när du definierar en UNIQUE villkor eller PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Partiellt (filtrerat) index
Indexerar endast de rader som uppfyller ett WHERE villkor. Detta håller indexet litet och högt målinriktat.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Ett partiellt eller filtrerat index kan hjälpa en liten, ofta efterfrågad delmängd. Frågans predikat måste implicera filtret. SQL Servers filtersyntax är mer begränsad än PostgreSQLs; kopiera inte godtyckliga predikat mellan dem.
Andra index-typer
| Indextyp | Bäst för | Databasstöd |
|---|---|---|
| Hash | Exakta likhetsuppslag (=) | PostgreSQL, MySQL (Memory-motor) |
| GIN | Fulltextsökning, JSONB, arrayer | PostgreSQL |
| GiST | Geometriska och intervall-datatyper | PostgreSQL |
| BRIN | Mycket stora tabeller med naturligt sorterad data | PostgreSQL |
| Fulltext | Textsökning med relevansrankning | MySQL, SQL Server |
Vanliga indexeringsmisstag
Även erfarna utvecklare faller i dessa fällor. Undvik dem för att hålla din databas presterande väl.
1. Överindexering
Att lägga till ett index på varje kolumn "för säkerhets skull" slösar diskutrymme och saktar ner skrivningar. Varje index måste uppdateras vid varje insert, update och delete. En tabell med 15 index kommer att ha betydligt långsammare skrivgenomströmning än en med 3 väl valda index.
2. Indexering av kolumner med låg kardinalitet
Indexering av en boolesk is_active kolumn som endast innehåller TRUE och FALSE kan vara användbart när värden är kraftigt skeva eller indexet täcker en smal fråga. Kardinalitet ensamt avgör inte om ett index hjälper. Om du måste filtrera på sådana kolumner, kombinera dem i ett sammansatt index med en kolumn med högre kardinalitet, eller använd ett partiellt index.
3. Ignorera frågemönster
Ett index är endast användbart om dina faktiska frågor kan utnyttja det. Undersök alltid de långsamma frågorna i din applikation först, designa sedan index som riktar sig mot dessa specifika åtkomstmönster.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Att glömma att indexera främmande nycklar
I PostgreSQL är främmande nyckel-kolumner inte indexeras automatiskt (till skillnad från MySQL:s InnoDB, som skapar ett index på främmande nycklar som standard). Ett index kan hjälpa selektiva kopplingar och referentiella kontroller, men optimeraren kan välja en skanning eller hash-koppling. Kontrollera om det finns ett befintligt index vars ledande kolumner redan täcker den främmande nyckeln innan du lägger till ett annat.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Att aldrig granska oanvända index
Med tiden ändras applikationskod och gamla index kanske inte längre tjänar någon fråga. Oanvända index förbrukar fortfarande lagringsutrymme och saktar ner skrivningar utan någon läsfördel.
Övervakning av indexanvändning
Moderna databaser tillhandahåller systemvyer som rapporterar hur ofta varje index används. Att regelbundet granska dessa hjälper dig att ta bort oanvända index och upptäcka saknade.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Behandla noll läsningar som en kandidat för granskning, inte som tillåtelse att ta bort ett index. Kontrollera när räknare återställdes, om instrumentering är aktiverad och om säsongsbetonade frågor, begränsningar eller främmande nyckelkontroller behöver det. Testa en föreslagen borttagning med en representativ arbetsbelastning.
Index i schemadesign och ERD:er
Medan ERD:er främst fokuserar på tabeller, kolumner och relationer, är index en viktig del av den övergripande schemadesignen. När du planerar din databas, överväg index tillsammans med dina tabelldefinitioner:
- A primärnyckel har normalt en motorhanterad åtkomstväg. SQLite INTEGER PRIMARY KEY använder rowid snarare än ett separat unikt index; kontrollera motorn innan du lägger till ett dubbelt index.
- Granska åtkomstvägar för främmande nycklar. PostgreSQL skapar inte automatiskt index på barnsidan, men ett befintligt sammansatt index kan redan täcka relationen.
- Kolumner med UNIQUE-begränsningar får ett automatiskt unikt index.
- Ytterligare index för kolumner som ofta efterfrågas bör dokumenteras tillsammans med ditt schema-DDL så att de inte glöms bort under driftsättning.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualisera ditt fullständiga schema—tabeller, relationer och kolumnerna du planerar att indexera—genom att klistra in din DDL i Erd Go-redigerare. Att se strukturen visuellt avslöjar ofta kolumner som behöver indexeras (som ofta joinade främmande nycklar) som du kan missa när du läser rå SQL.