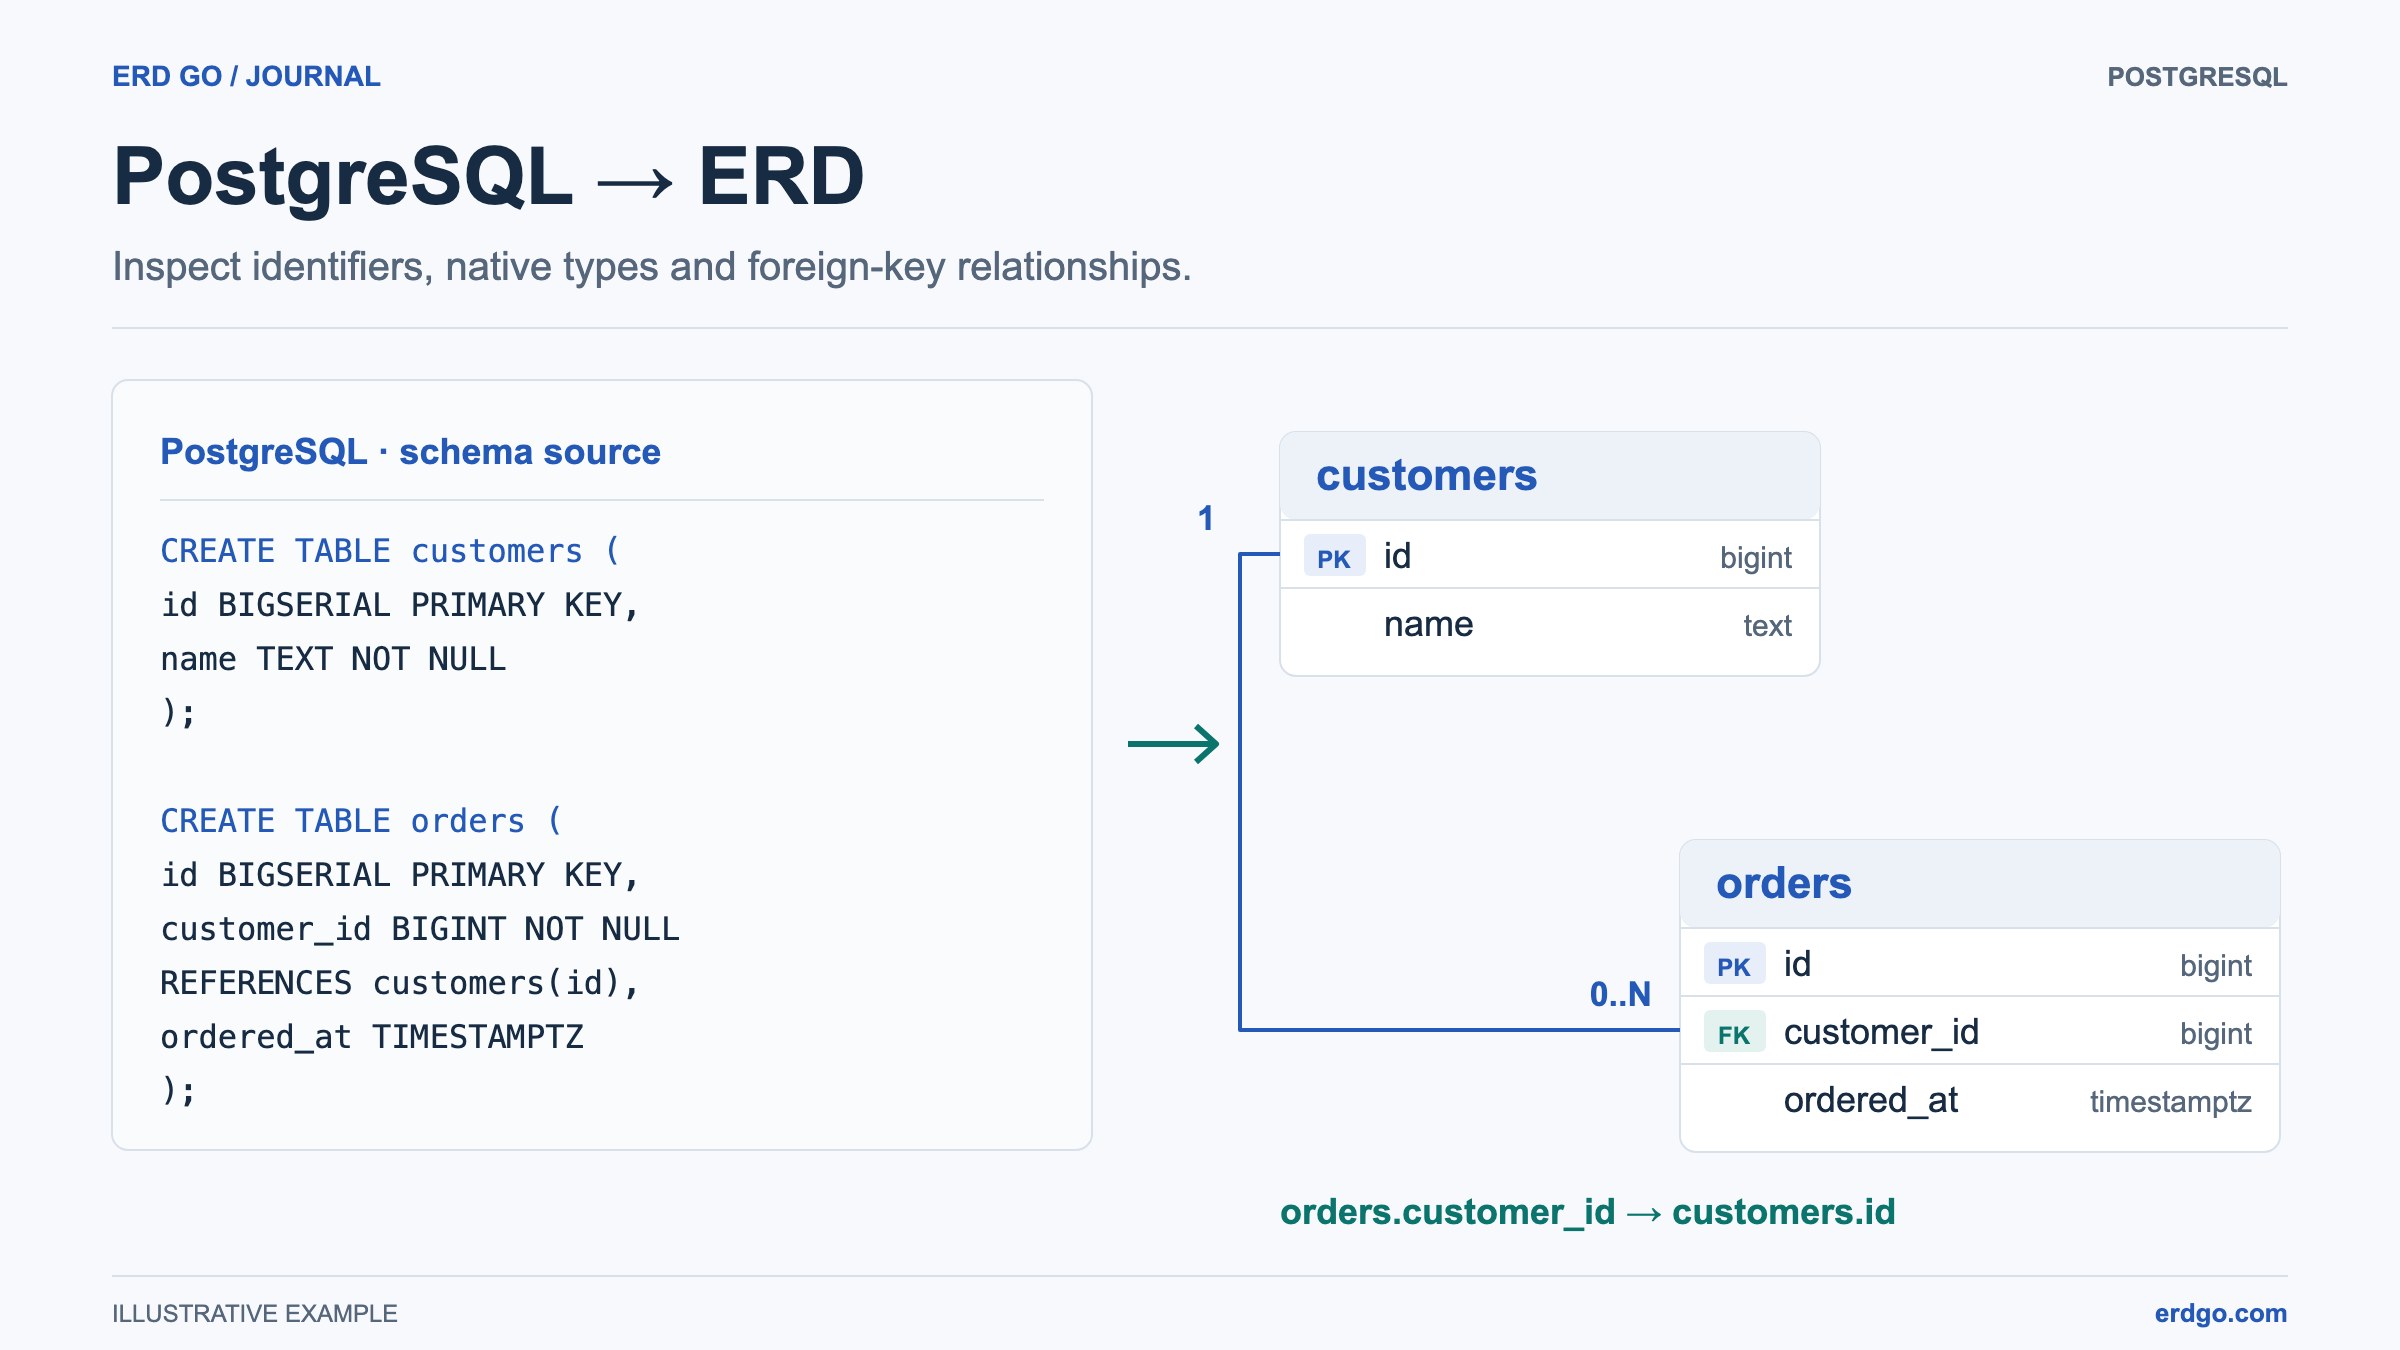
Przykłady SQL używają PostgreSQL, chyba że wymieniono inny dialekt. Krótkie fragmenty zakładają, że tabele, do których się odwołują, już istnieją. Zweryfikuj DDL w docelowej bazie danych przed jego zastosowaniem.
Dlaczego schematy PostgreSQL potrzebują dobrych diagramów
Schematy PostgreSQL często zawierają więcej niż proste tabele. Prawdziwe projekty używają ENUM typy, kolumny tożsamości, nazwy kwalifikowane schematem, pola JSON, typy tablicowe, klucze złożone, kolumny generowane, indeksy częściowe i klucze obce z regułami kaskadowymi. Diagram pomaga zespołowi zrozumieć całą tę strukturę szybciej niż czytanie DDL linia po linii.
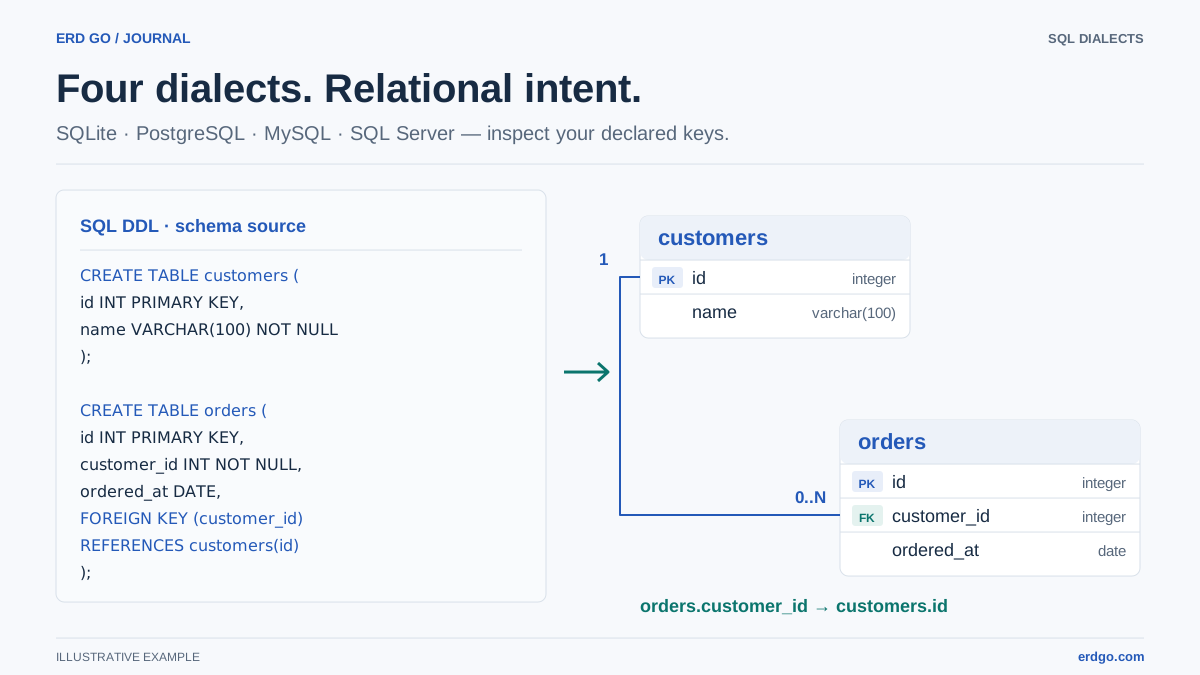
Generator ERD dla PostgreSQL odczytuje Twój DDL i tworzy diagram związków encji z tabelami, kolumnami, kluczami głównymi, kluczami obcymi i ograniczeniami. Ten Edytor SQL do ERD Erd Go obsługuje definicje schematów w stylu PostgreSQL, dzięki czemu można wkleić DDL i natychmiast sprawdzić model.
Funkcje PostgreSQL warte wizualizacji
Wybierając przepływ pracy dla diagramu Postgres, upewnij się, że narzędzie rozumie funkcje bazy danych, których faktycznie używa Twoja aplikacja.
- Kolumny identity i serial. Klucze główne takie jak
SERIAL,BIGSERIAL, orazGENERATED ALWAYS AS IDENTITYpowinny zostać rozpoznane jako wygenerowane identyfikatory. - Niestandardowe typy.
CREATE TYPE ... AS ENUMwartości powinny pozostać widoczne zamiast być spłaszczane do ogólnych ciągów znaków. - Klucze obce. Wstawiony
REFERENCESi nazwane ograniczenia na poziomie tabeli muszą generować relacje na diagramie. - Obiekty kwalifikowane schematem. Nazwy takie jak
billing.invoicesiauth.userspowinny pozostać zrozumiałe na diagramie.
Przykładowy DDL PostgreSQL
Wklej ten przykład do edytora, aby wygenerować ERD w wariancie PostgreSQL:
CREATE TYPE order_status AS ENUM ('draft', 'paid', 'shipped', 'cancelled');

CREATE TABLE customers (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email       TEXT NOT NULL UNIQUE,
    full_name   TEXT NOT NULL,
    metadata    JSONB DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers (id),
    status      order_status NOT NULL DEFAULT 'draft',
    total       NUMERIC(12, 2) NOT NULL CHECK (total >= 0),
    tags        TEXT[] DEFAULT ARRAY[]::TEXT[],
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE order_events (
    id          BIGSERIAL PRIMARY KEY,
    order_id    BIGINT NOT NULL REFERENCES orders (id) ON DELETE CASCADE,
    event_name  TEXT NOT NULL,
    payload     JSONB NOT NULL DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_events_order_id ON order_events (order_id);
Ważne relacje to customers → orders i orders → order_events. Niestandardowy enum, kolumny JSONB, tablice, ograniczenia check i indeksy dodają szczegóły implementacyjne bez ukrywania podstawowego modelu danych.
Przepływ pracy Postgres ERD
Dla zespołów korzystających z PostgreSQL, przepływ pracy oparty na diagramach SQL-first jest zazwyczaj najbardziej niezawodny.
- Eksportuj lub skopiuj bieżące DDL ze swoich plików migracji, zrzutu schematu lub pull requesta.
- Wklej to do Erd Go aby automatycznie wygenerować diagram.
- Przenieś ważne tabele do czytelnych klastrów, takich jak auth, billing, catalog i audit.
- Używaj diagramu podczas przeglądu, aby sprawdzić brakujące klucze obce i mylące granice własności.
- Po zatwierdzeniu migracji wygeneruj ponownie ERD ze zaktualizowanego DDL, aby diagram pozostał zsynchronizowany.