SQL-Beispiele verwenden PostgreSQL, sofern kein anderes Dialekt genannt wird. Kurze Schnipsel setzen voraus, dass ihre referenzierten Tabellen bereits existieren. Validieren Sie DDL in Ihrer Zieldatenbank, bevor Sie sie anwenden.
Warum PostgreSQL-Schemata gute Diagramme benötigen
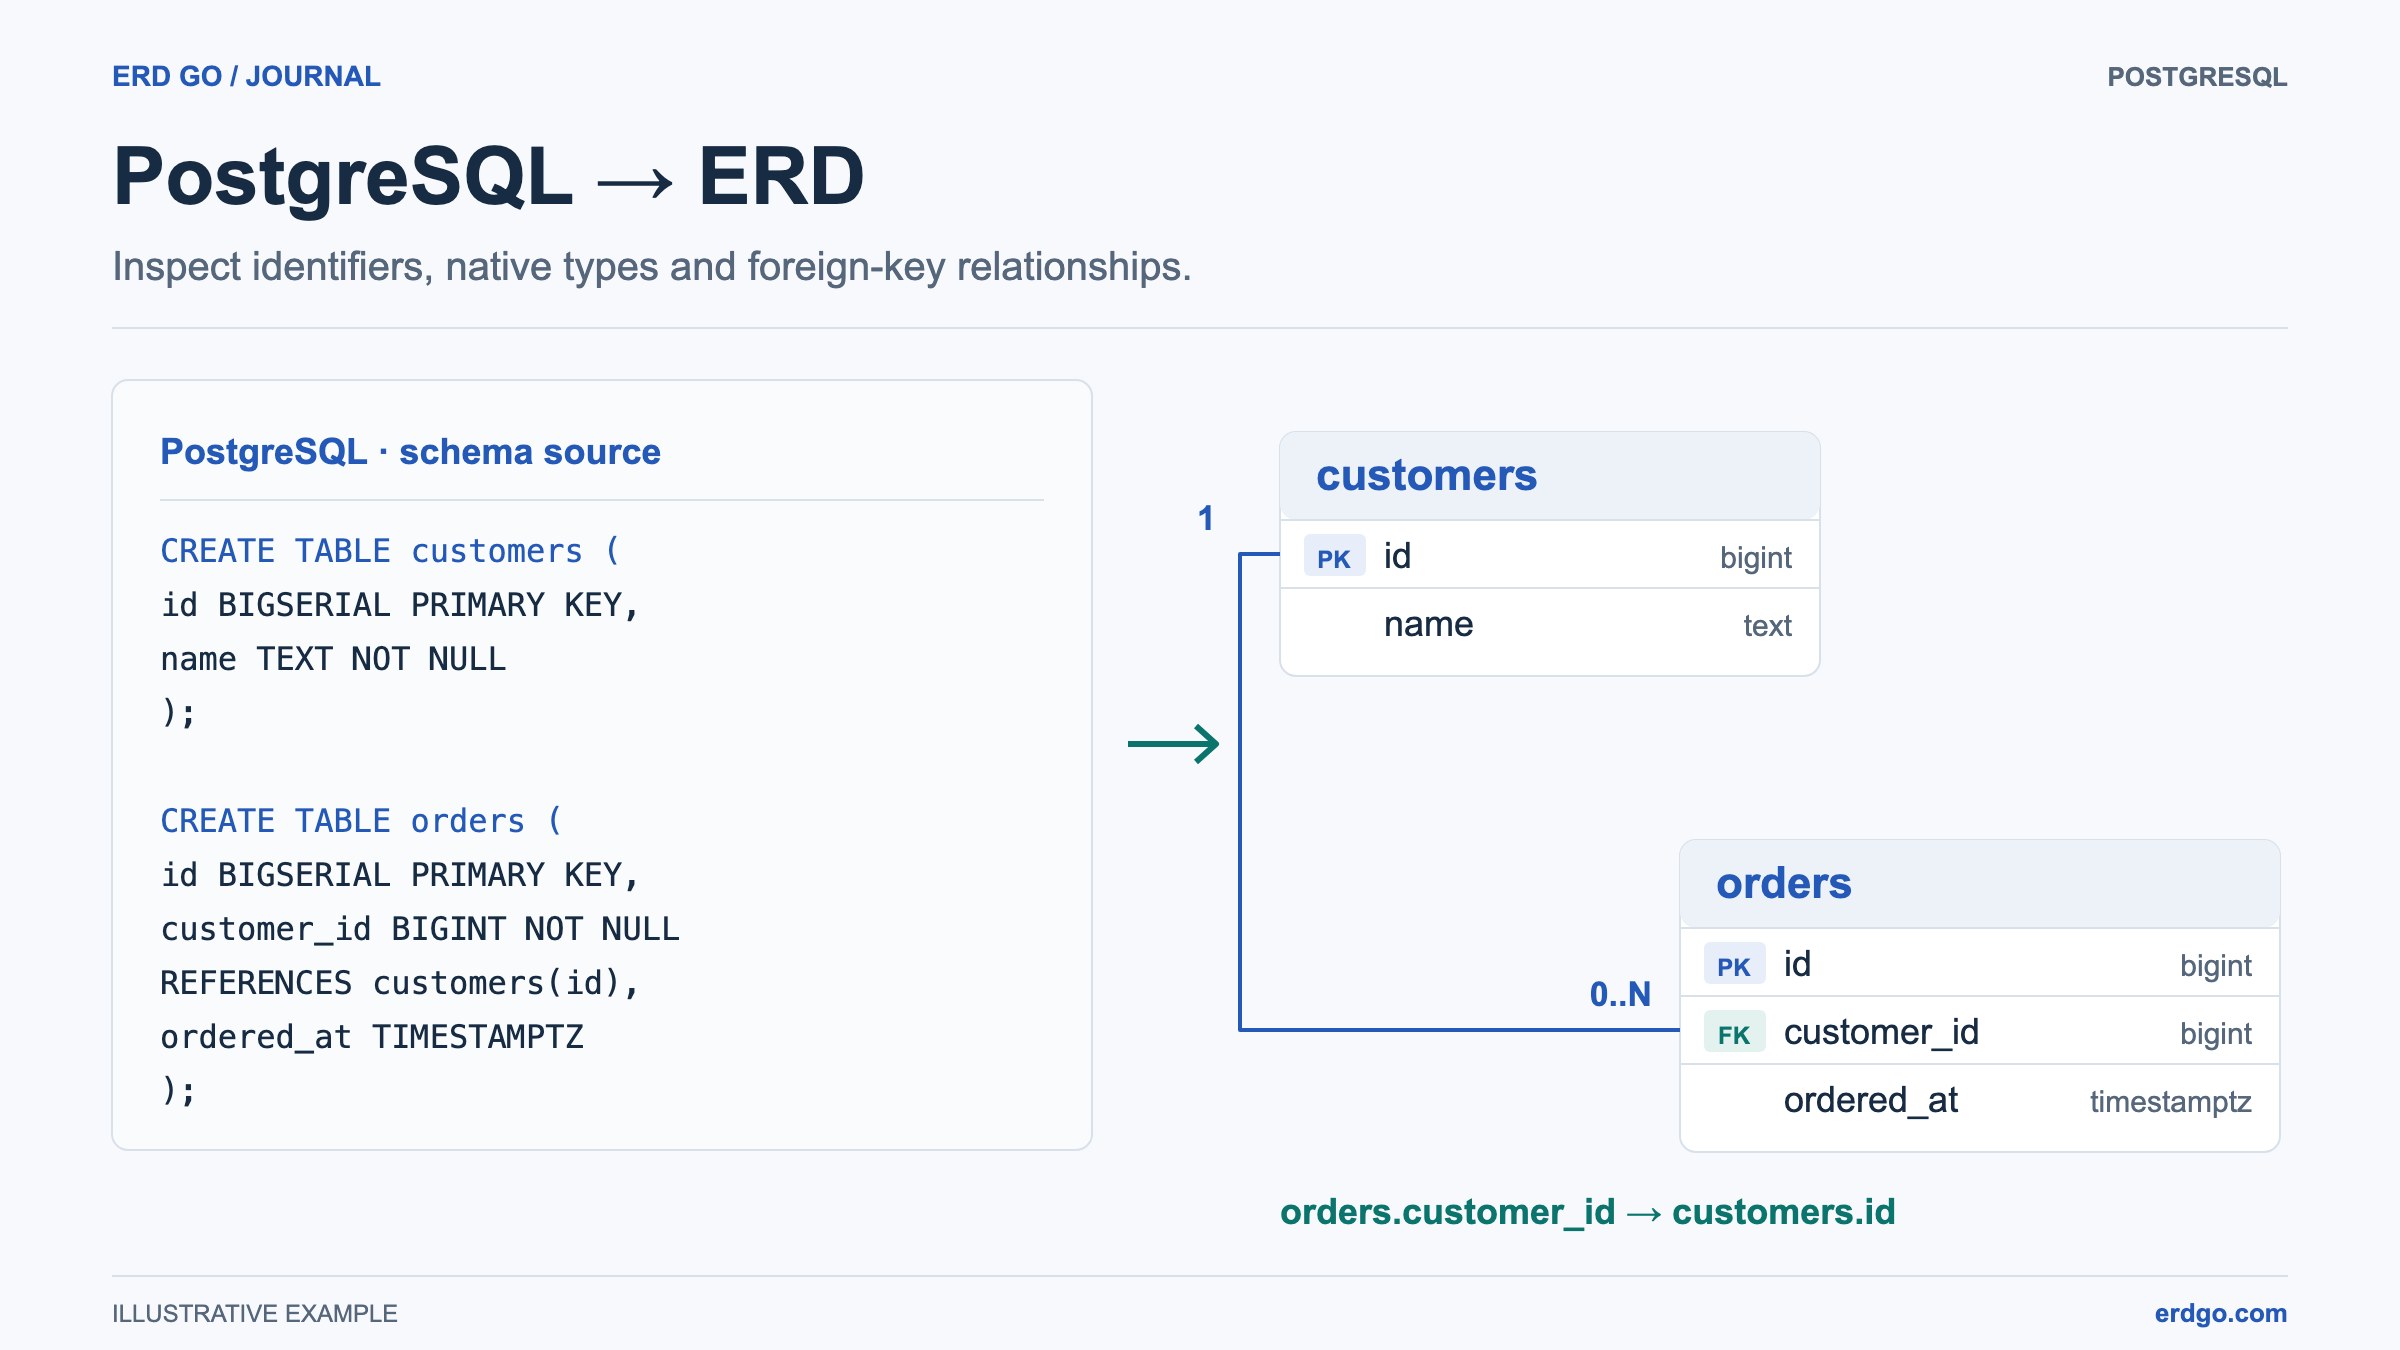
PostgreSQL-Schemata enthalten oft mehr als nur einfache Tabellen. Echte Projekte verwenden ENUM Typen, Identitätsspalten, schemataqualifizierte Namen, JSON-Felder, Array-Typen, zusammengesetzte Schlüssel, generierte Spalten, partielle Indizes und Fremdschlüssel mit Kaskadierungsregeln. Ein Diagramm hilft dem Team, all diese Strukturen schneller zu verstehen als das Lesen von DDL Zeile für Zeile.
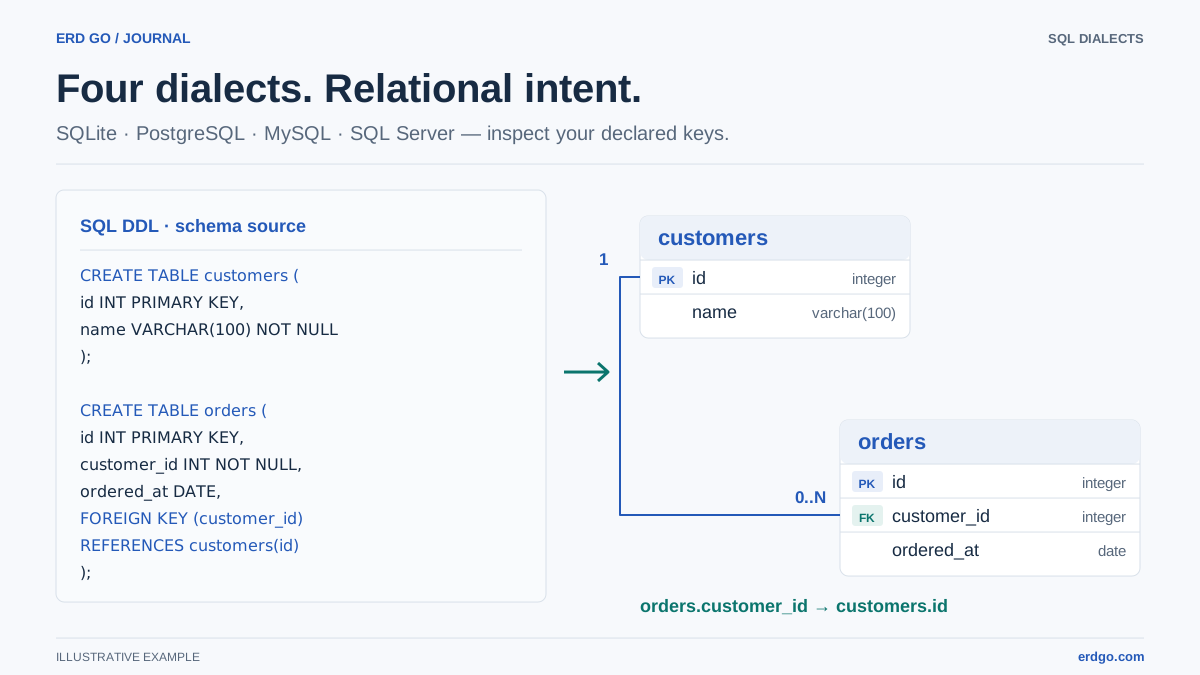
Ein PostgreSQL-ERD-Generator liest Ihr DDL ein und erstellt ein Entity-Relationship-Diagramm mit Tabellen, Spalten, Primärschlüsseln, Fremdschlüsseln und Constraints. Das Erd Go SQL zu ERD-Editor unterstützt Schema-Definitionen im PostgreSQL-Stil, sodass Sie DDL einfügen und das Modell sofort überprüfen können.
PostgreSQL-Funktionen, die visualisiert werden sollten
Stellen Sie bei der Auswahl eines Postgres-Diagramm-Workflows sicher, dass das Tool die Datenbankfunktionen versteht, die Ihre Anwendung tatsächlich nutzt.
- Identitäts- und Serial-Spalten. Primärschlüssel wie
SERIAL,BIGSERIAL, undGENERATED ALWAYS AS IDENTITYsollten als generierte Bezeichner erkannt werden. - Benutzerdefinierte Typen.
CREATE TYPE ... AS ENUMWerte sollten sichtbar bleiben, anstatt in generische Strings umgewandelt zu werden. - Fremdschlüssel. Inline
REFERENCESund benannte Einschränkungen auf Tabellenebene müssen beide Diagrammbeziehungen erzeugen. - Schema-qualifizierte Objekte. Namen wie
billing.invoicesundauth.userssollten im Diagramm verständlich bleiben.
Beispiel-PostgreSQL-DDL
Fügen Sie dieses Beispiel in den Editor ein, um ein ERD im PostgreSQL-Stil zu generieren:
CREATE TYPE order_status AS ENUM ('draft', 'paid', 'shipped', 'cancelled');

CREATE TABLE customers (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email       TEXT NOT NULL UNIQUE,
    full_name   TEXT NOT NULL,
    metadata    JSONB DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers (id),
    status      order_status NOT NULL DEFAULT 'draft',
    total       NUMERIC(12, 2) NOT NULL CHECK (total >= 0),
    tags        TEXT[] DEFAULT ARRAY[]::TEXT[],
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE order_events (
    id          BIGSERIAL PRIMARY KEY,
    order_id    BIGINT NOT NULL REFERENCES orders (id) ON DELETE CASCADE,
    event_name  TEXT NOT NULL,
    payload     JSONB NOT NULL DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_events_order_id ON order_events (order_id);
Die wichtigen Beziehungen sind customers → orders und orders → order_events. Der benutzerdefinierte Enum, JSONB-Spalten, Arrays, Checks und Indizes fügen Implementierungsdetails hinzu, ohne das Kerndatenmodell zu verdecken.
Postgres ERD Workflow
Für Teams, die PostgreSQL verwenden, ist ein SQL-zentrierter Diagramm-Workflow meistens am zuverlässigsten.
- Exportieren oder kopieren Sie das aktuelle DDL aus Ihren Migrationsdateien, dem Schema-Dump oder dem Pull-Request.
- Fügen Sie es ein in Erd Go um das Diagramm automatisch zu generieren.
- Verschieben Sie wichtige Tabellen in lesbare Cluster wie Authentifizierung, Abrechnung, Katalog und Audit.
- Verwende das Diagramm während der Überprüfung, um fehlende Fremdschlüssel und verwirrende Eigentumsgrenzen zu überprüfen.
- Nachdem die Migration genehmigt wurde, generieren Sie das ERD aus dem aktualisierten DDL neu, damit das Diagramm synchron bleibt.