SQL-Beispiele verwenden PostgreSQL, sofern kein anderes Dialekt genannt wird. Kurze Schnipsel setzen voraus, dass ihre referenzierten Tabellen bereits existieren. Validieren Sie DDL in Ihrer Zieldatenbank, bevor Sie sie anwenden.
Warum Datenbankdokumentation scheitert
Datenbankdokumentation veraltet oft, da sie getrennt vom Schema geschrieben wird. Jemand erstellt während des ersten Design-Sprints ein Diagramm, die Datenbank ändert sich sechs Monate lang, und die Dokumentation wird unbemerkt irreführend.
Ein besserer Ansatz ist es, die Dokumentation nah an der SQL-Quelle zu halten. Generieren Sie Diagramme aus DDL, fügen Sie kurze Erklärungen für Tabellen und Beziehungen hinzu und aktualisieren Sie die Dokumentation, sobald sich das Schema ändert.
Was in die Schemadokumentation aufgenommen werden sollte
Nützliche Datenbankdokumentation beantwortet die Fragen, die Entwickler tatsächlich stellen, während sie Features erstellen und Produktionsdaten debuggen.
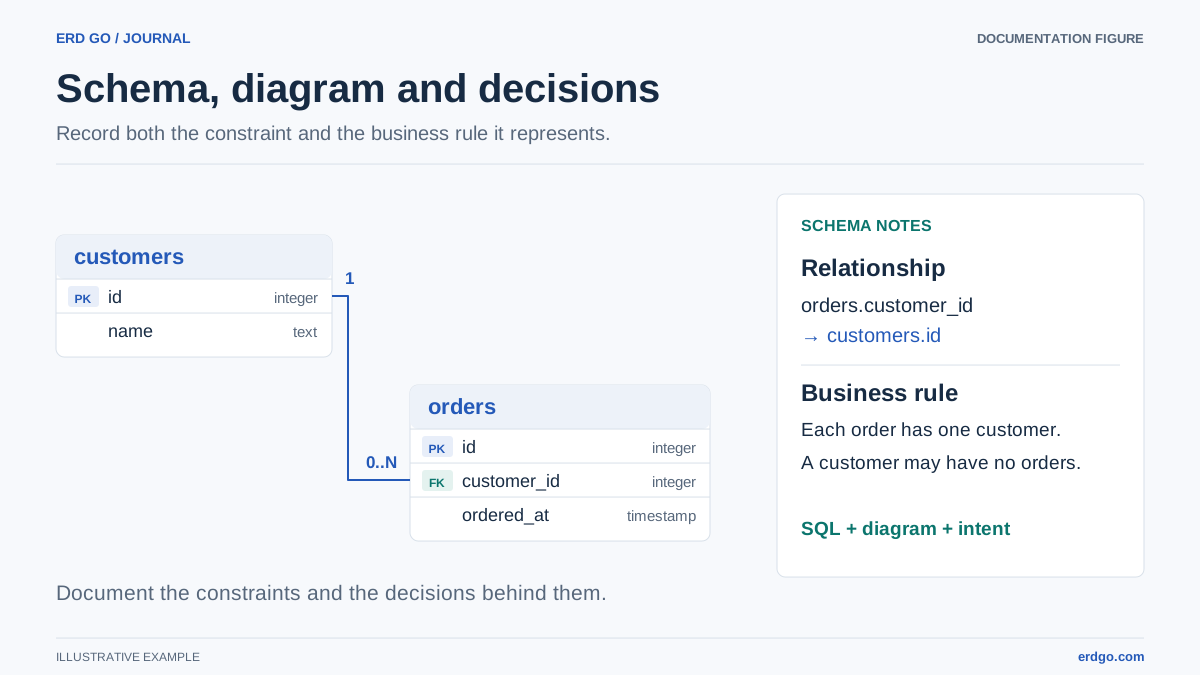
- Ein ERD. Tabellen, Primärschlüssel, Fremdschlüssel und die wichtigsten Beziehungspfade anzeigen.
- Hinweise zum Tabellenzweck. Erklären Sie, warum jede Haupttabelle existiert und welche Funktion sie besitzt.
- Beziehungsregeln. Geben Sie Kardinalität, optionale Beziehungen und kaskadierende Aktionen an.
- Wichtige Einschränkungen. Dokumentieren Sie eindeutige Schlüssel, Prüfungen, Enum-Werte und durch SQL durchgesetzte Geschäftsregeln.
- Migrationskontext. Verknüpfen Sie Schemaänderungen mit dem Feature, dem Fehlerbehebungs- oder Betriebsgründen dahinter.
Beispiel-Dokumentationsblock
Ein leichter Dokumentationseintrag kann SQL mit einfachen Notizen kombinieren:
CREATE TABLE accounts (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name TEXT NOT NULL
);

CREATE TABLE invoices (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    account_id  BIGINT NOT NULL REFERENCES accounts (id),
    status      VARCHAR(30) NOT NULL DEFAULT 'draft',
    total       NUMERIC(12, 2) NOT NULL CHECK (total >= 0),
    due_date    DATE,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE invoice_payments (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    invoice_id  BIGINT NOT NULL REFERENCES invoices (id) ON DELETE CASCADE,
    amount      NUMERIC(12, 2) NOT NULL CHECK (amount > 0),
    paid_at     TIMESTAMPTZ NOT NULL DEFAULT now()
);
Dokumentationsnotizen könnten besagen: Ein Konto hat viele Rechnungen, Rechnungen haben viele Zahlungsdatensätze, und Zahlungszeilen werden gelöscht, wenn eine Testrechnung gelöscht wird. In Produktionssystemen mit Audit-Anforderungen könnten Sie kaskadierende Löschungen durch eingeschränkte Löschungen und Archivdatensätze ersetzen.
Ein praktischer Dokumentations-Workflow
Hier ist ein Workflow, der Dokumentation nützlich hält, ohne sie zu einer abendfüllenden Aufgabe zu machen.
- Beginnen Sie mit dem SQL-Schema und generieren Sie ein ERD im Erd Go Editor.
- Exportieren Sie das Diagramm oder melden Sie sich an, speichern Sie es und teilen Sie einen schreibgeschützten öffentlichen Link, wenn das Schema für den öffentlichen Zugriff geeignet ist. Verwenden Sie Bild-Exporte für private Dokumentationen.
- Fügen Sie für jeden wichtigen Tabellencluster einen kurzen Absatz hinzu: auth, billing, orders, content, audit oder reporting.
- Generieren Sie das ERD nach Migrationen aus dem aktualisierten SQL neu, damit die Dokumentation widerspiegelt, was sich geändert hat.
- Halten Sie Syntaxbeispiele synchron mit dem Erd Go DDL-Dokumentation damit zukünftige Mitwirkende das Diagramm reproduzieren können.
Das Ziel ist keine perfekte Enzyklopädie. Das Ziel ist eine lebendige Karte, die Menschen hilft, die Datenbank schnell zu verstehen und dem zu vertrauen, was sie lesen.


