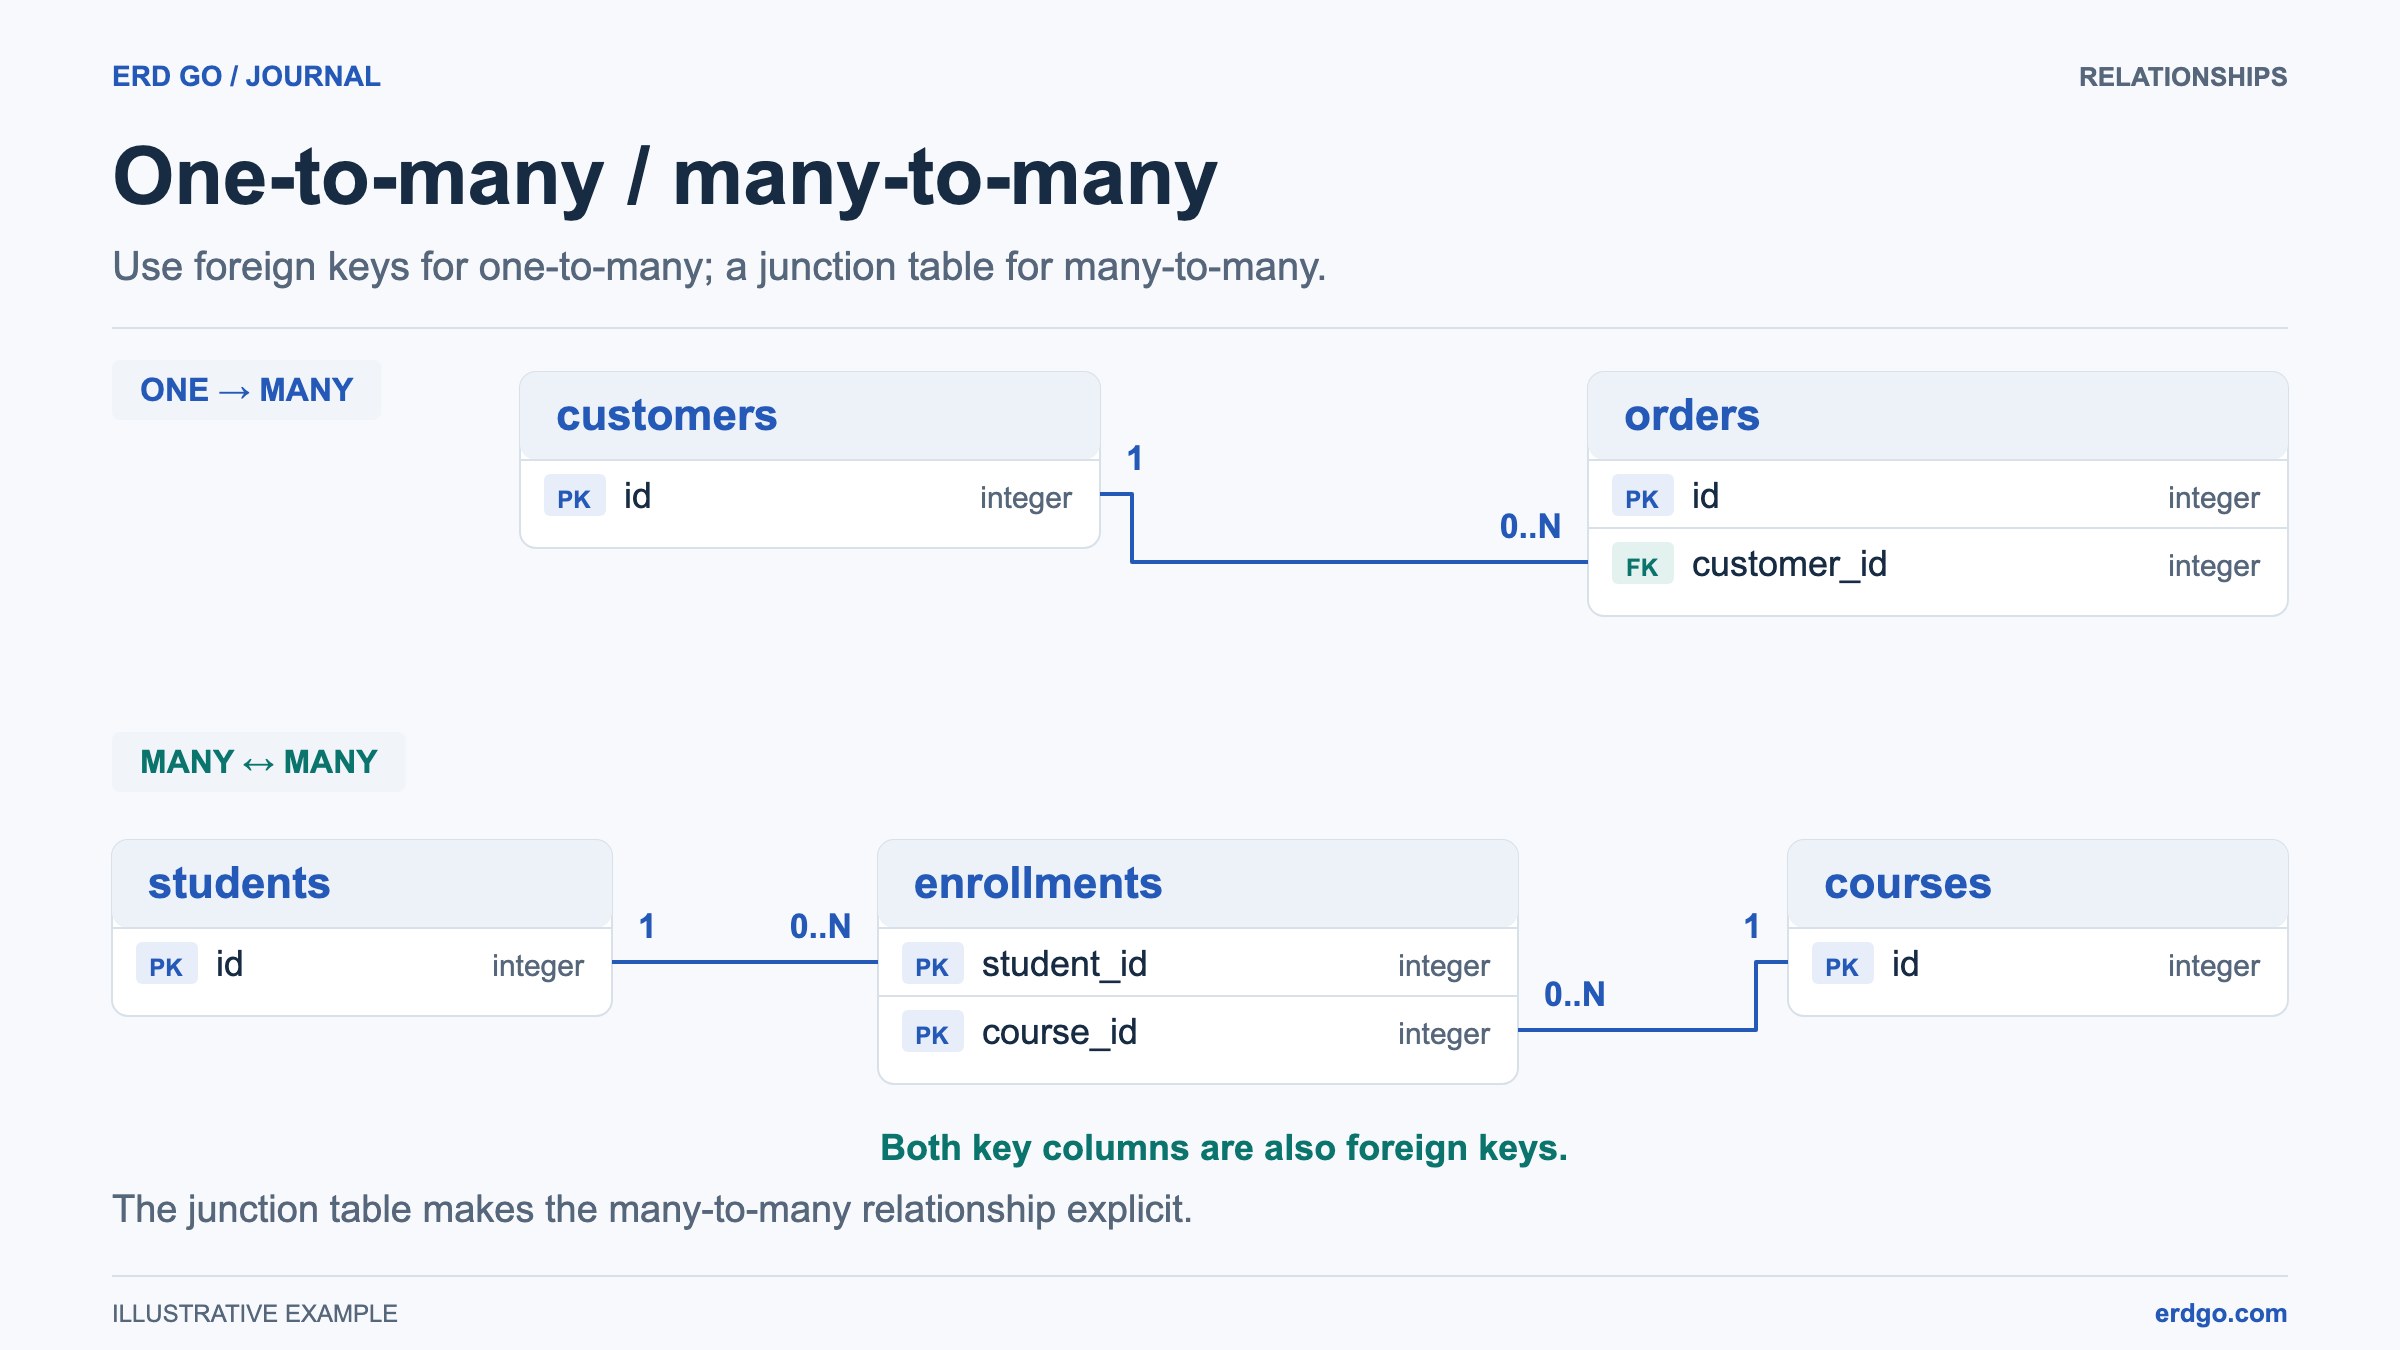
除非另外命名了方言,否则 SQL 示例使用 PostgreSQL。简短的代码片段假定其引用的表已存在。在应用 DDL 之前,请在目标数据库中验证 DDL。
什么是数据库规范化?
数据库规范化 是组织关系型数据库以减少数据冗余并提高数据完整性的过程。由 Edgar F. Codd 于 20世纪70年代引入,规范化涉及将大表分割为更小的、相关联的表,并定义它们之间的关系。
目标是始终如一地表示依赖关系并减少可避免的重复。历史快照(例如销售价格)可能属于不同的表,因为它们代表不同的事实。
为什么需要规范化?
- 消除冗余 — 避免在多个地方存储相同的数据。
- 防止更新异常 — 数据更改只需要在一个地方进行。
- 防止插入异常 — 您可以添加新数据,而无需添加不相关的数据。
- 防止删除异常 — 删除记录不会意外删除不相关的数据。
- 支持可维护的查询 — 清晰的依赖关系使查询更容易理解。性能取决于访问模式、索引和连接;规范化本身并不能使查询更快。
第一范式 (1NF)
表处于 第一范式 (1NF) 当:
- 每列仅包含原子(不可分割)值
- 每列包含单个类型的值
- 行可以通过候选键区分;声明主键以在 SQL 中强制执行选定的标识符
- 没有重复组或数组
第一范式之前(违反)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
第一范式 (1NF) 之后
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
第二范式 (2NF)
表处于 第二范式 (2NF) 当:
- 它已经处于 1NF
- 每个非主属性都依赖于每个 整个 候选键,且不依赖于键的一部分
候选键是唯一标识一行的最小属性集。出现在任何候选键中的属性都是主属性。当候选键包含多个列时,部分依赖就很重要;候选键包括备用唯一标识符,而不仅仅是选定的主键。如果非键列仅依赖于键的一部分,则应将其移动到单独的表中。
第二范式之前(违反)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
第二范式 (2NF) 之后
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
第三范式 (3NF)
表处于 第三范式 (3NF) 当:
- It's already in 2NF
- 对于每个非平凡函数依赖 X → A,X 是超键或 A 属于候选键。在下面的示例中,这消除了非键属性之间的传递依赖关系。
第三范式之前(违反)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
第三范式 (3NF) 之后
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
一个完全规范化的示例
这是一个将产品、客户、地址、订单和订单行分隔开来的电商架构。假设每个列出的标识符决定了其余属性,这些表满足图示的范式。存储的销售价格是历史事实,而不是当前产品价格的副本。
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
将其粘贴到 Erd Go 的编辑器 来查看自动映射所有关系的视觉 ERD。
何时反规范化
虽然规范化通常是良好的实践,但在某些情况下,反规范化可以提高性能:
- 读密集型工作负载 — 如果您的应用程序读取的次数远多于写入次数,则存储计算或重复的数据可以避免昂贵的 JOIN。
- 报表与分析 — 反规范化表或物化视图通常用于仪表板。
- 缓存热数据 — 直接在表中存储经常访问的聚合值。
- NoSQL 风格的访问模式 — 当您的查询始终需要特定数据组合时。
关键在于 先规范化,然后故意反规范化 当性能需要时,记录下做出权衡的原因。