除非另外命名了方言,否则 SQL 示例使用 PostgreSQL。简短的代码片段假定其引用的表已存在。在应用 DDL 之前,请在目标数据库中验证 DDL。
什么是数据库索引?
一个 索引 是数据库引擎维护的数据结构,它提供表行数据的快速查找路径。对于选择性筛选,索引可以减少读取的行数或页数。对于小型表或返回大量行的查询,优化器仍可能选择表扫描。测量计划和计时,而不是假设固定的加速。
B-树索引的工作原理
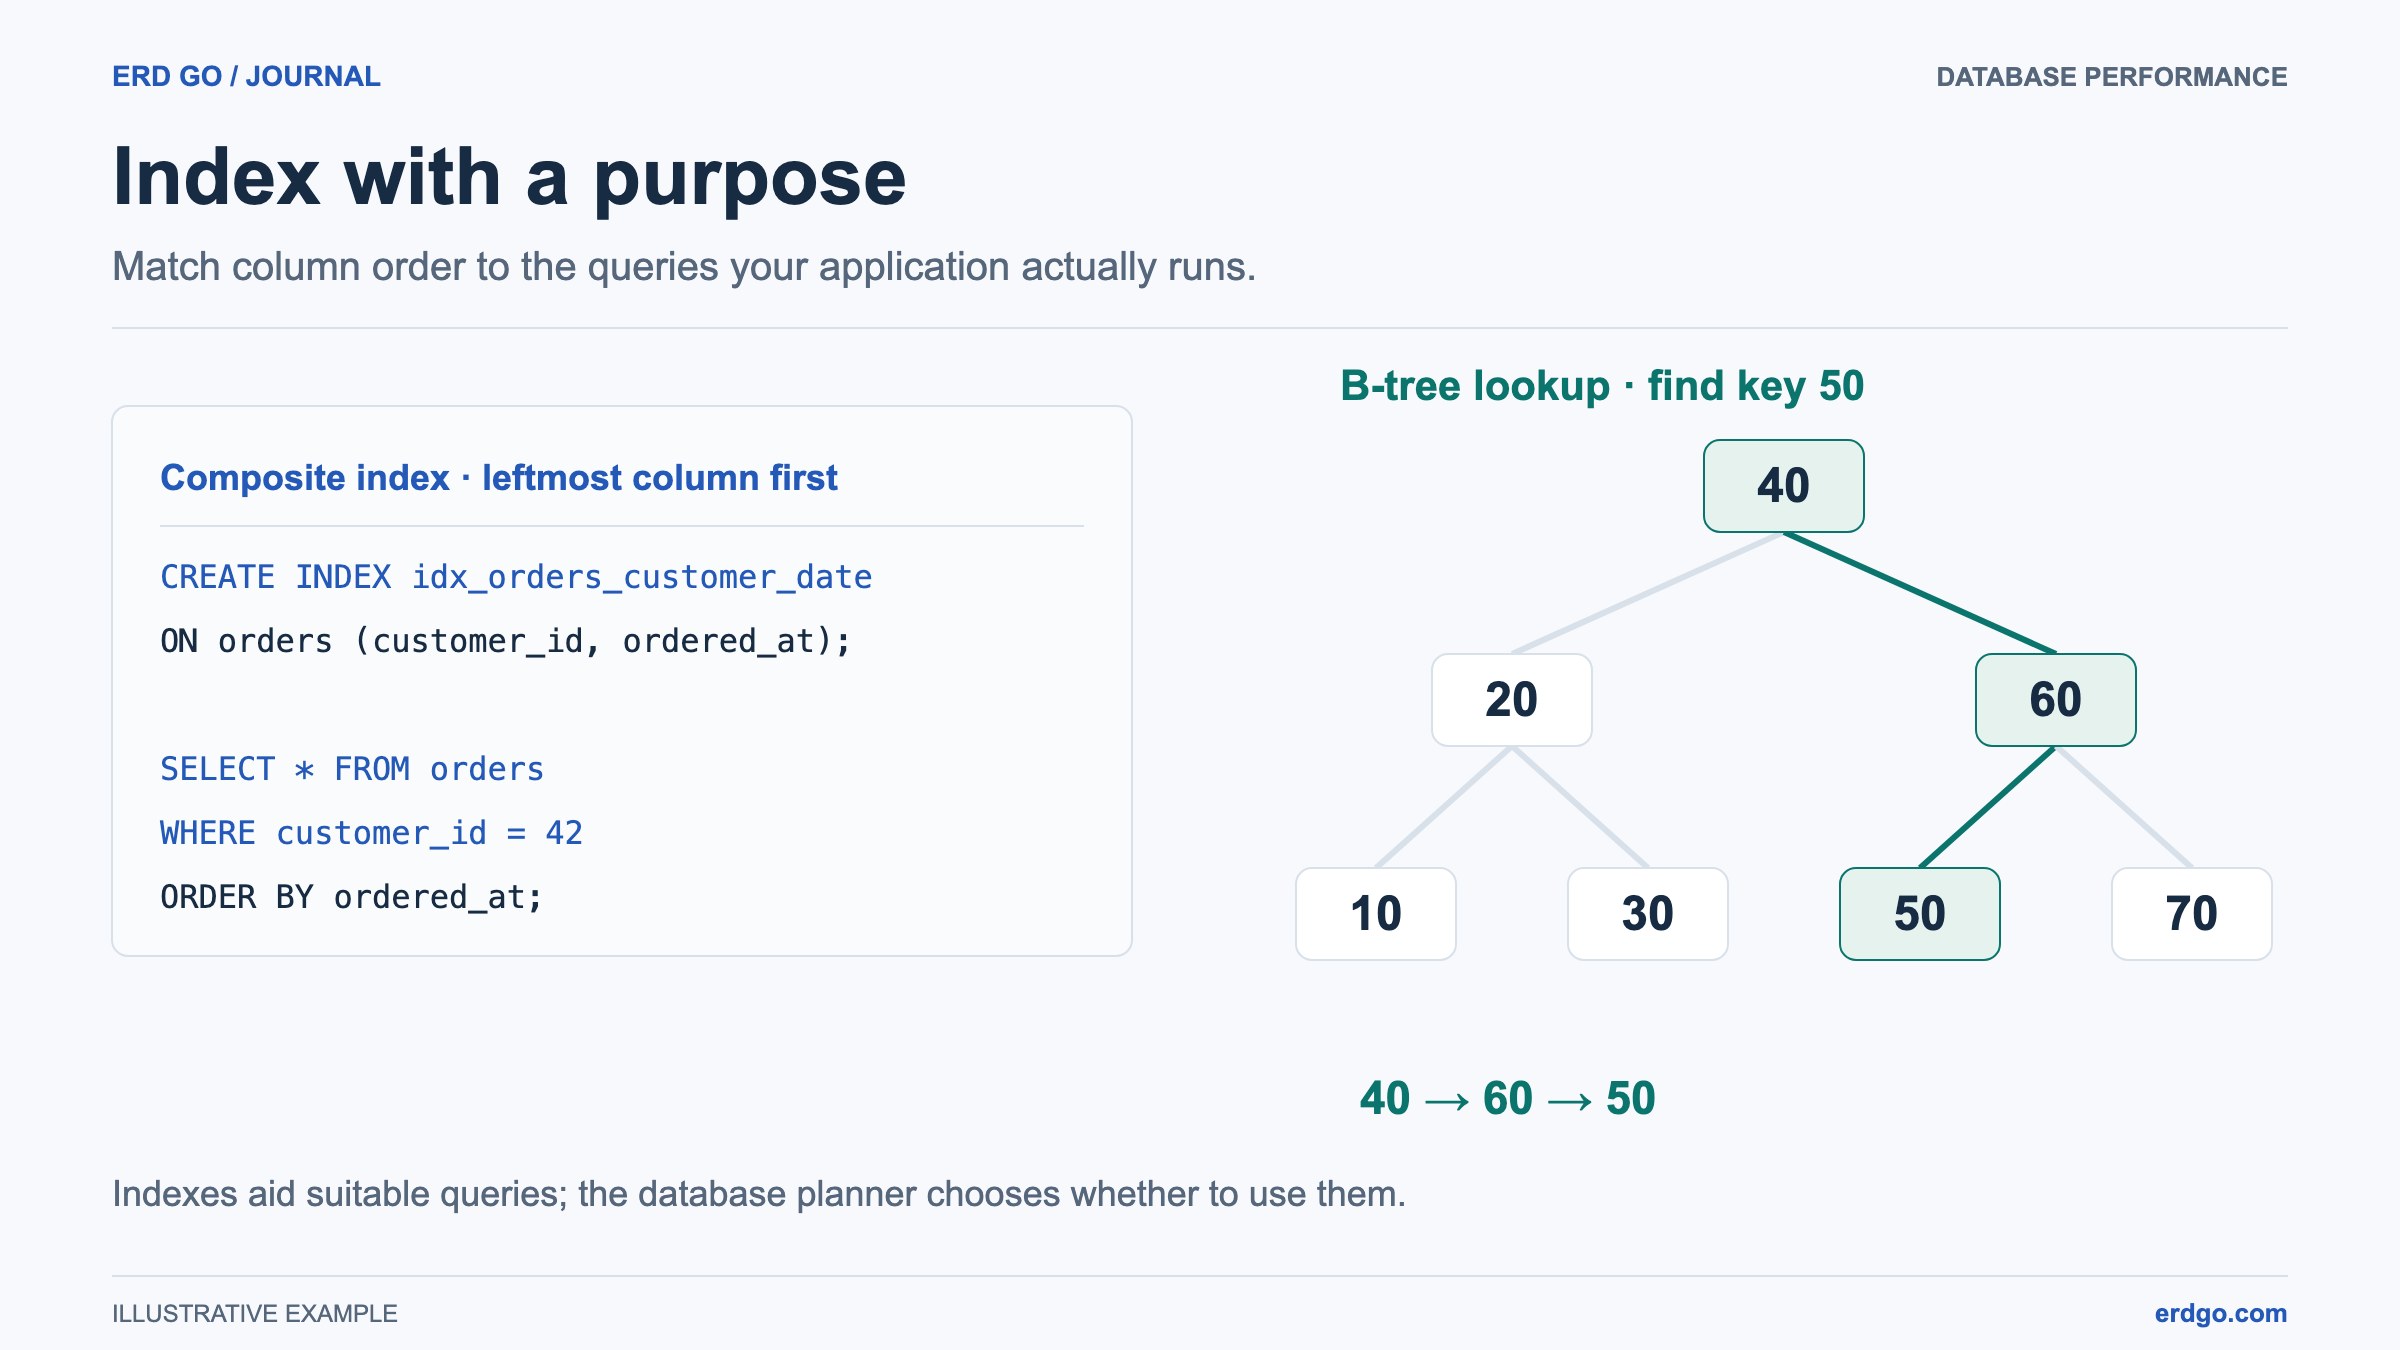
PostgreSQL、MySQL、SQL Server 和 SQLite 中最常见的索引类型是 B-tree (平衡树)。可以把它想象成电话簿:你不需要从 A 到 Z 阅读每一个名字,而是翻到大致的区段,缩小到正确的页面,然后找到条目。B 树的工作原理类似:
- 树被组织成 节点。每个内部节点都包含已排序的键和指向子节点的指针。
- 查找开始于 根, 将搜索值与节点键进行比较,并通过 分支 节点。
- 它达到了 叶子 包含匹配的条目。根据引擎和索引的不同,条目会标识行、包含聚集键或保存行数据本身。
- 树保持平衡,但其深度和 I/O 取决于键宽度、页面大小、行数、缓存以及查询是否也获取表页面。
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
何时应使用索引?
索引并非免费的。它们会消耗磁盘空间,并为每个操作增加开销 INSERT, UPDATE, 以及 DELETE 因为引擎必须保持索引与表数据同步。请有策略地使用它们:
- 列在
WHERE子句。 合适的索引可以帮助频繁的选择性过滤;其益处取决于数据分布和所选计划。 - 列在
JOIN条件。 索引可能有助于外键连接和父级更新或删除;大型连接仍然可能更偏向于扫描。 - 列在
ORDER BY和GROUP BY. 索引可以提供预排序的数据,从而省去代价高昂的排序操作。 - 高基数列。 具有许多不同值(如电子邮箱或 UUID)的列比具有较少不同值的列(如布尔值
is_active标志)。 - 大型表。 拥有 100 行的表很少需要额外的索引。拥有 1000 万行的表几乎肯定需要。
作为一般规则: 在没有额外索引的情况下开始,通过以下方式测量查询性能 EXPLAIN, 然后在数据指向的位置添加索引。
索引的类型
单列索引
最简单的形式。在单列上创建 B 树。非常适合仅基于该列进行筛选或排序的查询。
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
复合(多列)索引
包含两个或多个列的索引。前导列上的等值过滤以及下一列上的范围过滤通常会形成高效的 B 树访问路径。其他条件仍可能使用扫描或跳过扫描;支持和成本因引擎和版本而异。
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
从相等过滤器、范围条件、排序和覆盖需求中选择列顺序。“最严格的先选”并非普遍规则。PostgreSQL 18 可以对合适的非前导过滤器使用 B 树跳跃扫描。
唯一索引
强制执行唯一性约束,同时提供基于索引的查找性能。当您定义以下内容时,大多数数据库会自动创建一个唯一索引: UNIQUE 约束或 PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
部分(过滤)索引
仅对满足以下条件的行建立索引: WHERE 条件。这使索引保持较小且高度针对性。
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
部分或过滤索引可以帮助小型且频繁查询的子集。查询谓词必须暗示过滤器。SQL Server 的过滤语法比 PostgreSQL 的更为受限;请勿在它们之间随意复制谓词。
其他索引类型
| 索引类型 | 最适合 | 数据库支持 |
|---|---|---|
| 哈希 | 精确相等查找(=) | PostgreSQL, MySQL (Memory engine) |
| GIN | 全文搜索、JSONB、数组 | PostgreSQL |
| GiST | 几何和范围数据类型 | PostgreSQL |
| BRIN | 具有自然排序数据的非常大的表 | PostgreSQL |
| 全文 | 文本搜索,带相关性排名 | MySQL, SQL Server |
常见索引错误
即使是有经验的开发者也会陷入这些陷阱。请避免它们以保持良好的数据库性能。
1. 过度索引
在每个列上“以防万一”地添加索引会浪费磁盘空间并减慢写入速度。每次插入、更新和删除时都必须更新每个索引。具有 15 个索引的表的写入吞吐量将明显低于具有 3 个精心挑选的索引的表。
2. 为低基数列建立索引
对布尔值建立索引 is_active 仅包含以下的列 TRUE 和 FALSE 当值高度倾斜或索引覆盖狭窄的查询时会很有用。仅凭基数无法决定索引是否有帮助。如果您必须在此类列上进行过滤,请将它们与具有更高基数的列组合在复合索引中,或者使用部分索引。
3. 忽略查询模式
索引只有在您的实际查询能够利用它时才有用。务必检查应用程序中的慢查询 首先, 然后设计针对这些特定访问模式的索引。
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. 忘记为外键建立索引
在 PostgreSQL 中,外键列是 不 自动建立索引(与 MySQL 的 InnoDB 不同,后者默认在外键上创建索引)。索引有助于选择性连接和引用检查,但优化器可能会选择扫描或哈希连接。在添加另一个索引之前,请检查现有的前导列已经覆盖该外键的索引。
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. 从不审查未使用的索引
随着时间推移,应用程序代码会发生变化,旧的索引可能不再服务于任何查询。未使用的索引仍然会消耗存储空间并减慢写入速度,而没有任何读取收益。
监视索引使用情况
现代数据库提供系统视图,用于报告每个索引的使用频率。定期审查这些视图有助于您删除未使用的索引并发现缺失的索引。
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
将零次读取视为候选审查对象,而不是删除索引的许可。检查计数器何时重置、是否启用了检测工具以及是否需要进行季节性查询、约束或外键检查。使用代表性工作负载测试建议的删除。
架构设计和 ERD 中的索引
虽然 ERD 主要关注表、列和关系,但索引是整个模式设计的重要组成部分。在规划数据库时,请将索引与表定义一起考虑:
- A 主键 通常有一个引擎管理的访问路径。SQLite INTEGER PRIMARY KEY 使用 rowid 而不是单独的唯一索引;在添加重复索引之前检查引擎。
- 审查访问路径以便 外键。PostgreSQL 不会自动创建子侧索引,但现有的复合索引可能已经覆盖了该关系。
- 包含以下列的 唯一约束 接收一个自动的唯一索引。
- 应将针对频繁查询的列的附加索引与您的架构 DDL 一起记录,以免在部署期间被遗忘。
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
通过将 DDL 粘贴到以下位置来可视化您的完整模式—表、关系以及您计划索引的列 Erd Go 编辑器。视觉化地查看结构通常会暴露出需要建立索引的列(如频繁进行 JOIN 的外键),而这些列在阅读原始 SQL 时可能会被您忽略。