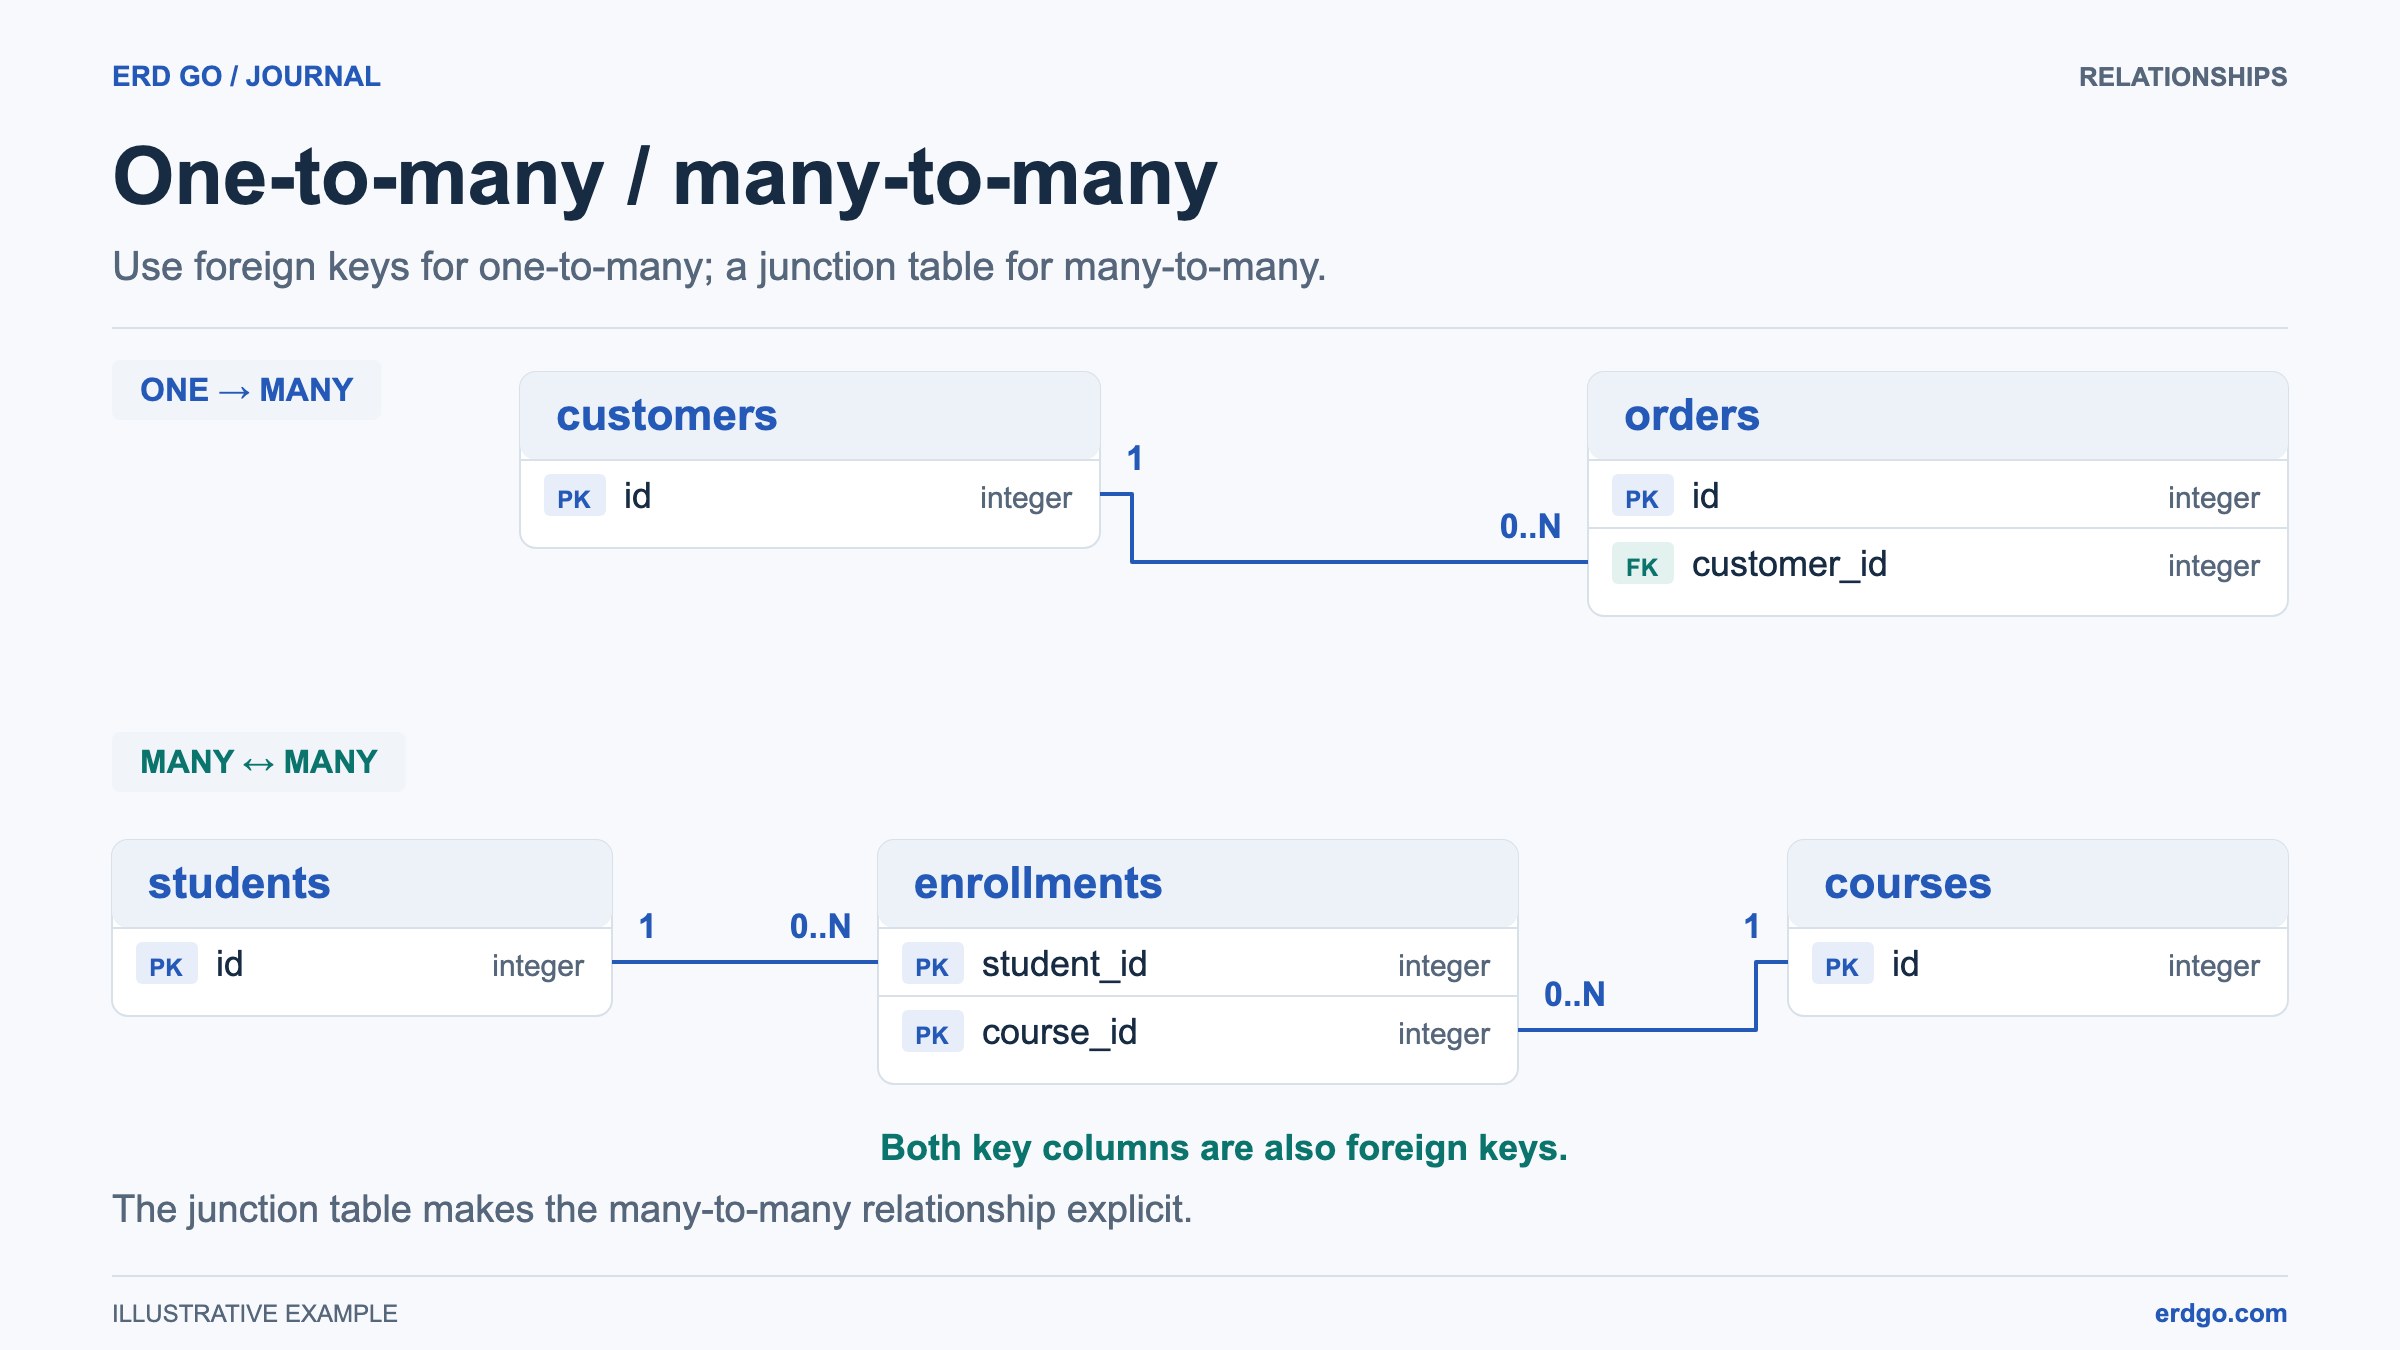
SQL örnekleri, başka bir lehçe belirtilmedikçe PostgreSQL kullanır. Kısa kod parçacıkları, referans verilen tabloların zaten var olduğunu varsayar. DDL'yi uygulamadan önce hedef veritabanınızda doğrulayın.
Veritabanı Normalizasyonu Nedir?
Veritabanı normalizasyonu veri yedekliliğini azaltmak ve veri bütünlüğünü iyileştirmek için ilişkisel bir veritabanını düzenleme sürecidir. 1970'lerde Edgar F. Codd tarafından tanıtılan normalleştirme, büyük tabloları daha küçük, ilişkili tablolara bölmeyi ve aralarındaki ilişkileri tanımlamayı içerir.
Amaç, bağımlılıkları tutarlı bir şekilde temsil etmek ve önlenebilir tekrarları azaltmaktır. Satış fiyatı gibi geçmiş anlık görüntüler, farklı gerçekleri temsil ettikleri için farklı bir tabloya ait olabilirler.
Neden Normalleştirme Yapılmalı?
- Yedekliliği ortadan kaldırın — Aynı veriyi birden fazla yerde saklamaktan kaçının.
- Güncelleme anomalilerini önleyin — Verilerdeki değişikliklerin yalnızca tek bir yerde yapılması gerekir.
- Ekleme anomalilerini önleyin — İlişkisiz verileri gerektirmeden yeni veriler ekleyebilirsiniz.
- Silme anomalilerini önleyin — Bir kaydı silmek, ilişkisiz verileri yanlışlıkla kaldırmaz.
- Sürdürülebilir sorguları destekleyin — Net bağımlılıklar, sorguların mantığını anlamayı kolaylaştırır. Performans erişim modellerine, dizinlere ve birleştirmelere (join) bağlıdır; normalleştirme tek başına bir sorguyu hızlandırmaz.
Birinci Normal Form (1NF)
Bir tablo şunun içinde: 1NF şu durumlarda:
- Her sütun yalnızca atomik (bölünemez) değerler içerir
- Her sütun tek bir türden değerler içerir
- Satırlar bir aday anahtar ile ayırt edilebilir; SQL'de seçilen bir tanımlayıcıyı zorunlu kılmak için bir birincil anahtar bildirin
- Tekrarlayan gruplar veya diziler yoktur.
1NF öncesi (İhlal ediyor)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
1NF'den sonra
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
İkinci Normal Form (2NF)
Bir tablo şunun içinde: 2NF şu durumlarda:
- Zaten 1NF'de
- Her asal olmayan öznitelik şuna bağlıdır: tamamı aday anahtar, bir anahtarın yalnızca bir kısmına bağımlılığı olmayan
Aday anahtar, bir satırı benzersiz şekilde tanımlayan minimal bir öznitelik kümesidir. Herhangi bir aday anahtarda görünen öznitelikler asal özniteliklerdir. Kısmi bağımlılıklar, bir aday anahtar birkaç sütun içerdiğinde önemlidir; aday anahtarlar yalnızca seçilen birincil anahtarı değil, alternatif benzersiz tanımlayıcıları da içerir. Anahtar olmayan bir sütun anahtarın yalnızca bir kısmına bağlıysa, ayrı bir tabloya taşınmalıdır.
2NF öncesi (İhlal ediyor)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
2NF'den sonra
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Üçüncü Normal Form (3NF)
Bir tablo şunun içinde: 3NF şu durumlarda:
- Zaten 2NF'de
- Önemsiz olmayan her X → A fonksiyonel bağımlılığı için, X bir süper anahtardır veya A bir aday anahtara aittir. Aşağıdaki örneklerde bu, anahtar olmayan öznitelikler arasındaki geçişli bağımlılıkları kaldırır.
3NF öncesi (İhlal ediyor)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
3NF'den sonra
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Tam Bir Normalleştirilmiş Örnek
İşte ürünleri, müşterileri, adresleri, siparişleri ve sipariş satırlarını ayıran bir e-ticaret şeması. Listelenen her tanımlayıcının kalan öznitelikleri belirlediği varsayıldığında, bu tablolar gösterilen normal formları karşılar. Kaydedilen satış fiyatları, mevcut ürün fiyatının kopyaları değil, tarihsel gerçeklerdir.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Bunu şuraya yapıştırın: Erd Go'nun düzenleyicisi tüm ilişkileri otomatik olarak haritalandırılmış görsel ERD'yi görmek için.
Ne Zaman Normalleştirmeyi Bozmalı (Denormalize)
Normalleştirme genellikle iyi bir uygulama olsa da, normalleştirmeyi bozmanın (denormalization) performansı artırdığı durumlar vardır:
- Okuma ağırlıklı iş yükleri — Uygulamanız yazdığından çok daha fazlasını okuyorsa, hesaplanmış veya çoğaltılmış verileri saklamak pahalı JOIN işlemlerinden kaçınabilir.
- Raporlama ve analitik — Normalleştirilmemiş tablolar veya somutlaştırılmış görünümler genellikle panolar (dashboard) için kullanılır.
- Sıcak verileri önbelleğe alma — Sık erişilen toplu değerleri doğrudan bir tabloda saklamak.
- NoSQL tarzı erişim modelleri — Sorgularınız her zaman belirli bir veri kombinasyonuna ihtiyaç duyduğunda.
Buradaki anahtar nokta şudur: önce normalleştirin, sonra kasıtlı olarak normalleştirmeyi kaldırın performansın gerektirdiği durumlarda, ödünleşimin neden yapıldığını belgeleyerek.