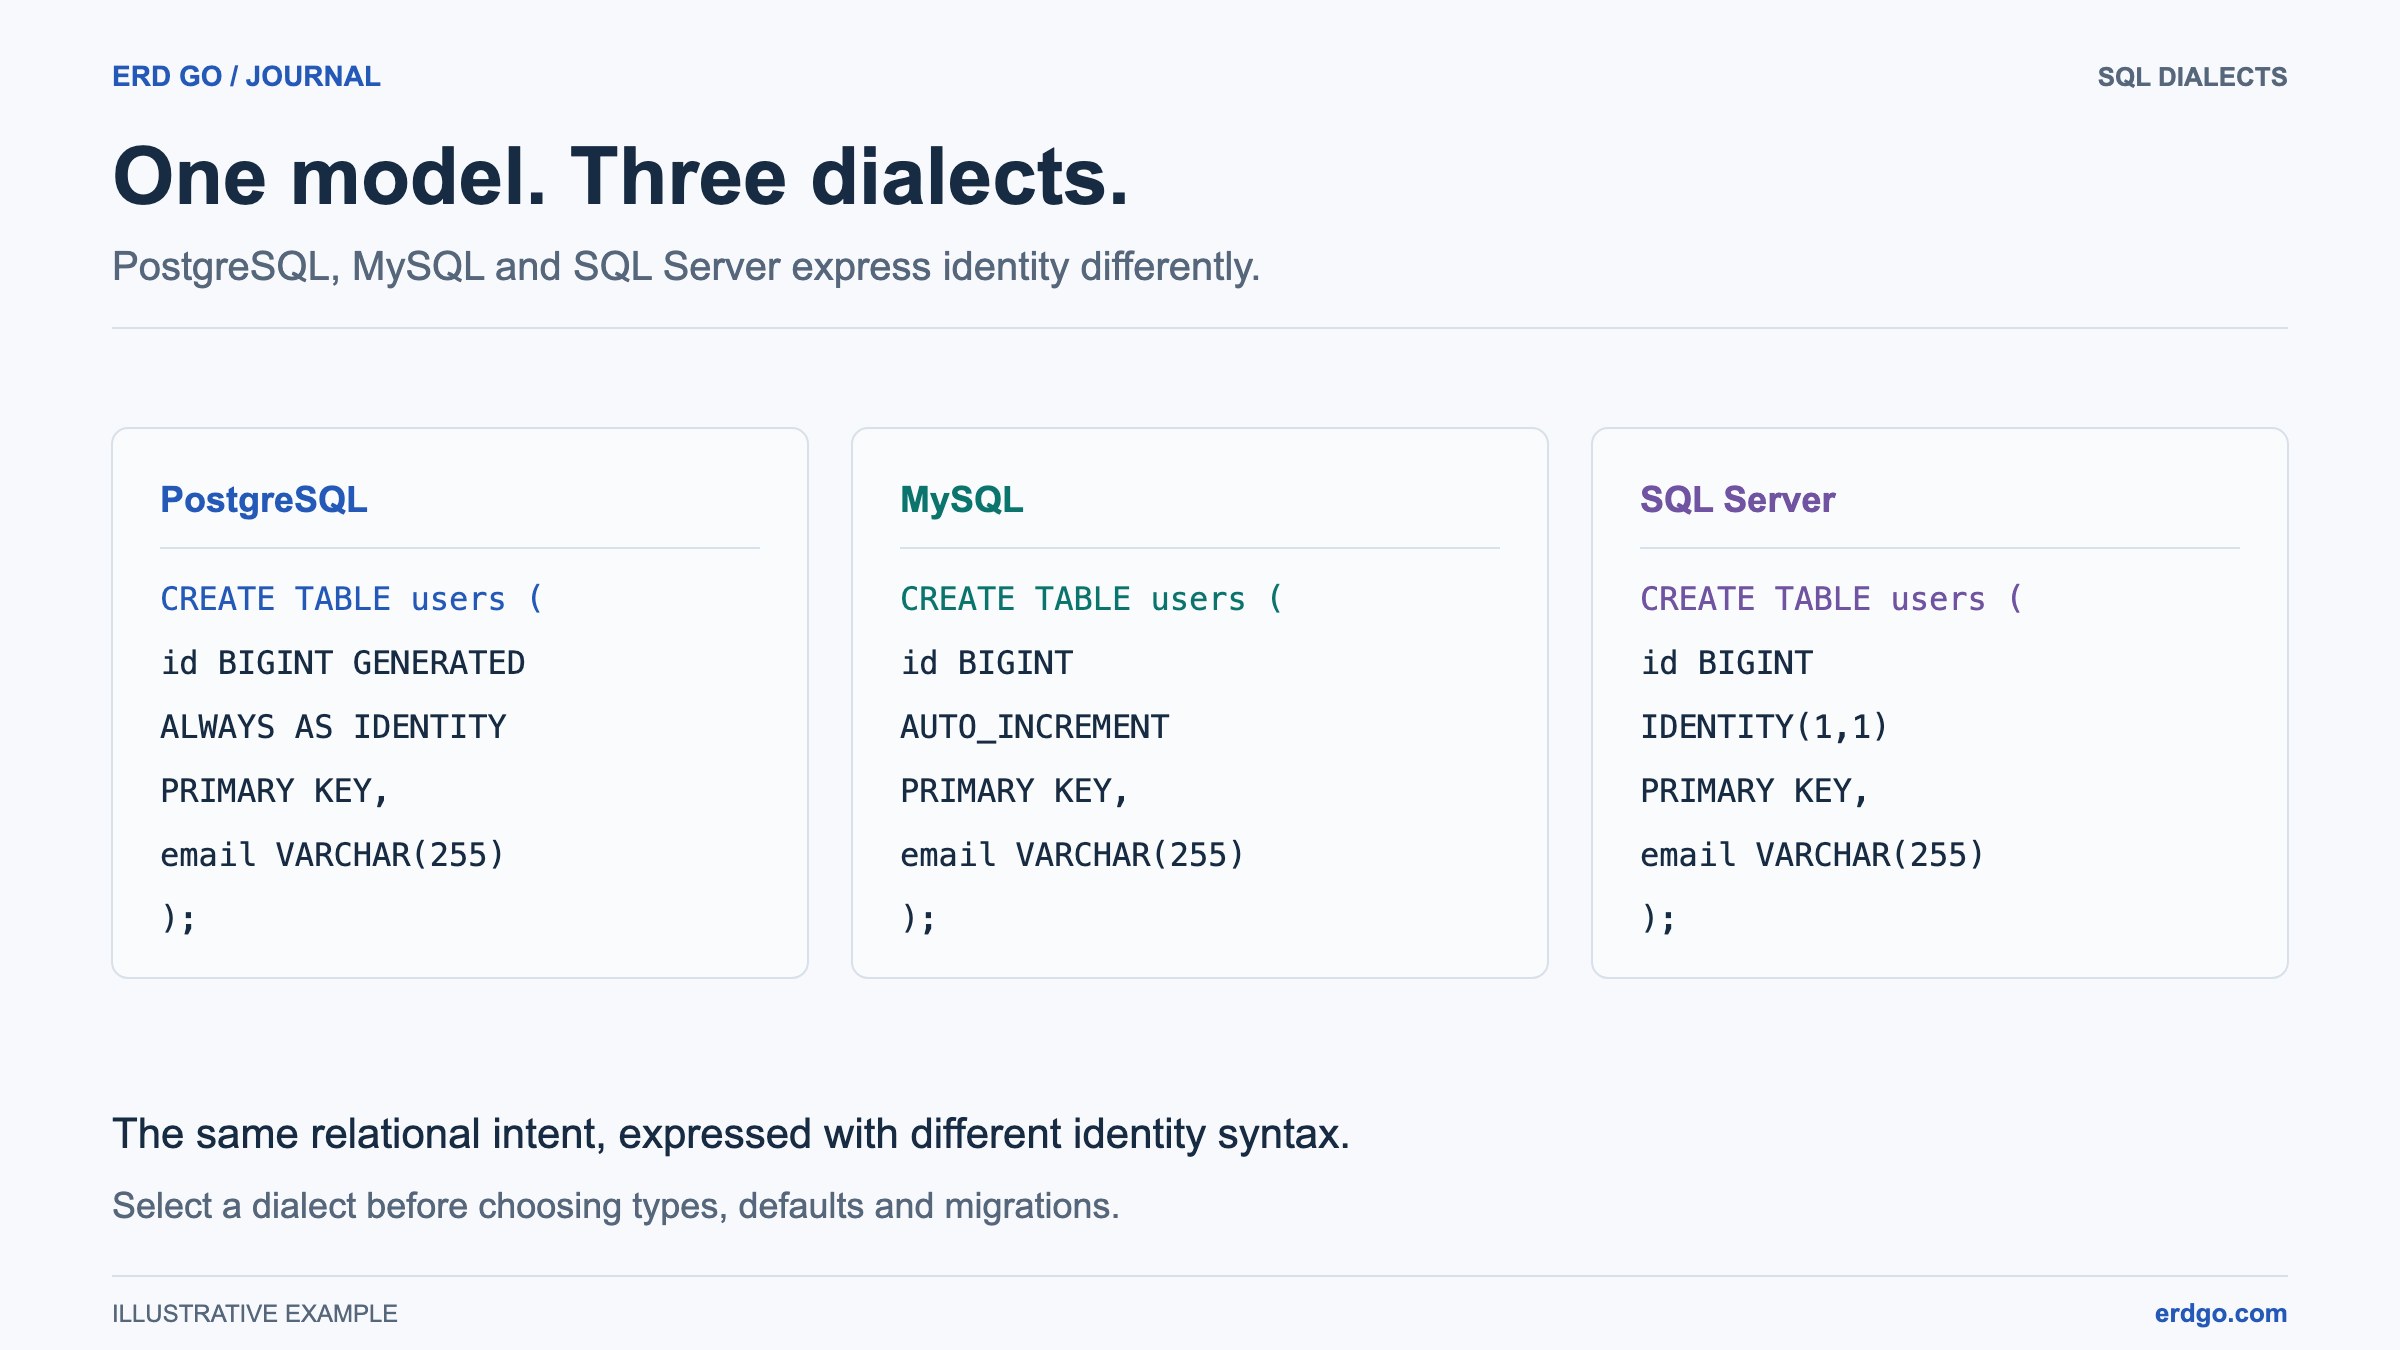
SQL örnekleri, başka bir lehçe belirtilmedikçe PostgreSQL kullanır. Kısa kod parçacıkları, referans verilen tabloların zaten var olduğunu varsayar. DDL'yi uygulamadan önce hedef veritabanınızda doğrulayın.
Veritabanı İndeksleri Nedir?
Bir dizin veritabanı motoru tarafından sürdürülen ve bir tablodaki satırlara hızlı bir arama yolu sağlayan bir veri yapısıdır. Seçici filtreler için bir dizin, okunan satır veya sayfa sayısını azaltabilir. İyileştirici, küçük tablolar veya çok sayıda satır döndüren sorgular için yine de bir tablo taramasını seçebilir. Sabit bir hız artışı varsaymak yerine planı ve zamanlamayı ölçün.
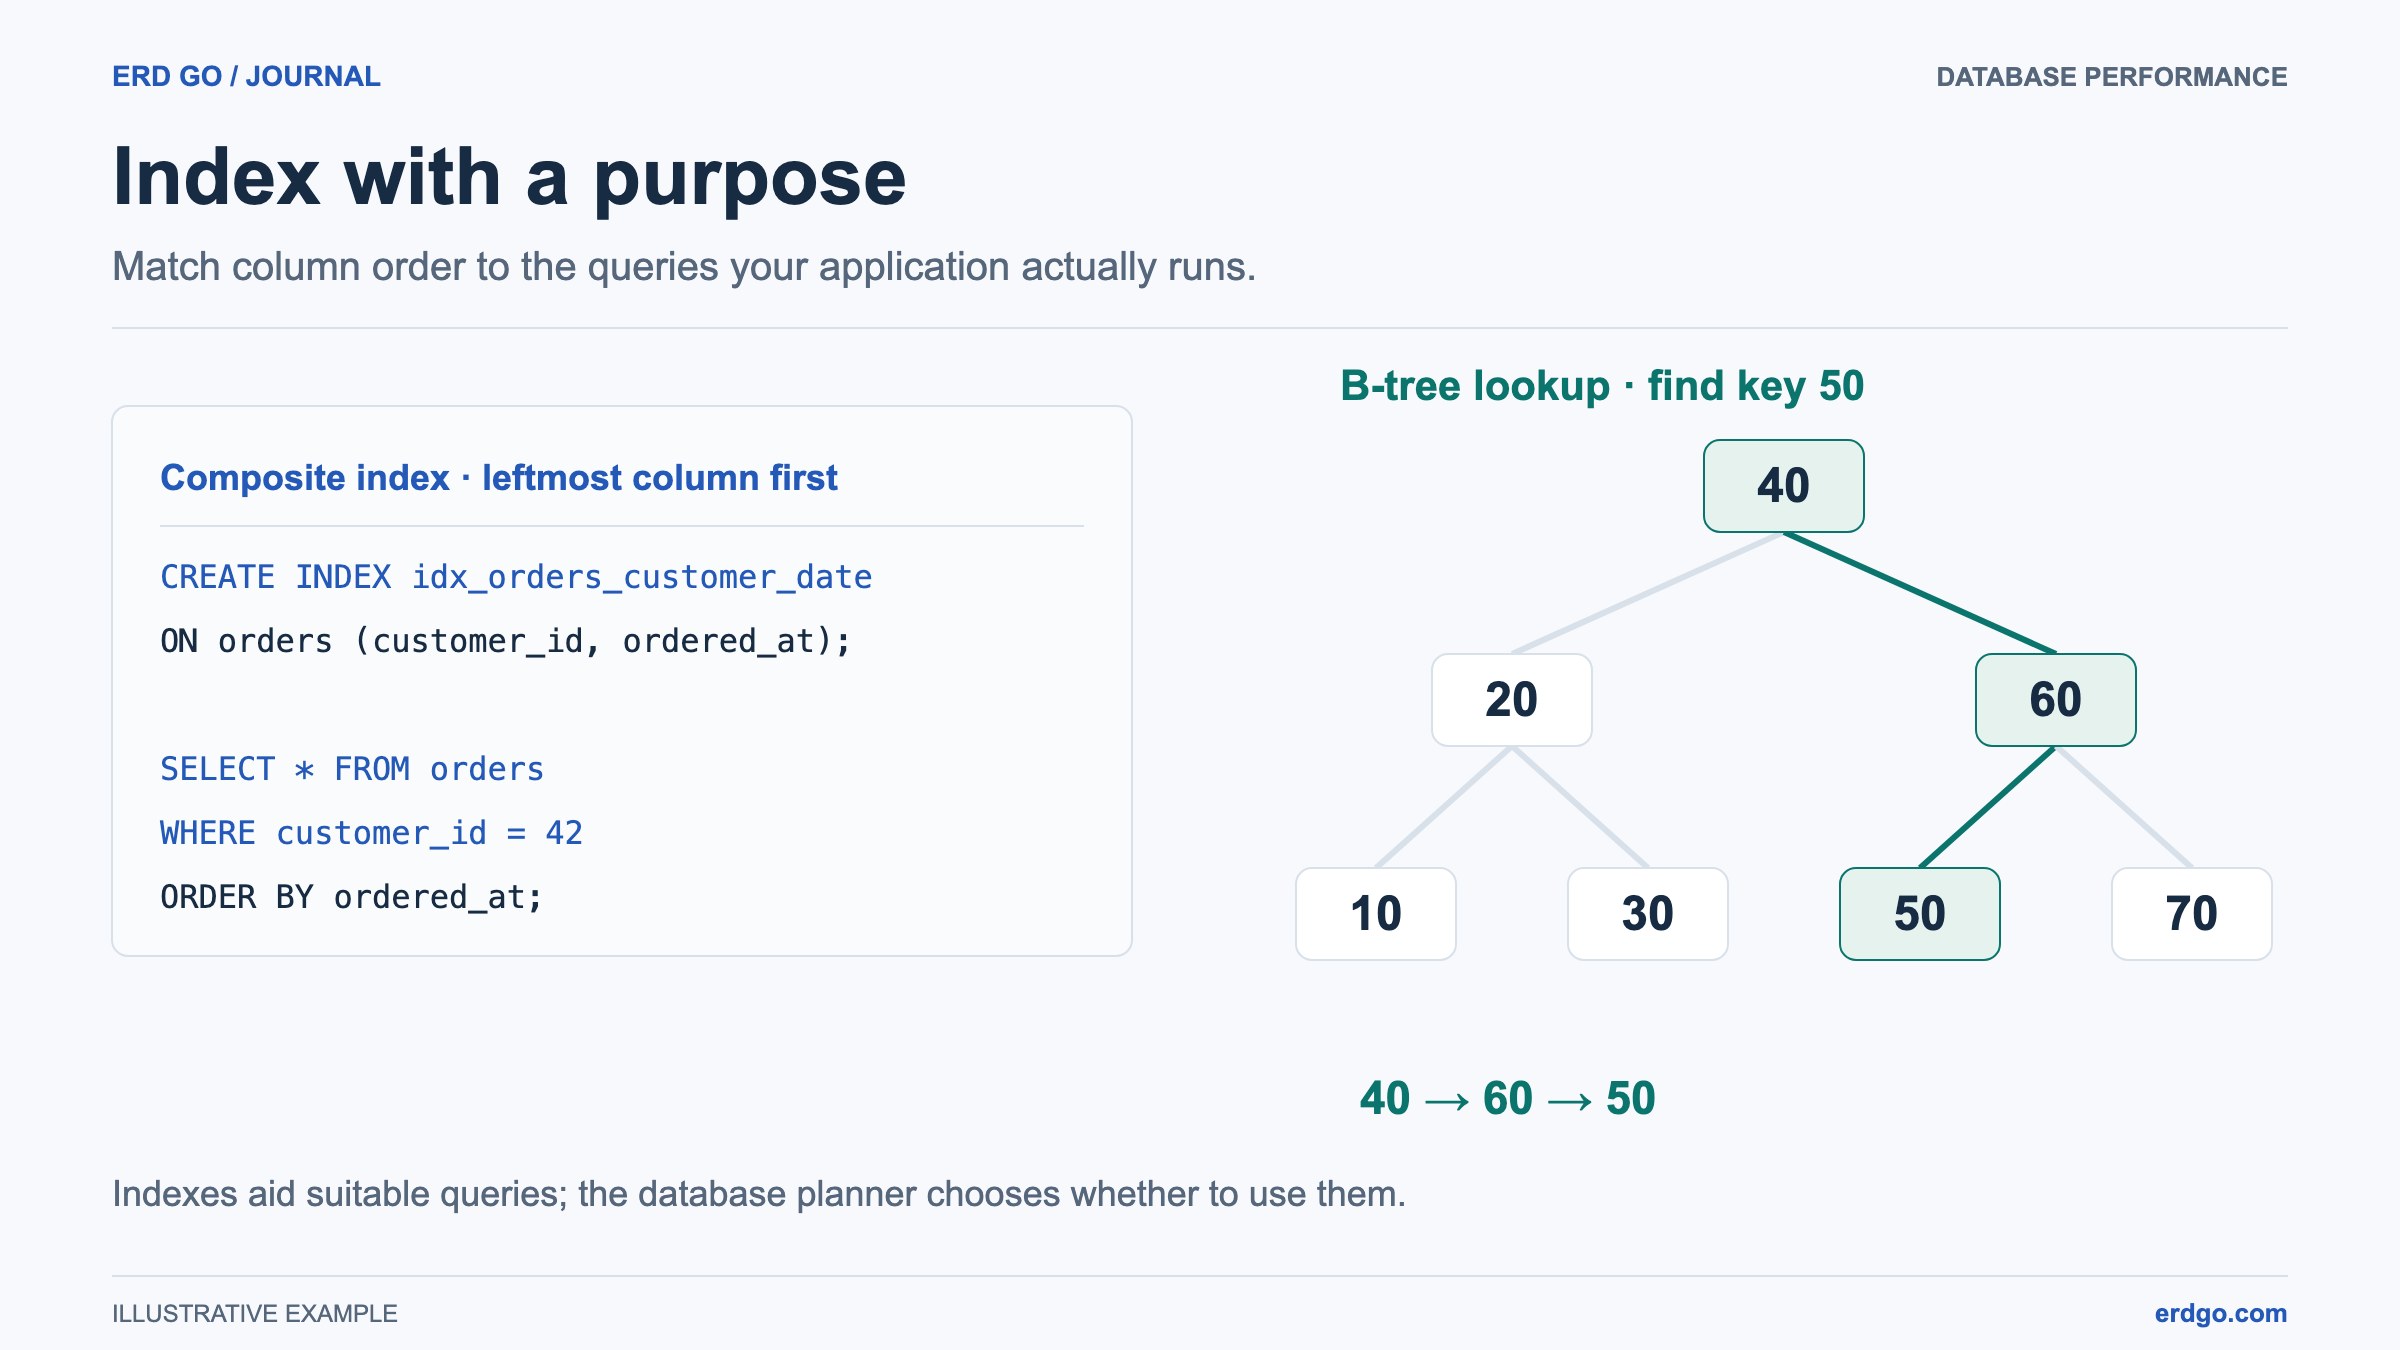
B-Tree İndeksleri Nasıl Çalışır
PostgreSQL, MySQL, SQL Server ve SQLite genelinde en yaygın dizin türü şudur: B-tree (dengeli ağaç). Bunu bir telefon rehberi gibi düşünün: Her ismi A'dan Z'ye okumak yerine, yaklaşık bölüme açar, doğru sayfaya daraltır ve girişe ulaşırsınız. Bir B-ağacı benzer şekilde çalışır:
- Ağaç şuna göre düzenlenmiştir: düğümler. Her iç düğüm, sıralanmış anahtarlar ve alt düğümlere işaretçiler içerir.
- Bir arama şurada başlar: kök, arama değerini düğüm anahtarlarıyla karşılaştırır ve doğru işaretçiyi aşağıya doğru takip eder dal düğümler.
- Şuna ulaşır: yaprak eşleşen girişleri içeren. Motora ve indekse bağlı olarak, girişler satırları tanımlar, kümelenmiş bir anahtar içerir veya satır verisinin kendisini tutar.
- Ağaç dengeli kalır, ancak derinliği ve G/Ç performansı anahtar genişliğine, sayfa boyutuna, satır sayısına, önbelleğe almaya ve sorgunun tablo sayfalarını da getirip getirmediğine bağlıdır.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
İndeksleri Ne Zaman Kullanmalısınız?
Dizinler bedava değildir. Disk alanı tüketirler ve her birine ek yük getirirler INSERT, UPDATE, ve DELETE çünkü motor, indeksi tablo verileriyle senkronize tutmalıdır. Bunları stratejik olarak kullanın:
- İçindeki sütunlar
WHEREyan tümceleri. Uygun bir dizin, sık kullanılan seçici bir filtre için yardımcı olabilir; faydası veri dağılımına ve seçilen plana bağlıdır. - İçindeki sütunlar
JOINkoşullar. Dizinler yabancı anahtar birleşimlerine ve üst öğe güncellemelerine veya silmelerine yardımcı olabilir; büyük bir birleşim yine de taramayı tercih edebilir. - İçindeki sütunlar
ORDER BYveGROUP BY. Bir dizin, önceden sıralanmış veriler sağlayarak maliyetli bir sıralama işlemini ortadan kaldırabilir. - Yüksek kardinaliteli sütunlar. Birçok farklı değere sahip sütunlar (e-posta veya UUID gibi), az sayıda farklı değere sahip sütunlardan (boole gibi) daha fazla fayda sağlar
is_activebayrağı). - Büyük tablolar. 100 satırlık bir tablonun nadiren ek dizinlere ihtiyacı olur. 10 milyon satırlık bir tablonun ise neredeyse kesinlikle ihtiyacı vardır.
Genel bir kural olarak: ek dizinler olmadan başlayın, sorgu performansını şununla ölçün EXPLAIN, ardından verilerin size söylediği yere dizinler ekleyin.
İndeks türleri
Tek Sütunlu Dizin
En basit biçimdir. Tek bir sütun üzerinde B-tree oluşturur. Yalnızca o sütuna göre filtreleme veya sıralama yapan sorgular için idealdir.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Bileşik (Çok Sütunlu) Dizin
İki veya daha fazla sütun üzerinde bir dizin. Önde gelen sütunlarda eşitlik filtreleri ve sonrakinde bir aralık genellikle verimli bir B-tree erişim yolu oluşturur. Diğer koşullar yine de bir tarama veya atlama taraması kullanabilir; destek ve maliyet motora ve sürüme göre değişir.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Eşitlik filtrelerinden, aralık koşullarından, sıralamadan ve kapsama ihtiyaçlarından sütun sırasını seçin. “En seçici olan önce” evrensel bir kural değildir. PostgreSQL 18, uygun lider olmayan filtreler için B-tree atlama taramalarını kullanabilir.
Benzersiz İndeks
Bir benzersizlik kısıtlamasını zorunlu kılarken aynı zamanda dizin tabanlı arama performansı sağlar. Çoğu veritabanı, bir tanımladığınızda otomatik olarak benzersiz bir dizin oluşturur UNIQUE kısıtlama veya PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Kısmi (Filtrelenmiş) İndeks
Yalnızca şunu karşılayan satırları dizinler: WHERE koşul. Bu, indeksi küçük ve oldukça hedefe yönelik tutar.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Kısmi veya filtrelenmiş bir dizin, küçük ve sık sorgulanan bir alt küme için yardımcı olabilir. Sorgu yüklemi filtreyi ima etmelidir. SQL Server'ın filtre sözdizimi PostgreSQL'inkinden daha kısıtlıdır; bunlar arasında rastgele yüklemler kopyalamayın.
Diğer Dizin Türleri
| Dizin Türü | En Uygun Olduğu Yer | Veritabanı Desteği |
|---|---|---|
| Hash | Tam eşitlik aramaları (=) | PostgreSQL, MySQL (Bellek motoru) |
| GIN | Tam metin arama, JSONB, diziler | PostgreSQL |
| GiST | Geometrik ve aralık veri türleri | PostgreSQL |
| BRIN | Doğal olarak sıralanmış verilere sahip çok büyük tablolar | PostgreSQL |
| Tam Metin | Alaka düzeyi sıralamalı metin arama | MySQL, SQL Server |
Yaygın İndeksleme Hataları
Deneyimli geliştiriciler bile bu tuzaklara düşer. Veritabanınızın iyi performans göstermesini sağlamak için bunlardan kaçının.
1. Aşırı Dizinleme
Her sütuna “ne olur ne olmaz” diye indeks eklemek disk alanını boşa harcar ve yazma işlemlerini yavaşlatır. Her indeksin her ekleme, güncelleme ve silme işleminde güncellenmesi gerekir. 15 indeksi olan bir tablo, iyi seçilmiş 3 indeksi olan bir tabloya göre önemli ölçüde daha yavaş yazma verimine sahip olacaktır.
2. Düşük Kardinaliteli Sütunları Dizinleme
Boolean dizinleme is_active yalnızca şunu içeren sütun TRUE ve FALSE değerler oldukça çarpık olduğunda veya indeks dar bir sorguyu kapsadığında yararlı olabilir. Yalnızca kardinalite, bir indeksin yardımcı olup olmayacağına karar vermez. Bu tür sütunlarda filtreleme yapmanız gerekiyorsa, bunları daha yüksek kardinaliteli bir sütunla bileşik bir indekste birleştirin veya kısmi bir indeks kullanın.
3. Sorgu Modellerini Göz Ardı Etme
Bir dizin yalnızca gerçek sorgularınız ondan yararlanabiliyorsa kullanışlıdır. Uygulamanızdaki yavaş sorguları her zaman inceleyin ilk, ardından bu belirli erişim modellerini hedefleyen dizinler tasarlayın.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Yabancı Anahtarları Dizinlemeyi Unutmak
PostgreSQL'de, yabancı anahtar sütunları değil otomatik olarak indekslenir (varsayılan olarak yabancı anahtarlar üzerinde bir indeks oluşturan MySQL'in InnoDB'sinin aksine). Bir indeks, seçici birleştirmelere ve referans kontrollerine yardımcı olabilir, ancak iyileştirici bir tarama veya karma birleştirme seçebilir. Başka bir indeks eklemeden önce, önde gelen sütunları yabancı anahtarı zaten kapsayan mevcut bir indeks olup olmadığını kontrol edin.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Kullanılmayan Dizinleri Asla İncelememek
Zamanla uygulama kodu değişir ve eski indeksler artık hiçbir sorguya hizmet etmeyebilir. Kullanılmayan indeksler depolama alanı tüketmeye devam eder ve sıfır okuma faydası için yazma işlemlerini yavaşlatır.
Dizin Kullanımını İzleme
Modern veritabanları, her dizinin ne sıklıkla kullanıldığını bildiren sistem görünümleri sağlar. Bunları düzenli olarak gözden geçirmek, kullanılmayan dizinleri bırakmanıza ve eksik olanları tespit etmenize yardımcı olur.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Sıfır okumayı bir dizini bırakma izni olarak değil, bir inceleme adayı olarak değerlendirin. Sayaçların ne zaman sıfırlandığını, enstrümantasyonun etkin olup olmadığını ve mevsimsel sorguların, kısıtlamaların veya yabancı anahtar kontrollerinin buna ihtiyacı olup olmadığını kontrol edin. Önerilen bir kaldırma işlemini temsili bir iş yüküyle test edin.
Şema Tasarımı ve ERD'lerde Dizinler
ERD'ler öncelikle tablolara, sütunlara ve ilişkilere odaklansa da, indeksler genel şema tasarımının önemli bir parçasıdır. Veritabanınızı planlarken, tablo tanımlarınızın yanı sıra indeksleri de göz önünde bulundurun:
- A birincil anahtar normalde motor tarafından yönetilen bir erişim yoluna sahiptir. SQLite INTEGER PRIMARY KEY, ayrı bir benzersiz dizin yerine rowid kullanır; yinelenen bir dizin eklemeden önce motoru kontrol edin.
- Şunun için erişim yollarını gözden geçirin: yabancı anahtarlar. PostgreSQL alt tablo tarafındaki dizinleri otomatik olarak oluşturmaz, ancak mevcut bir bileşik dizin ilişkiyi zaten kapsıyor olabilir.
- Şu sütunlara sahip UNIQUE kısıtlamaları otomatik benzersiz dizin alır.
- Sık sorgulanan sütunlar için ek indeksler, dağıtım sırasında unutulmamaları için şema DDL'nizle birlikte belgelenmelidir.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
DDL'nizi şuraya yapıştırarak tüm şemanızı (tablolar, ilişkiler ve indekslemeyi planladığınız sütunlar) görselleştirin: Erd Go düzenleyici. Yapıyı görsel olarak görmek, genellikle ham SQL okurken gözden kaçırabileceğiniz dizinlenmesi gereken sütunları (sıkça birleştirilen yabancı anahtarlar gibi) ortaya çıkarır.