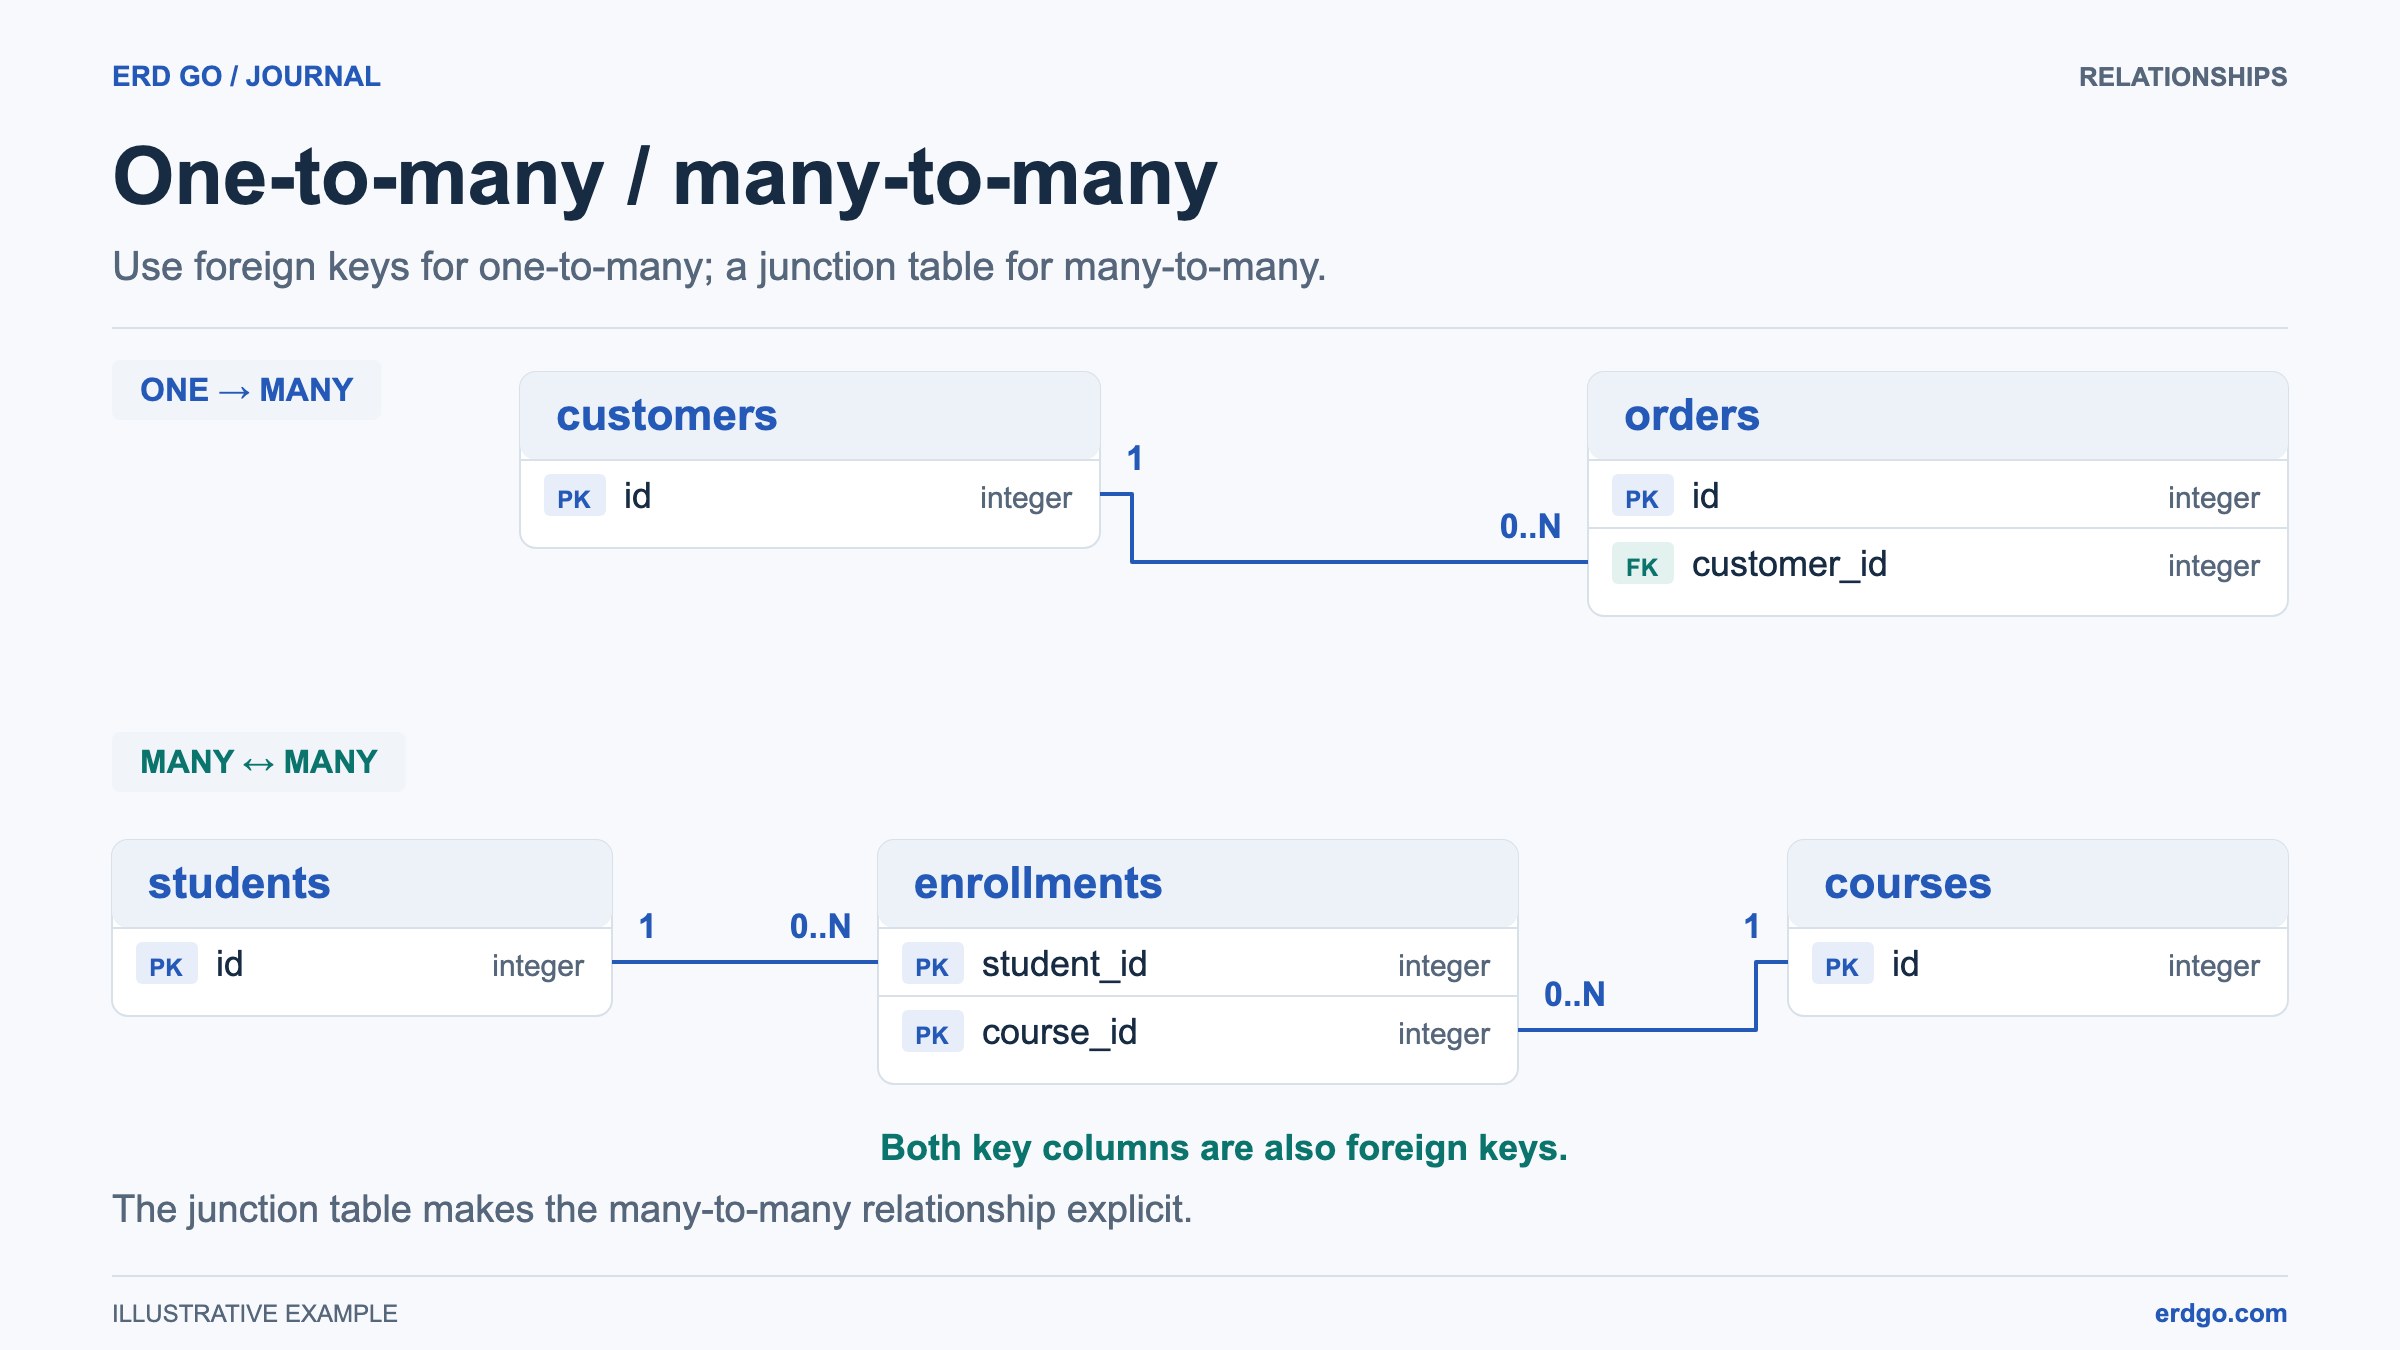
ตัวอย่าง SQL จะใช้ PostgreSQL เว้นแต่จะระบุภาษาอื่นไว้ ตัวอย่างสั้นๆ สมมติว่าตารางที่อ้างถึงมีอยู่แล้ว โปรดตรวจสอบความถูกต้องของ DDL ในฐานข้อมูลเป้าหมายของคุณก่อนนำไปใช้งาน
การทำให้ฐานข้อมูลเป็นบรรทัดฐาน (Normalization) คืออะไร?
การทำให้ฐานข้อมูลเป็นบรรทัดฐาน (Normalization) คือกระบวนการจัดระเบียบฐานข้อมูลเชิงสัมพันธ์เพื่อลดความซ้ำซ้อนของข้อมูลและปรับปรุงความสมบูรณ์ของข้อมูล การทำให้เป็นบรรทัดฐาน (Normalization) ถูกนำเสนอโดย Edgar F. Codd ในช่วงทศวรรษ 1970 เกี่ยวข้องกับการแบ่งตารางขนาดใหญ่เป็นตารางขนาดเล็กที่สัมพันธ์กันและกำหนดความสัมพันธ์ระหว่างตารางเหล่านั้น
เป้าหมายคือการแสดงการพึ่งพาอย่างสม่ำเสมอและลดการทำซ้ำที่หลีกเลี่ยงได้ ภาพรวมทางประวัติศาสตร์ เช่น ราคาขาย อาจอยู่ในตารางที่แตกต่างกันเนื่องจากแสดงถึงข้อเท็จจริงที่แตกต่างกัน
ทำไมต้องทำ Normalization?
- กำจัดความซ้ำซ้อน — หลีกเลี่ยงการจัดเก็บข้อมูลเดียวกันในหลายที่
- ป้องกันความผิดปกติในการอัปเดต — การเปลี่ยนแปลงข้อมูลจำเป็นต้องเกิดขึ้นในที่เดียวเท่านั้น
- ป้องกันความผิดปกติในการแทรก — คุณสามารถเพิ่มข้อมูลใหม่ได้โดยไม่ต้องใช้ข้อมูลที่ไม่เกี่ยวข้อง
- ป้องกันความผิดปกติในการลบ — การลบเรกคอร์ดจะไม่ลบข้อมูลที่ไม่เกี่ยวข้องโดยไม่ได้ตั้งใจ
- สนับสนุนคิวรีที่ดูแลรักษาได้ — การพึ่งพาที่ชัดเจนทำให้คิวรีเข้าใจได้ง่ายขึ้น ประสิทธิภาพขึ้นอยู่กับรูปแบบการเข้าถึง, ดัชนี และการเชื่อมต่อ (joins); การทำ normalization เพียงอย่างเดียวไม่ได้ทำให้คิวรีเร็วขึ้น
รูปแบบบรรทัดฐานที่หนึ่ง (1NF)
ตารางอยู่ใน 1NF เมื่อ:
- แต่ละคอลัมน์ประกอบด้วยค่าอะตอม (ไม่สามารถแบ่งแยกได้) เท่านั้น
- แต่ละคอลัมน์ประกอบด้วยค่าของประเภทเดียว
- แถวสามารถแยกแยะได้ด้วยคีย์ผู้สมัคร; ประกาศคีย์หลักเพื่อบังคับใช้ตัวระบุที่เลือกใน SQL
- ไม่มีกลุ่มหรืออาร์เรย์ที่ซ้ำกัน
ก่อน 1NF (ละเมิดกฎ)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
หลัง 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
รูปแบบบรรทัดฐานที่สอง (2NF)
ตารางอยู่ใน 2NF เมื่อ:
- มันอยู่ใน 1NF แล้ว
- แอตทริบิวต์ที่ไม่ใช่คีย์หลักทุกตัวขึ้นอยู่กับแต่ละ ทั้งหมด คีย์ผู้สมัคร โดยไม่มีการขึ้นต่อกันกับเพียงบางส่วนของคีย์
Candidate key คือชุดของแอตทริบิวต์ที่น้อยที่สุดที่ระบุแถวได้อย่างเฉพาะเจาะจง แอตทริบิวต์ที่ปรากฏใน Candidate key ใดๆ คือ Prime attribute การพึ่งพาบางส่วน (Partial dependencies) จะมีความสำคัญเมื่อ Candidate key ประกอบด้วยหลายคอลัมน์ Candidate key รวมถึงตัวระบุที่ไม่ซ้ำกันอื่นๆ ไม่ใช่แค่คีย์หลักที่เลือกไว้เท่านั้น หากคอลัมน์ที่ไม่ใช่คีย์ขึ้นอยู่กับเพียงบางส่วนของคีย์ ควรย้ายคอลัมน์นั้นไปยังตารางแยกต่างหาก
ก่อน 2NF (ละเมิดกฎ)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
หลัง 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
รูปแบบบรรทัดฐานขั้นที่ 3 (3NF)
ตารางอยู่ใน 3NF เมื่อ:
- มันอยู่ใน 2NF แล้ว
- สำหรับแต่ละการพึ่งพาเชิงฟังก์ชันที่ไม่สำคัญ X → A, X คือ superkey หรือ A เป็นของ candidate key ในตัวอย่างด้านล่าง สิ่งนี้จะลบการพึ่งพาแบบสกรรมกริยาระหว่างแอตทริบิวต์ที่ไม่ใช่คีย์
ก่อน 3NF (ละเมิดกฎ)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
หลัง 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
ตัวอย่างการทำ Normalization ที่สมบูรณ์
นี่คือสคีมาอีคอมเมิร์ซที่แยกผลิตภัณฑ์ ลูกค้า ที่อยู่ คำสั่งซื้อ และรายการคำสั่งซื้อ โดยสมมติว่าตัวระบุที่ระบุแต่ละรายการกำหนดแอตทริบิวต์ที่เหลือ ตารางเหล่านี้เป็นไปตามรูปแบบปกติที่แสดงไว้ ราคาขายที่จัดเก็บเป็นข้อเท็จจริงทางประวัติศาสตร์ ไม่ใช่สำเนาของราคาผลิตภัณฑ์ปัจจุบัน
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
วางสิ่งนี้ลงใน ตัวแก้ไขของ Erd Go เพื่อดู แผนภาพ ERD แบบภาพพร้อมความสัมพันธ์ทั้งหมดที่ถูกแมปโดยอัตโนมัติ
เมื่อใดที่ควรทำ Denormalize
ในขณะที่การทำ Normalization เป็นแนวทางปฏิบัติที่ดีโดยทั่วไป แต่มีบางกรณีที่การทำ Denormalization ช่วยปรับปรุงประสิทธิภาพ:
- ภาระงานที่เน้นการอ่าน (Read-heavy workloads) — หากแอปพลิเคชันของคุณอ่านมากกว่าเขียนมาก การจัดเก็บข้อมูลที่คำนวณไว้หรือข้อมูลที่ซ้ำกันสามารถหลีกเลี่ยง JOIN ที่มีราคาแพงได้
- การรายงานและการวิเคราะห์ — ตารางที่ไม่ได้ทำ normalization หรือ materialized views มักถูกใช้สำหรับแดชบอร์ด
- การแคชข้อมูลที่ใช้งานบ่อย — การจัดเก็บค่ารวมที่เข้าถึงบ่อยไว้ในตารางโดยตรง
- รูปแบบการเข้าถึงสไตล์ NoSQL — เมื่อคิวรีของคุณต้องการชุดข้อมูลเฉพาะเจาะจงเสมอ
กุญแจสำคัญคือ ทำ normalization ก่อน แล้วค่อยทำ denormalization อย่างตั้งใจ ในกรณีที่ประสิทธิภาพต้องการมัน โดยมีการบันทึกเหตุผลว่าทำไมจึงต้องมีการแลกเปลี่ยน (trade-off) นั้น