ตัวอย่าง SQL จะใช้ PostgreSQL เว้นแต่จะระบุภาษาอื่นไว้ ตัวอย่างสั้นๆ สมมติว่าตารางที่อ้างถึงมีอยู่แล้ว โปรดตรวจสอบความถูกต้องของ DDL ในฐานข้อมูลเป้าหมายของคุณก่อนนำไปใช้งาน
ดัชนีฐานข้อมูลคืออะไร?
หนึ่ง ดัชนี (index) คือโครงสร้างข้อมูลที่ดูแลโดยเอนจินฐานข้อมูล ซึ่งให้เส้นทางการค้นหาที่รวดเร็วไปยังแถวต่างๆ ในตาราง สำหรับตัวกรองแบบเลือก ดัชนีสามารถลดจำนวนแถวหรือหน้าที่ต้องอ่านได้ ตัวปรับแต่งประสิทธิภาพอาจยังคงเลือกการสแกนตารางสำหรับตารางขนาดเล็กหรือคิวรีที่ส่งคืนแถวจำนวนมาก ควรวัดแผนการทำงานและเวลาแทนที่จะคาดเดาความเร็วที่เพิ่มขึ้นแบบคงที่
ดัชนี B-Tree ทำงานอย่างไร
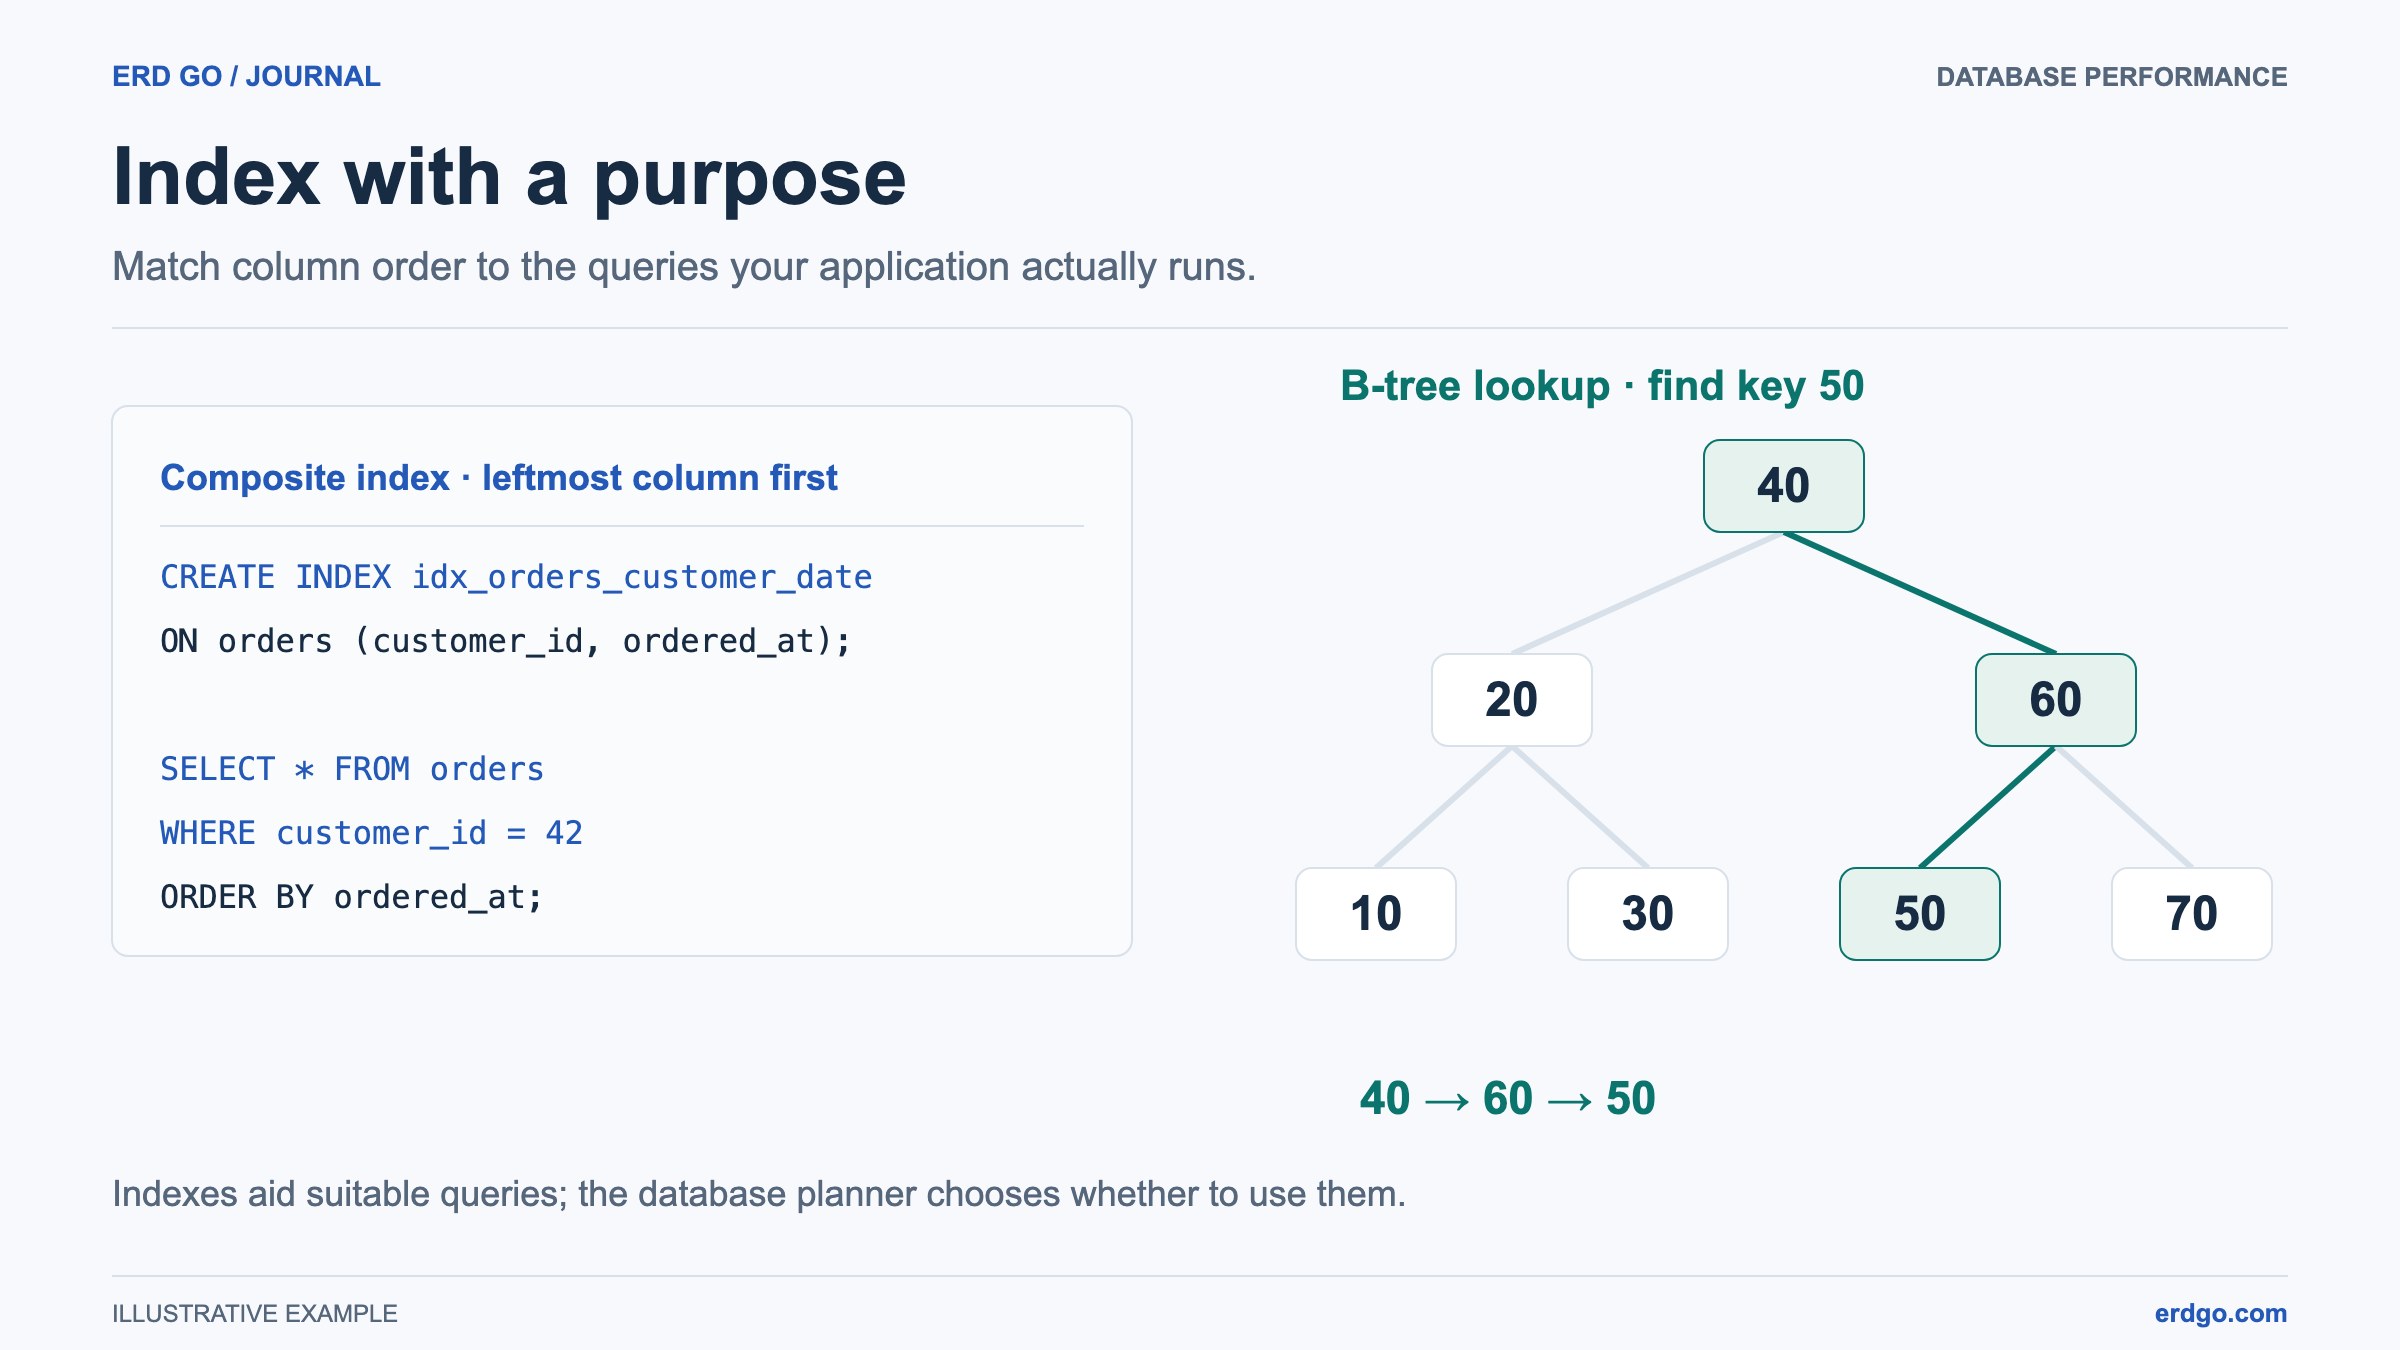
ประเภทดัชนีที่พบบ่อยที่สุดใน PostgreSQL, MySQL, SQL Server และ SQLite คือ B-tree (B-tree) ให้ลองนึกภาพเหมือนสมุดโทรศัพท์ แทนที่จะอ่านชื่อทุกชื่อตั้งแต่ A ถึง Z คุณจะเปิดไปยังส่วนที่ใกล้เคียงที่สุด จำกัดวงให้แคบลงจนถึงหน้าที่ถูกต้อง และไปถึงรายการนั้น B-tree ทำงานในลักษณะเดียวกัน:
- แผนผังถูกจัดระเบียบเป็น โหนด (nodes). โหนดภายในแต่ละโหนดประกอบด้วยคีย์ที่เรียงลำดับและตัวชี้ไปยังโหนดลูก
- การค้นหาเริ่มต้นที่ ราก, เปรียบเทียบค่าที่ค้นหากับคีย์ของโหนด และติดตามตัวชี้ที่ถูกต้องลงไปผ่าน สาขา โหนด
- มันไปถึง leaf ที่มีรายการที่ตรงกัน ขึ้นอยู่กับเอนจินและดัชนี รายการจะระบุแถว ประกอบด้วยคีย์แบบคลัสเตอร์ หรือเก็บข้อมูลแถวไว้เอง
- แผนผังจะยังคงสมดุล แต่ความลึกและ I/O ขึ้นอยู่กับความกว้างของคีย์ ขนาดหน้า จำนวนแถว การแคช และว่าคิวรีดึงหน้าตารางด้วยหรือไม่
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
เมื่อใดที่คุณควรใช้ดัชนี (Indexes)?
ดัชนีไม่ได้ฟรี มันใช้พื้นที่ดิสก์และเพิ่มภาระให้กับทุกๆ INSERT, UPDATE, และ DELETE เนื่องจากเอนจินต้องรักษาดัชนีให้ตรงกับข้อมูลในตารางเสมอ ควรใช้ดัชนีอย่างมีกลยุทธ์:
- คอลัมน์ใน
WHEREประโยค ดัชนีที่เหมาะสมสามารถช่วยในการกรองแบบเลือกที่พบบ่อย ประโยชน์ของมันขึ้นอยู่กับการกระจายของข้อมูลและแผนที่เลือก - คอลัมน์ใน
JOINเงื่อนไข ดัชนีอาจช่วยในการเชื่อมต่อคีย์นอกและการอัปเดตหรือลบข้อมูลหลัก การเชื่อมต่อขนาดใหญ่อาจยังคงชอบการสแกนมากกว่า - คอลัมน์ใน
ORDER BYและGROUP BY. ดัชนีสามารถให้ข้อมูลที่เรียงลำดับไว้ล่วงหน้า ซึ่งช่วยลดการดำเนินการเรียงลำดับที่มีราคาแพง - คอลัมน์ที่มีความหลากหลายสูง (High-cardinality) คอลัมน์ที่มีค่าที่แตกต่างกันจำนวนมาก (เช่น อีเมลหรือ UUID) จะได้รับประโยชน์มากกว่าคอลัมน์ที่มีค่าที่แตกต่างกันน้อย (เช่น บูลีน)
is_activeแฟล็ก) - ตารางขนาดใหญ่ ตารางที่มี 100 แถวแทบไม่จำเป็นต้องมีดัชนีเพิ่มเติม ตารางที่มี 10 ล้านแถวจำเป็นต้องมีอย่างแน่นอน
ตามกฎทั่วไป: เริ่มต้นโดยไม่มีดัชนีเพิ่มเติม วัดประสิทธิภาพของคิวรีด้วย EXPLAIN, จากนั้นเพิ่มดัชนีในจุดที่ข้อมูลบอกคุณ
ประเภทของดัชนี (Indexes)
ดัชนีคอลัมน์เดียว
รูปแบบที่ง่ายที่สุด สร้าง B-tree บนหนึ่งคอลัมน์ เหมาะสำหรับคิวรีที่กรองหรือเรียงลำดับบนคอลัมน์นั้นเพียงอย่างเดียว
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
ดัชนีแบบคอมโพสิต (หลายคอลัมน์)
ดัชนีบนคอลัมน์ตั้งแต่สองคอลัมน์ขึ้นไป ตัวกรองความเท่าเทียมบนคอลัมน์นำและช่วงบนคอลัมน์ถัดไปมักจะสร้างเส้นทางการเข้าถึง B-tree ที่มีประสิทธิภาพ เงื่อนไขอื่นๆ อาจยังคงใช้การสแกนหรือการข้ามการสแกน (skip scan) การสนับสนุนและต้นทุนจะแตกต่างกันไปตามเอนจินและเวอร์ชัน
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
เลือกลำดับคอลัมน์จากตัวกรองความเท่าเทียม เงื่อนไขช่วง การเรียงลำดับ และความต้องการความครอบคลุม “เลือกสิ่งที่คัดเลือกมากที่สุดก่อน” ไม่ใช่กฎสากล PostgreSQL 18 สามารถใช้ B-tree skip scans สำหรับตัวกรองที่ไม่ใช่ตัวนำที่เหมาะสมได้
ดัชนีที่ไม่ซ้ำกัน (Unique Index)
บังคับใช้ข้อจำกัดความเป็นเอกลักษณ์ในขณะที่ให้ประสิทธิภาพการค้นหาตามดัชนี ฐานข้อมูลส่วนใหญ่จะสร้างดัชนีที่ไม่ซ้ำกันโดยอัตโนมัติเมื่อคุณกำหนด UNIQUE ข้อจำกัดหรือ PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
ดัชนีบางส่วน (กรองแล้ว)
ดัชนีเฉพาะแถวที่ตรงตาม WHERE เงื่อนไข สิ่งนี้จะช่วยให้ดัชนีมีขนาดเล็กและกำหนดเป้าหมายได้แม่นยำ
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
ดัชนีบางส่วนหรือแบบกรองสามารถช่วยในชุดข้อมูลย่อยขนาดเล็กที่มีการคิวรีบ่อยได้ เงื่อนไขคิวรีต้องระบุตัวกรองนั้น ไวยากรณ์ตัวกรองของ SQL Server มีข้อจำกัดมากกว่าของ PostgreSQL อย่าคัดลอกเงื่อนไขตามอำเภอใจระหว่างกัน
ประเภทดัชนีอื่นๆ
| ประเภทดัชนี | ดีที่สุดสำหรับ | การรองรับฐานข้อมูล |
|---|---|---|
| Hash | การค้นหาความเท่ากันแบบตรงตัว (=) | PostgreSQL, MySQL (เอนจิน Memory) |
| GIN | การค้นหาแบบ Full-text, JSONB, อาร์เรย์ | PostgreSQL |
| GiST | ประเภทข้อมูลเชิงเรขาคณิตและช่วง | PostgreSQL |
| BRIN | ตารางขนาดใหญ่มากที่มีข้อมูลที่เรียงลำดับตามธรรมชาติ | PostgreSQL |
| Full-Text | การค้นหาข้อความพร้อมการจัดอันดับความเกี่ยวข้อง | MySQL, SQL Server |
ข้อผิดพลาดทั่วไปในการทำดัชนี
แม้แต่นักพัฒนาที่มีประสบการณ์ก็ยังตกหลุมพรางเหล่านี้ หลีกเลี่ยงสิ่งเหล่านี้เพื่อให้ฐานข้อมูลของคุณทำงานได้ดี
1. การทำดัชนีมากเกินไป
การเพิ่มดัชนีในทุกคอลัมน์ "เผื่อไว้" จะทำให้เปลืองพื้นที่ดิสก์และทำให้การเขียนช้าลง ดัชนีแต่ละตัวจะต้องได้รับการอัปเดตในการแทรก อัปเดต และลบทุกครั้ง ตารางที่มี 15 ดัชนีจะมีปริมาณงานการเขียนที่ช้ากว่าตารางที่มีดัชนีที่เลือกมาอย่างดี 3 ตัวอย่างเห็นได้ชัด
2. การทำดัชนีคอลัมน์ที่มีความหลากหลายต่ำ
การทำดัชนีบูลีน is_active คอลัมน์ที่มีเพียง TRUE และ FALSE สามารถมีประโยชน์เมื่อค่ามีความเบี่ยงเบนสูงหรือดัชนีครอบคลุมคิวรีที่แคบ ความเป็นคาร์ดินัลลิตี้ (cardinality) เพียงอย่างเดียวไม่ได้เป็นตัวตัดสินว่าดัชนีจะมีประโยชน์หรือไม่ หากคุณจำเป็นต้องกรองข้อมูลในคอลัมน์ดังกล่าว ให้รวมคอลัมน์เหล่านั้นไว้ในดัชนีแบบผสมที่มีคอลัมน์ที่มีความเป็นคาร์ดินัลลิตี้สูงกว่า หรือใช้ดัชนีแบบบางส่วน (partial index)
3. การเพิกเฉยต่อรูปแบบคิวรี
ดัชนีจะมีประโยชน์ก็ต่อเมื่อคิวรีจริงของคุณสามารถใช้ประโยชน์จากมันได้ ตรวจสอบคิวรีที่ช้าในแอปพลิเคชันของคุณเสมอ แรก, จากนั้นออกแบบดัชนีที่กำหนดเป้าหมายรูปแบบการเข้าถึงเฉพาะเหล่านั้น
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. การลืมทำดัชนีคีย์นอก
ใน PostgreSQL คอลัมน์คีย์นอก (foreign-key) คือ ไม่ ถูกจัดทำดัชนีโดยอัตโนมัติ (ไม่เหมือนกับ InnoDB ของ MySQL ซึ่งสร้างดัชนีบนคีย์นอกโดยค่าเริ่มต้น) ดัชนีสามารถช่วยในการจอยน์แบบเลือกเฉพาะและการตรวจสอบความสัมพันธ์ แต่ตัวปรับแต่งประสิทธิภาพ (optimizer) อาจเลือกใช้การสแกนหรือการจอยน์แบบแฮช (hash join) ให้ตรวจสอบดัชนีที่มีอยู่ซึ่งคอลัมน์นำหน้าครอบคลุมคีย์นอกอยู่แล้วก่อนที่จะเพิ่มดัชนีใหม่
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. ไม่เคยตรวจสอบดัชนีที่ไม่ได้ใช้งาน
เมื่อเวลาผ่านไป โค้ดของแอปพลิเคชันจะเปลี่ยนไปและดัชนีเก่าอาจไม่รองรับคิวรีใดๆ อีกต่อไป ดัชนีที่ไม่ได้ใช้งานยังคงใช้พื้นที่จัดเก็บและทำให้การเขียนข้อมูลช้าลงโดยไม่มีประโยชน์ในการอ่าน
การตรวจสอบการใช้งานดัชนี
ฐานข้อมูลสมัยใหม่มีมุมมองระบบที่รายงานว่าแต่ละดัชนีถูกใช้งานบ่อยเพียงใด การทบทวนสิ่งเหล่านี้เป็นประจำจะช่วยให้คุณลบดัชนีที่ไม่ได้ใช้และตรวจพบดัชนีที่ขาดหายไป
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
ปฏิบัติต่อการอ่านที่เป็นศูนย์ว่าเป็นตัวเลือกสำหรับการตรวจสอบ ไม่ใช่การอนุญาตให้ลบดัชนี ตรวจสอบว่าตัวนับถูกรีเซ็ตเมื่อใด มีการเปิดใช้งานการวัดผลหรือไม่ และคิวรีตามฤดูกาล ข้อจำกัด หรือการตรวจสอบคีย์นอกจำเป็นต้องใช้หรือไม่ ทดสอบการลบที่เสนอด้วยภาระงานที่เป็นตัวแทน
ดัชนีในการออกแบบสคีมาและ ERD
ในขณะที่ ERD เน้นที่ตาราง คอลัมน์ และความสัมพันธ์เป็นหลัก ดัชนี (Indexes) ก็เป็นส่วนสำคัญของการออกแบบสคีมาโดยรวม เมื่อวางแผนฐานข้อมูลของคุณ ให้พิจารณาดัชนีควบคู่ไปกับคำจำกัดความของตารางของคุณ:
- A คีย์หลัก (primary key) โดยปกติจะมีเส้นทางการเข้าถึงที่จัดการโดยเอนจิน SQLite INTEGER PRIMARY KEY จะใช้ rowid แทนการใช้ดัชนีเฉพาะ (unique index) แยกต่างหาก; ตรวจสอบเอนจินก่อนที่จะเพิ่มดัชนีซ้ำ
- ตรวจสอบเส้นทางการเข้าถึงสำหรับ คีย์นอก. PostgreSQL ไม่สร้างดัชนีฝั่งลูกโดยอัตโนมัติ แต่ดัชนีแบบคอมโพสิตที่มีอยู่อาจครอบคลุมความสัมพันธ์นั้นอยู่แล้ว
- คอลัมน์ที่มี ข้อจำกัด UNIQUE ได้รับดัชนีเฉพาะอัตโนมัติ
- ดัชนีเพิ่มเติมสำหรับคอลัมน์ที่ถูกคิวรีบ่อยควรได้รับการบันทึกไว้ควบคู่ไปกับ DDL ของสคีมาของคุณ เพื่อไม่ให้ลืมในระหว่างการปรับใช้
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
สร้างภาพสคีมาทั้งหมดของคุณ—ตาราง, ความสัมพันธ์ และคอลัมน์ที่คุณวางแผนจะทำดัชนี—โดยการวาง DDL ของคุณลงใน ตัวแก้ไข Erd Go. การเห็นโครงสร้างด้วยสายตามักจะเผยให้เห็นคอลัมน์ที่จำเป็นต้องทำดัชนี (เช่น คีย์นอกที่ถูกจอยน์บ่อยครั้ง) ซึ่งคุณอาจมองข้ามไปเมื่ออ่าน SQL ดิบ