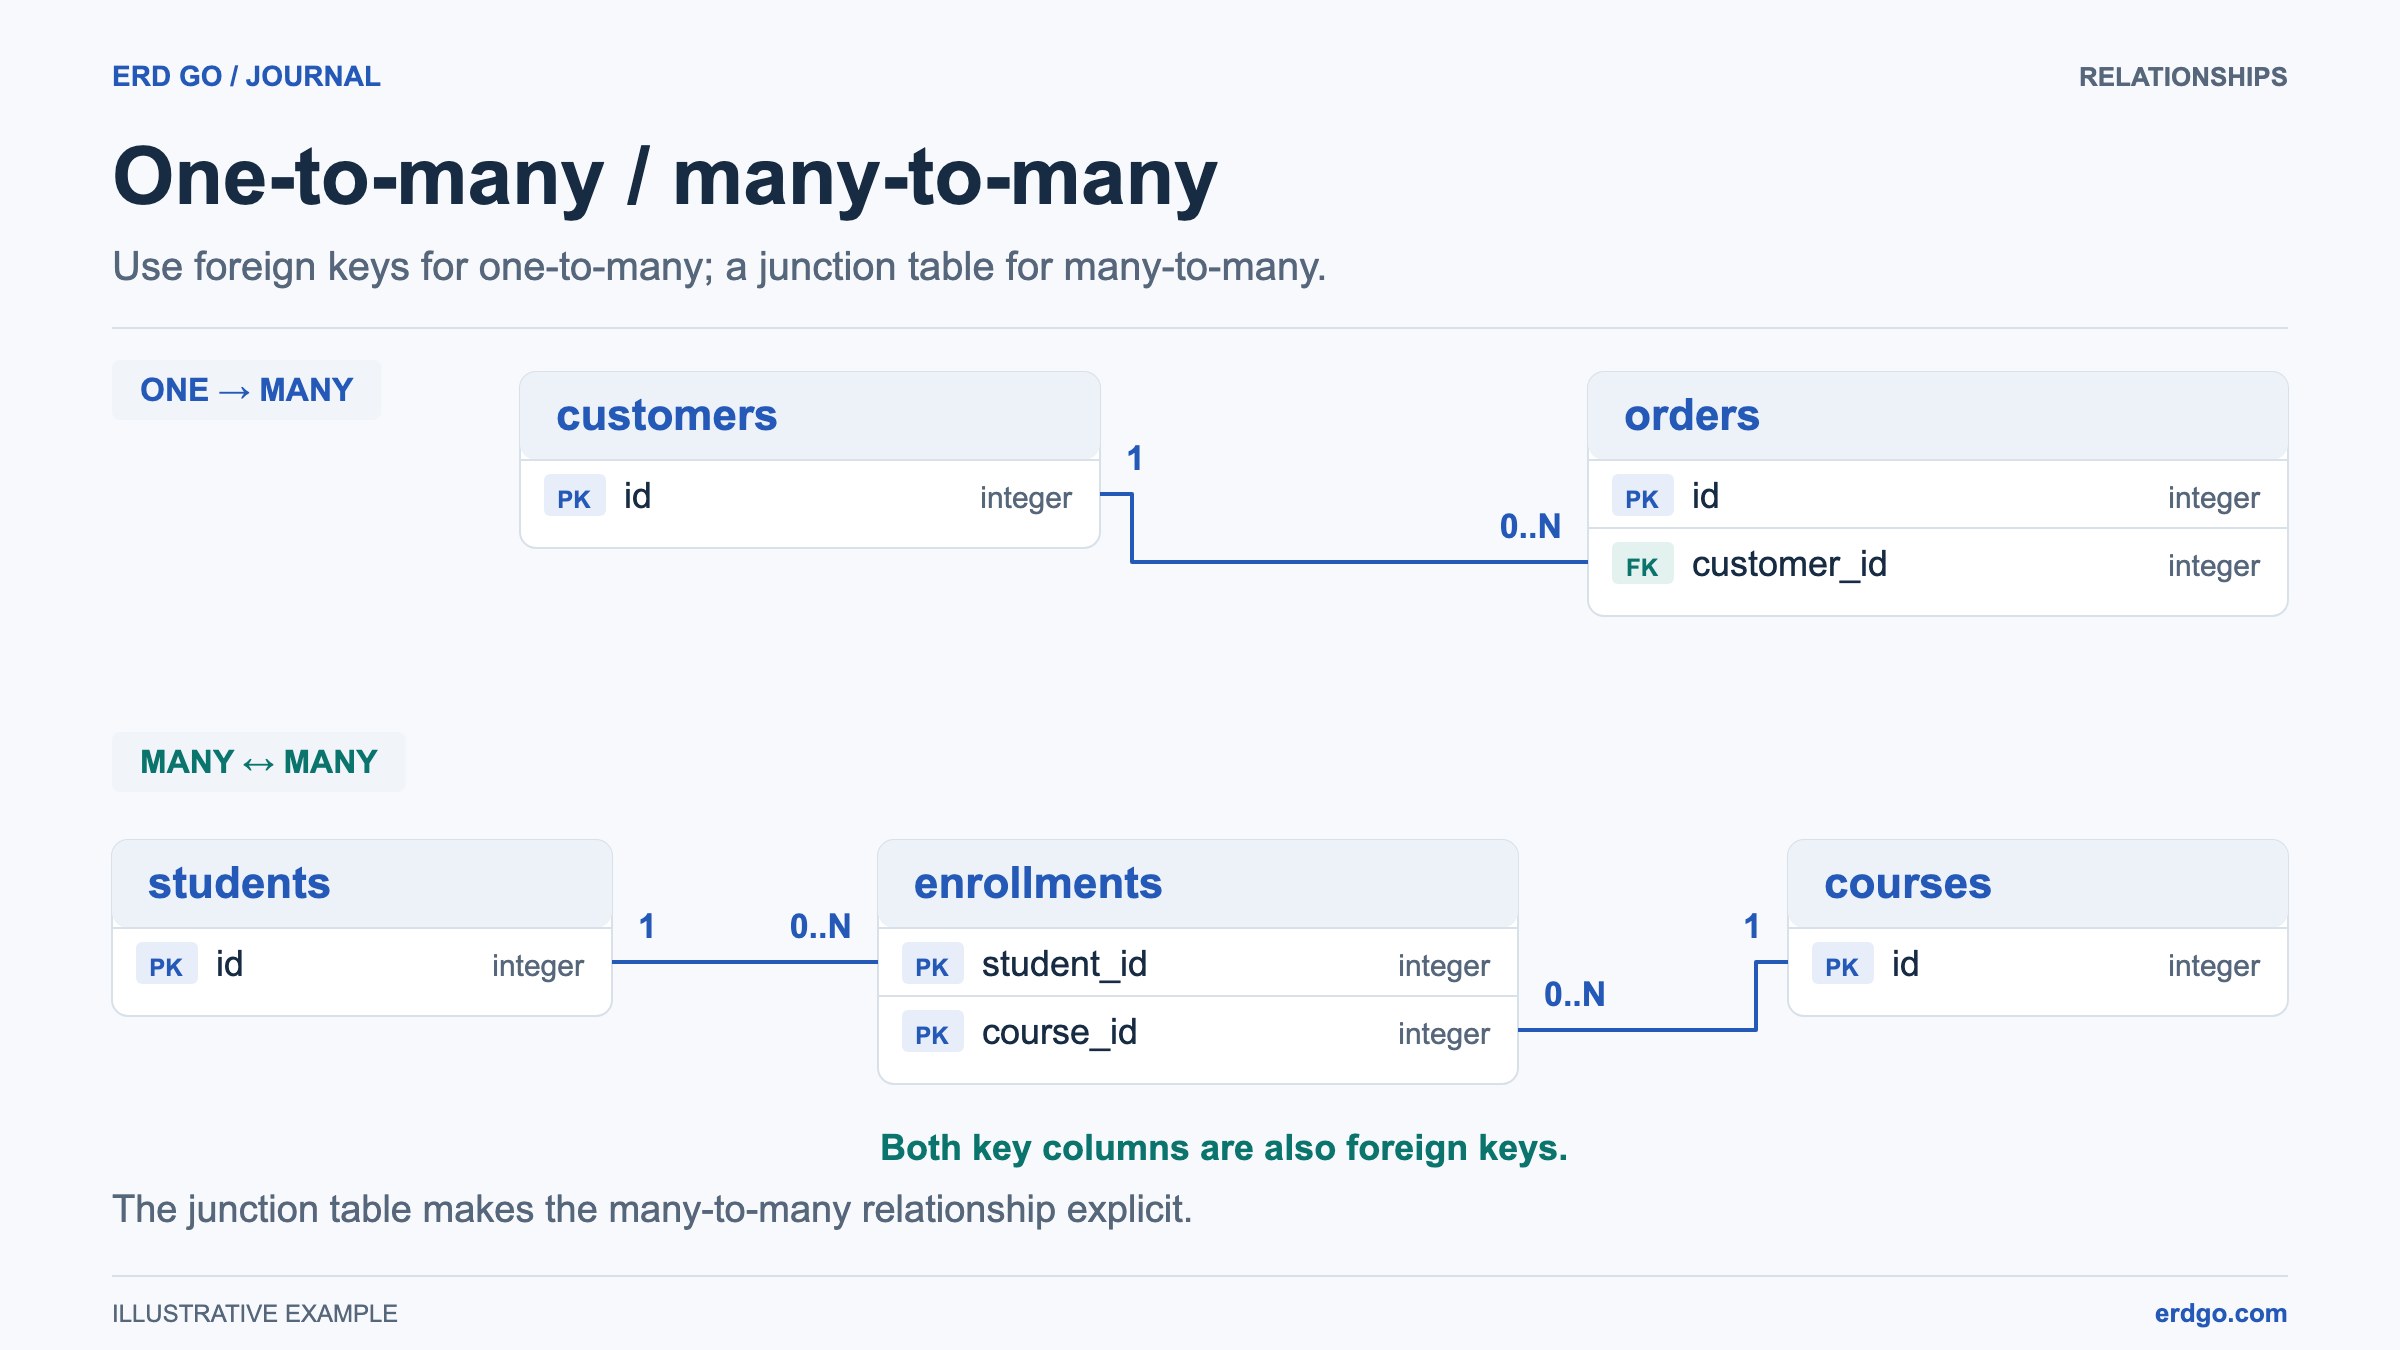
SQL-exempel använder PostgreSQL såvida inte en annan dialekt anges. Korta kodsnuttar förutsätter att deras refererade tabeller redan existerar. Validera DDL i din måldatabas innan du tillämpar den.
Vad är databasnormalisering?
Databasnormalisering är processen att organisera en relationell databas för att minska dataredundans och förbättra dataintegritet. Normalisering introducerades av Edgar F. Codd på 1970-talet och innebär att stora tabeller delas upp i mindre, relaterade tabeller och att relationer definieras mellan dem.
Målet är att representera beroenden konsekvent och minska undvikbar dubblering. Historiska ögonblicksbilder, såsom ett försäljningspris, kan tillhöra en annan tabell eftersom de representerar olika fakta.
Varför normalisera?
- Eliminera redundans — Undvik att lagra samma data på flera ställen.
- Förhindra uppdateringsanomalier — Ändringar av data behöver bara ske på ett ställe.
- Förhindra insättningsanomalier — Du kan lägga till ny data utan att kräva orelaterad data.
- Förhindra borttagningsanomalier — Att ta bort en post tar inte av misstag bort orelaterad data.
- Stöd underhållbara frågor — Tydliga beroenden gör frågor lättare att resonera kring. Prestanda beror på åtkomstmönster, index och kopplingar; normalisering i sig gör inte en fråga snabbare.
Första normalformen (1NF)
En tabell finns i 1NF när:
- Varje kolumn innehåller endast atomära (odelbara) värden
- Varje kolumn innehåller värden av en enda typ
- Rader kan särskiljas med en kandidatnyckel; deklarera en primärnyckel för att framtvinga en vald identifierare i SQL
- Det finns inga repeterande grupper eller matriser
Före 1NF (Bryter mot)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
Efter 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
Andra normalformen (2NF)
En tabell finns i 2NF när:
- Det är redan i 1NF
- Varje icke-primär attribut beror på varje hela kandidatnyckel, utan beroende av endast en del av en nyckel
En kandidatnyckel är en minimal uppsättning attribut som unikt identifierar en rad. Attribut som förekommer i någon kandidatnyckel är primära attribut. Partiella beroenden spelar roll när en kandidatnyckel innehåller flera kolumner; kandidatnycklar inkluderar alternativa unika identifierare, inte bara den valda primärnyckeln. Om en icke-nyckelkolumn endast beror på en del av nyckeln bör den flyttas till en separat tabell.
Före 2NF (Bryter mot)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
Efter 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Tredje normalformen (3NF)
En tabell finns i 3NF när:
- Det är redan i 2NF
- För varje icke-trivialt funktionellt beroende X → A, är X en supernyckel eller så tillhör A en kandidatnyckel. I exemplen nedan tar detta bort transitiva beroenden mellan icke-nyckelattribut.
Före 3NF (Bryter mot)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
Efter 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Ett komplett normaliserat exempel
Här är ett e-handelsschema som separerar produkter, kunder, adresser, beställningar och beställningsrader. Förutsatt att varje listad identifierare bestämmer de återstående attributen, uppfyller dessa tabeller de illustrerade normalformerna. Lagrade försäljningspriser är historiska fakta, inte kopior av det aktuella produktpriset.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Klistra in detta i Erd Go-redigeraren för att se det visuella Klassdiagrammet med alla relationer automatiskt kartlagda.
När man ska denormalisera
Medan normalisering generellt är god praxis, finns det fall där denormalisering förbättrar prestandan:
- Lästunga arbetsbelastningar — Om din applikation läser betydligt mer än den skriver, kan lagring av beräknad eller duplicerad data undvika dyra JOINs.
- Rapportering och analys — Denormaliserade tabeller eller materialiserade vyer används ofta för instrumentpaneler.
- Cachning av het data — Lagring av ofta åtkomna aggregerade värden direkt i en tabell.
- Åtkomstmönster i NoSQL-stil — När dina frågor alltid behöver en specifik kombination av data.
Nyckeln är att normalisera först, avnormalisera sedan avsiktligt där prestanda kräver det, dokumentera varför avvägningen gjordes.