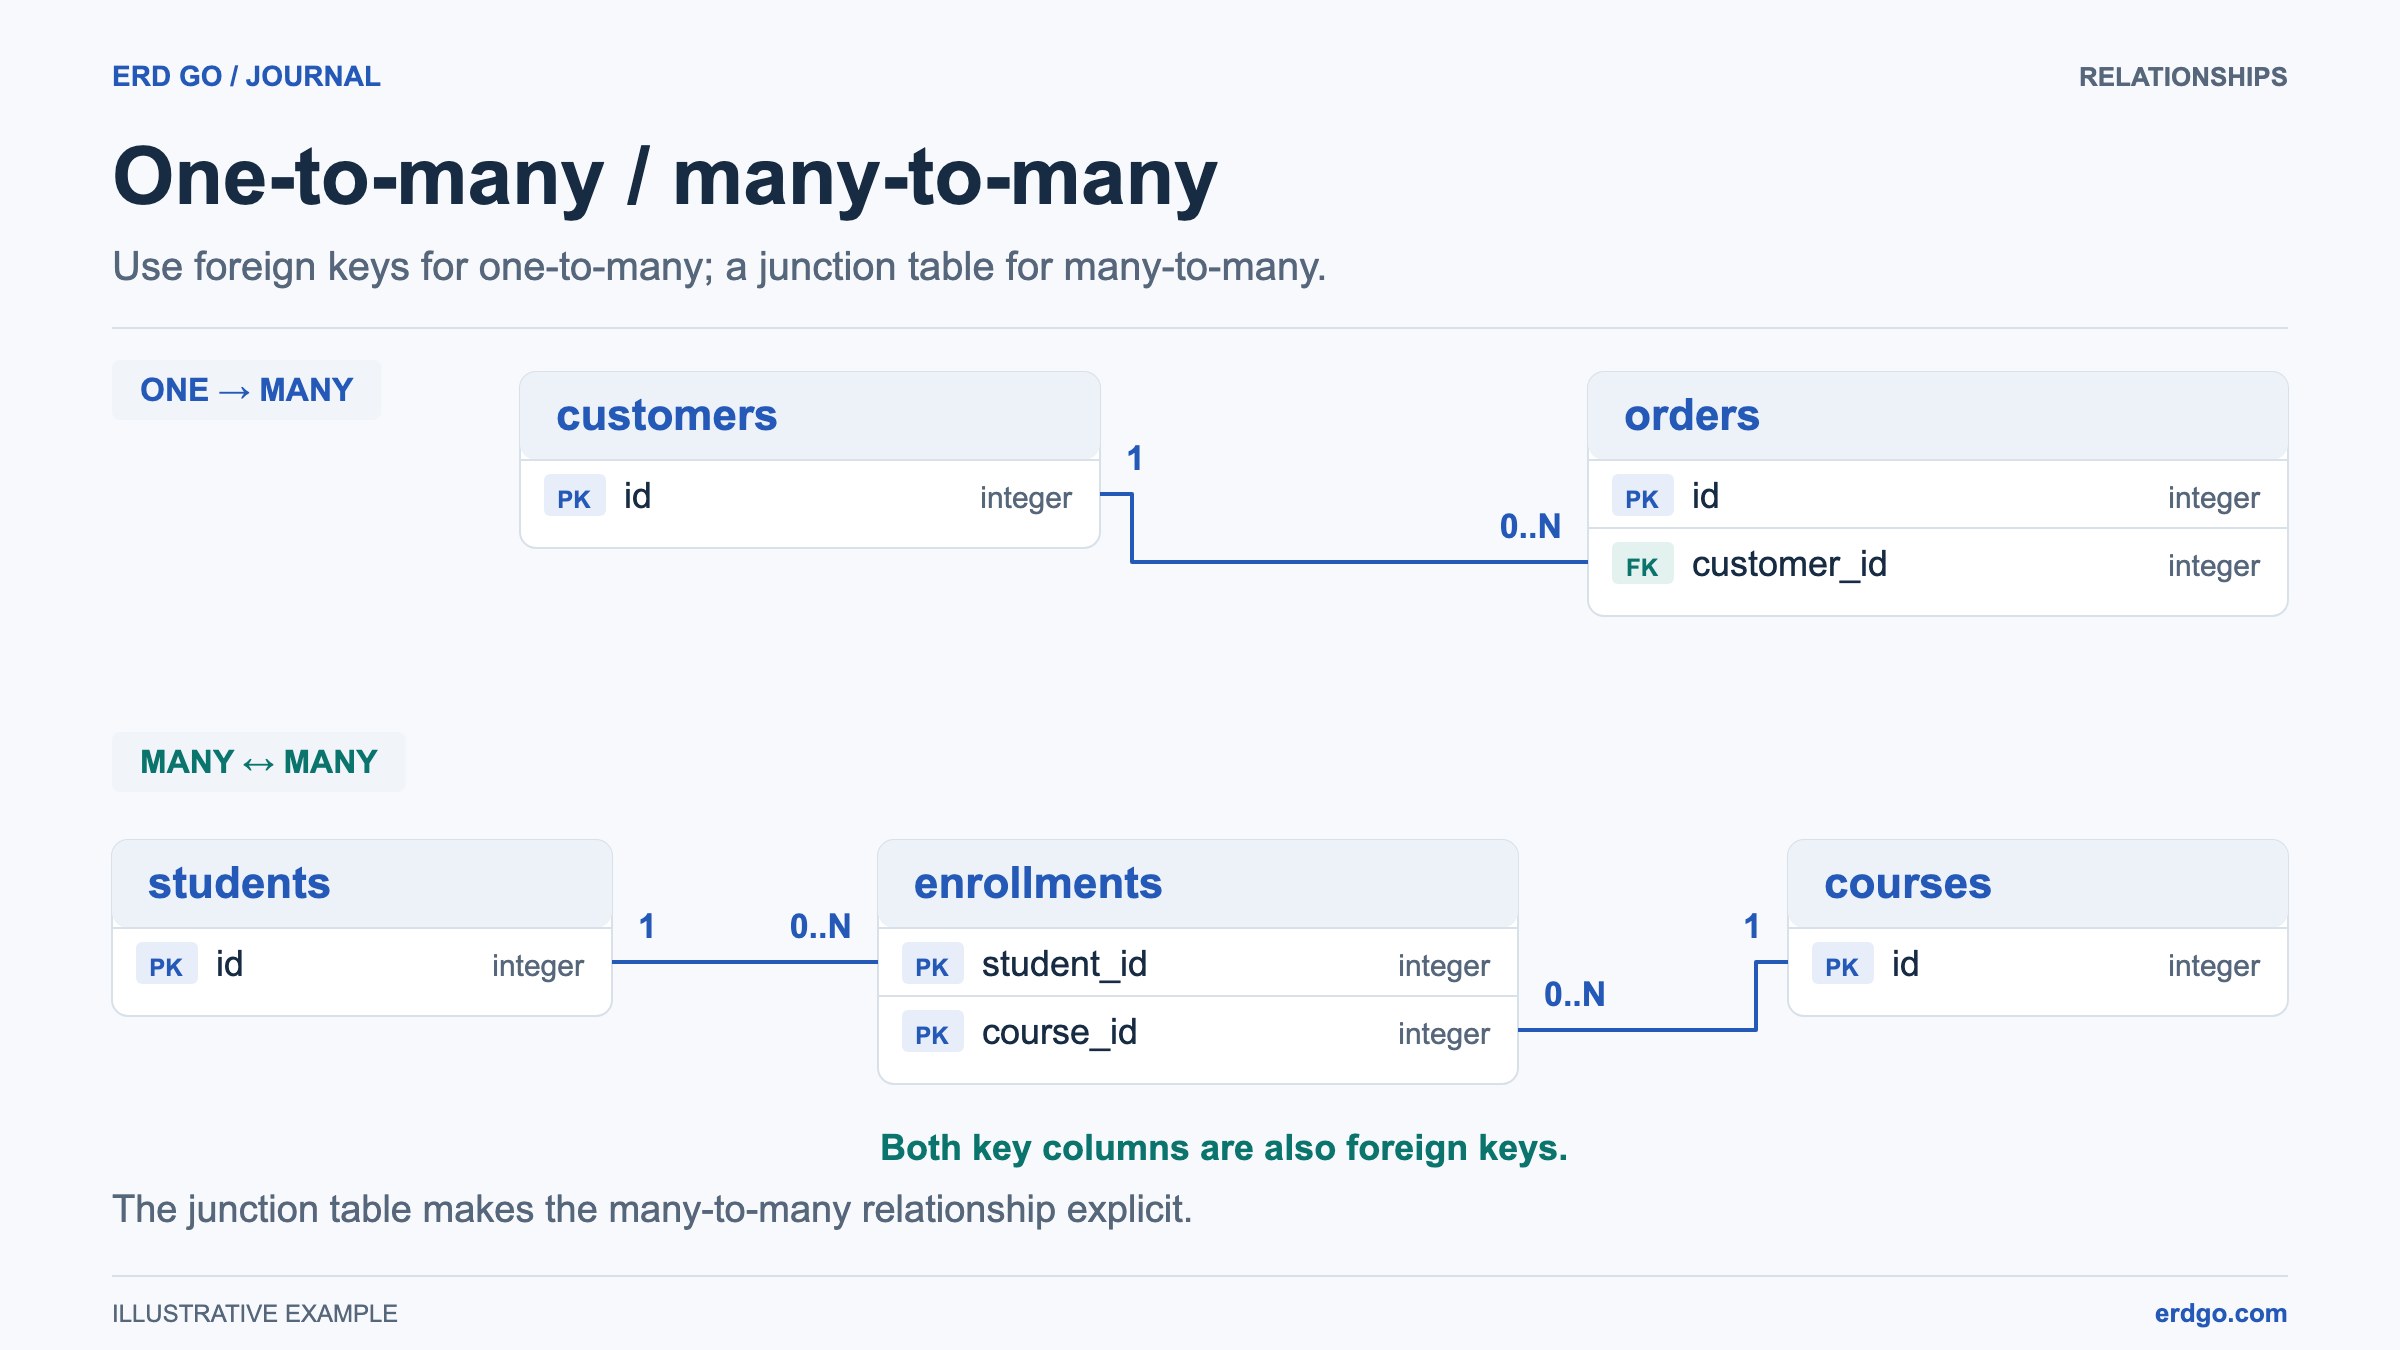
Os exemplos de SQL utilizam PostgreSQL, a menos que outro dialeto seja mencionado. Excertos curtos pressupõem que as suas tabelas referenciadas já existem. Valide o DDL na sua base de dados de destino antes de o aplicar.
O que é a normalização de base de dados?
Normalização de base de dados é o processo de organização de uma base de dados relacional para reduzir a redundância de Dados e melhorar a integridade dos Dados. Introduzida por Edgar F. Codd na década de 1970, a normalização envolve a divisão de tabelas grandes em tabelas menores relacionadas e a definição de relações entre elas.
O objetivo é representar dependências de forma consistente e reduzir duplicações evitáveis. Instantâneos históricos, como o preço de uma venda, podem pertencer a uma tabela diferente porque representam factos diferentes.
Porquê normalizar?
- Eliminar redundância — Evite armazenar os mesmos dados em vários locais.
- Prevenir anomalias de atualização — As alterações aos dados só precisam de ocorrer num único local.
- Prevenir anomalias de inserção — Pode adicionar novos dados sem necessitar de dados não relacionados.
- Prevenir anomalias de eliminação — Eliminar um registo não remove acidentalmente dados não relacionados.
- Suportar consultas passíveis de manutenção — Dependências claras tornam as consultas mais fáceis de compreender. O desempenho depende de padrões de acesso, índices e junções; a normalização por si só não torna uma consulta mais rápida.
Primeira Forma Normal (1NF)
Uma tabela está em 1NF quando:
- Cada coluna contém apenas valores atómicos (indivisíveis)
- Cada coluna contém valores de um único tipo
- As linhas são distinguíveis por uma chave candidata; declare uma chave primária para impor um identificador escolhido em SQL
- Não existem grupos ou matrizes repetidos
Antes da 1NF (Violando)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
Após 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
Segunda Forma Normal (2NF)
Uma tabela está em 2NF quando:
- Já está em 1NF
- Cada atributo não-primo depende de cada inteiro chave candidata, sem dependência de apenas parte de uma chave
Uma chave candidata é um conjunto mínimo de atributos que identifica exclusivamente uma linha. Os atributos que aparecem em qualquer chave candidata são atributos primários. As dependências parciais importam quando uma chave candidata contém várias colunas; as chaves candidatas incluem identificadores únicos alternativos, não apenas a chave primária escolhida. Se uma coluna que não é chave depender apenas de parte da chave, deve ser movida para uma tabela separada.
Antes da 2NF (Violando)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
Após 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Terceira Forma Normal (3NF)
Uma tabela está em 3NF quando:
- Já está em 2NF
- Para cada dependência funcional não trivial X → A, X é uma superchave ou A pertence a uma chave candidata. Nos exemplos abaixo, isto remove dependências transitivas entre atributos que não são chaves.
Antes da 3NF (Violando)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
Após 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Um Exemplo Normalizado Completo
Aqui está um esquema de e-commerce que separa produtos, clientes, endereços, encomendas e linhas de encomenda. Assumindo que cada identificador listado determina os restantes atributos, estas tabelas satisfazem as formas normais ilustradas. Os preços de venda armazenados são factos históricos, não cópias do preço atual do produto.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Cole isto no Editor do Erd Go para ver o ERD visual com todas as relações mapeadas automaticamente.
Quando desnormalizar
Embora a normalização seja geralmente uma boa prática, existem casos em que a desnormalização melhora o desempenho:
- Cargas de trabalho com predominância de leitura — Se a sua aplicação lê muito mais do que escreve, armazenar dados calculados ou duplicados pode evitar JOINs dispendiosos.
- Relatórios e análise — Tabelas desnormalizadas ou vistas materializadas são frequentemente utilizadas para dashboards.
- Caching de dados frequentes — Armazenar valores agregados acedidos frequentemente diretamente numa tabela.
- Padrões de acesso ao estilo NoSQL — Quando as suas consultas necessitam sempre de uma combinação específica de dados.
O segredo é normalize primeiro, depois desnormalize intencionalmente onde o desempenho o exige, documentando a razão pela qual o compromisso foi feito.