Os exemplos de SQL utilizam PostgreSQL, a menos que outro dialeto seja mencionado. Excertos curtos pressupõem que as suas tabelas referenciadas já existem. Valide o DDL na sua base de dados de destino antes de o aplicar.
O que são índices de base de dados?
Um índice é uma estrutura de dados mantida pelo motor de base de dados que fornece um caminho de pesquisa rápido para as linhas de uma tabela. Para filtros seletivos, um índice pode reduzir as linhas ou páginas lidas. O otimizador pode ainda escolher uma varredura de tabela para tabelas pequenas ou consultas que devolvam muitas linhas. Meça o plano e o tempo em vez de assumir uma aceleração fixa.
Como Funcionam os Índices B-Tree
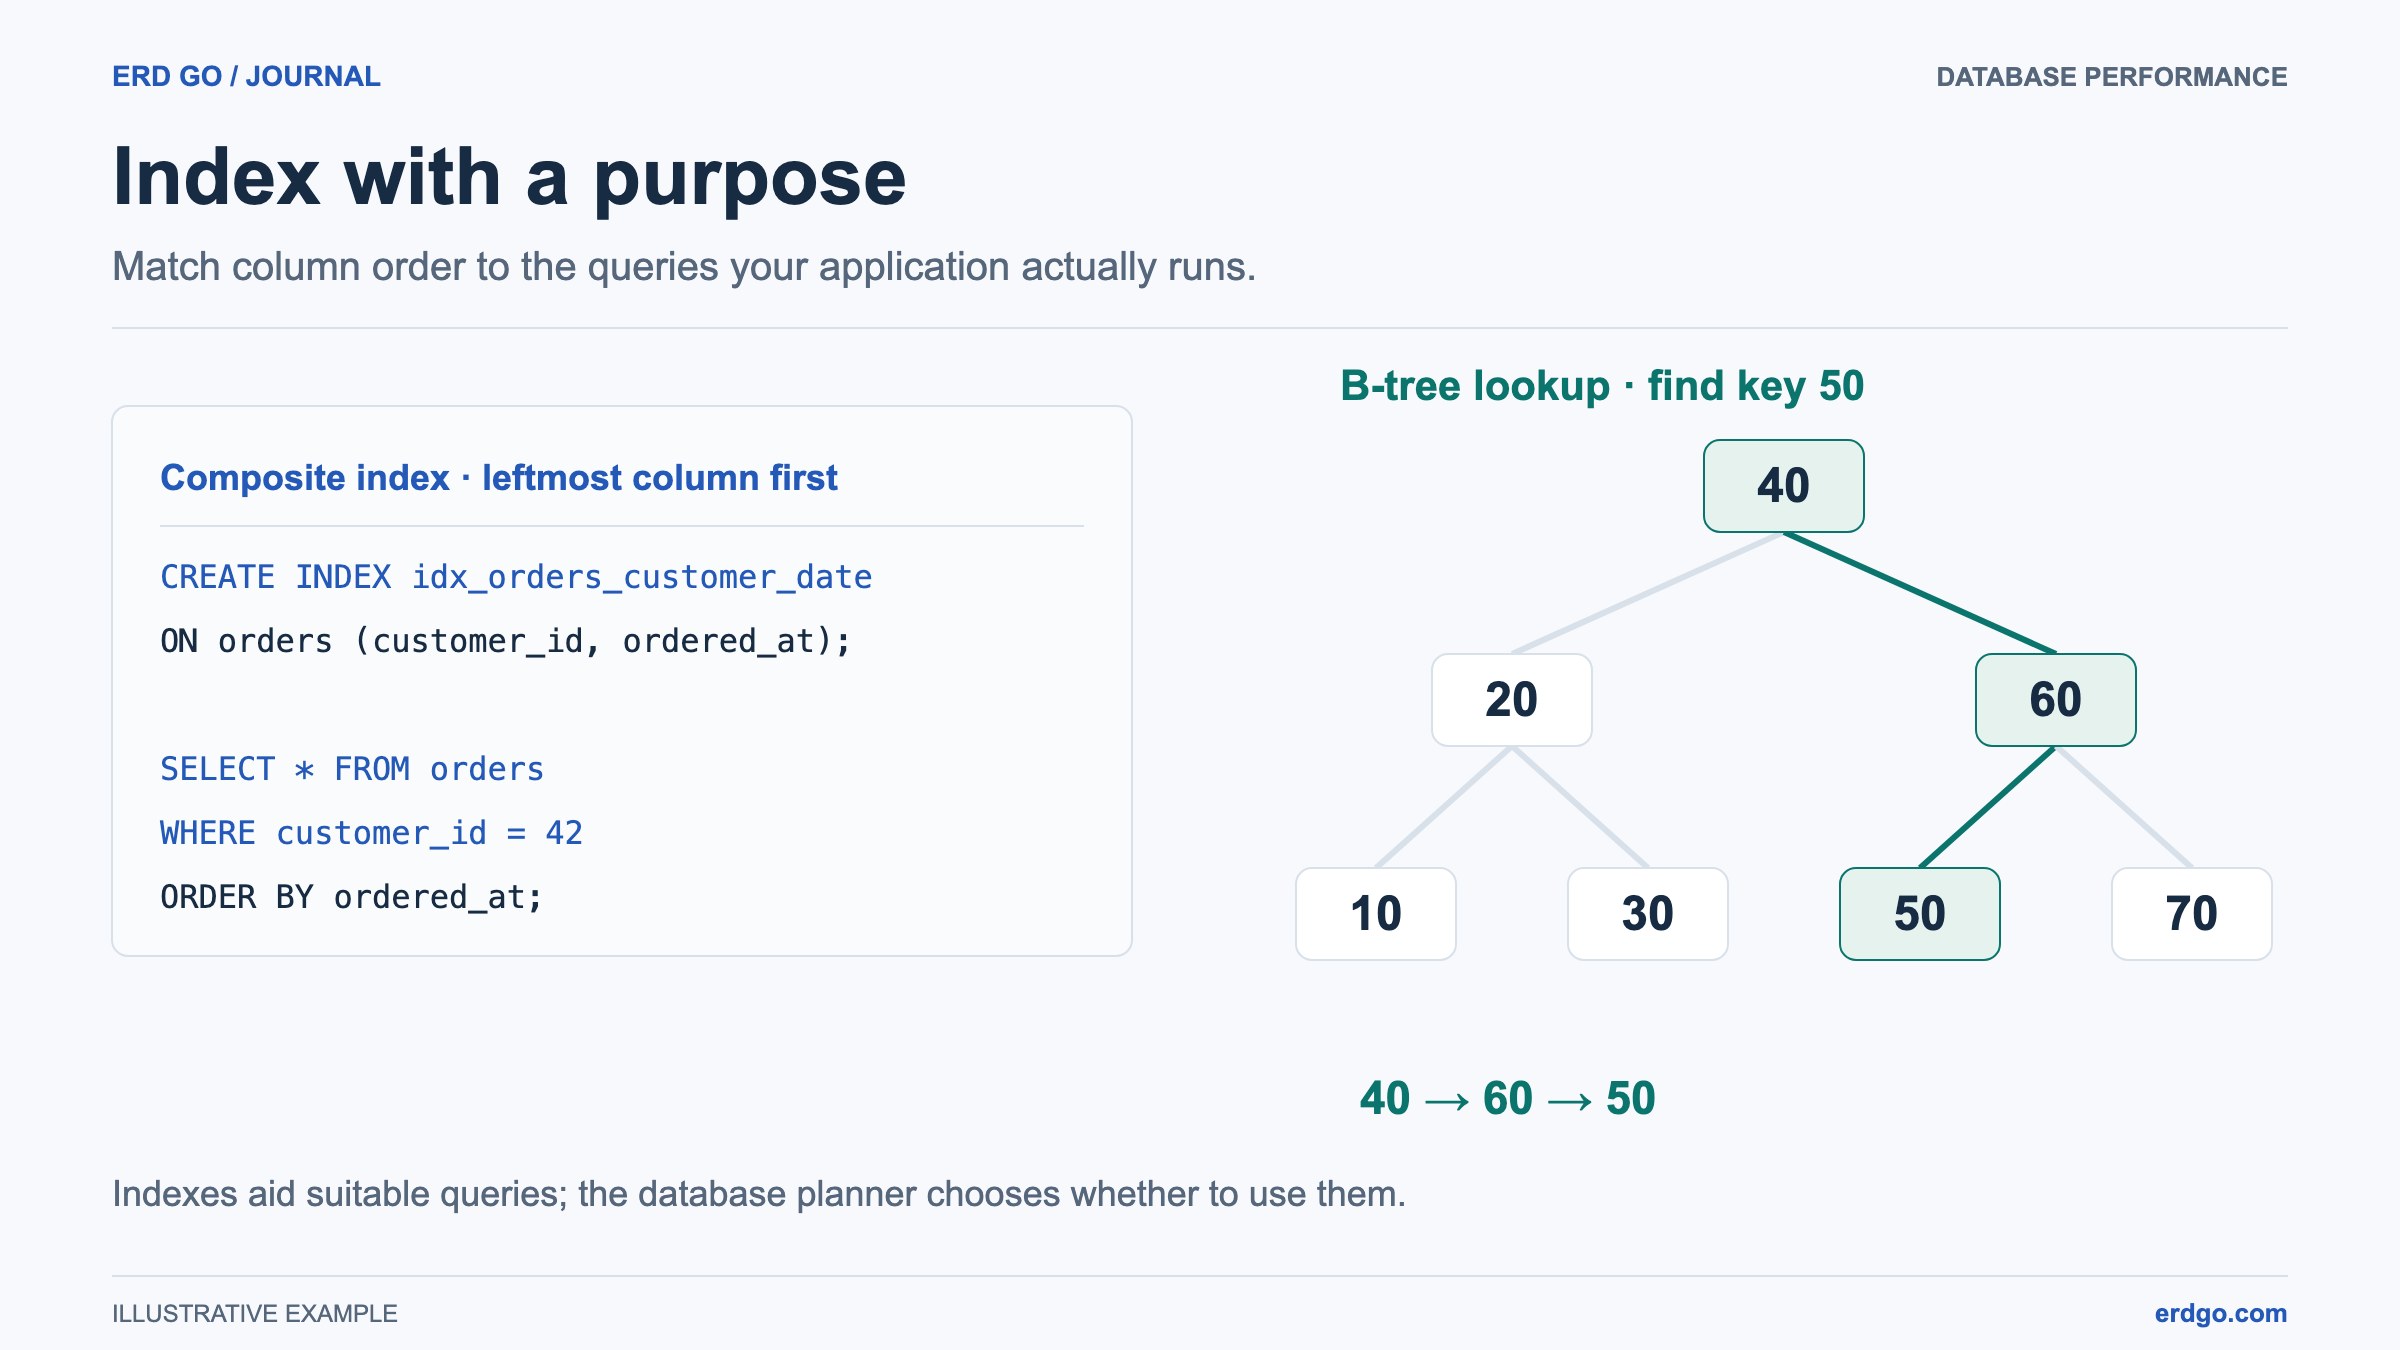
O tipo de índice mais comum em PostgreSQL, MySQL, SQL Server e SQLite é o B-tree (árvore equilibrada). Pense nisto como uma lista telefónica: em vez de ler todos os nomes de A a Z, abre na secção aproximada, restringe à página correta e chega à entrada. Uma B-tree funciona de forma semelhante:
- A árvore está organizada em nós. Cada nó interno contém chaves ordenadas e ponteiros para nós filhos.
- Uma pesquisa começa no raiz, compara o valor de pesquisa com as chaves dos nós e segue o ponteiro correto através de ramo nós.
- Atinge um folha contendo entradas correspondentes. Dependendo do motor e do índice, as entradas identificam linhas, contêm uma chave agrupada ou detêm os próprios Dados da linha.
- A árvore mantém-se equilibrada, mas a sua profundidade e E/S dependem da largura da chave, tamanho da página, contagem de linhas, colocação em cache e se a consulta também obtém páginas da tabela.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Quando deve utilizar índices?
Os índices não são gratuitos. Consomem espaço em disco e adicionam sobrecarga a cada INSERT, UPDATE, e DELETE porque o motor deve manter o índice em sincronia com os Dados da tabela. Use-os estrategicamente:
- Colunas em
WHEREcláusulas. Um índice adequado pode ajudar um filtro seletivo frequente; o seu benefício depende da distribuição de dados e do plano escolhido. - Colunas em
JOINcondições. Os índices podem ajudar em junções de chave estrangeira e atualizações ou eliminações de pais; uma junção grande ainda pode favorecer uma varredura. - Colunas em
ORDER BYeGROUP BY. Um índice pode fornecer Dados pré-ordenados, eliminando uma operação de ordenação dispendiosa. - Colunas de elevada cardinalidade. Colunas com muitos valores distintos (como e-mail ou UUID) beneficiam mais do que colunas com poucos valores distintos (como um booleano
is_activesinalizador). - Tabelas grandes. Uma tabela com 100 linhas raramente precisa de índices extra. Uma tabela com 10 milhões de linhas quase certamente precisa.
Como regra geral: comece sem índices extra, meça o desempenho da consulta com EXPLAIN, depois adicione índices onde os Dados lhe indicarem.
Tipos de índices
Índice de Coluna Única
A forma mais simples. Cria uma árvore B numa coluna. Ideal para consultas que filtram ou ordenam apenas nessa coluna.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Índice Composto (Multicoluna)
Um índice em duas ou mais colunas. Filtros de igualdade nas colunas iniciais e um intervalo na seguinte formam frequentemente um caminho de acesso B-tree eficiente. Outras condições podem ainda utilizar um scan ou skip scan; o suporte e o custo variam consoante o motor e a versão.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Escolha a ordem das colunas a partir de filtros de igualdade, condições de intervalo, ordenação e necessidades de cobertura. “O mais seletivo primeiro” não é uma regra universal. O PostgreSQL 18 pode utilizar varrimentos de salto (skip scans) de árvore B para filtros não iniciais adequados.
Índice único
Impõe uma restrição de unicidade ao mesmo tempo que fornece desempenho de pesquisa baseado em índices. A maioria das bases de dados cria automaticamente um índice único quando define um UNIQUE restrição ou PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Índice Parcial (Filtrado)
Indexa apenas as linhas que satisfazem uma WHERE condição. Isto mantém o índice pequeno e altamente direcionado.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Um índice parcial ou filtrado pode ajudar um subconjunto pequeno e consultado frequentemente. O predicado da consulta deve implicar o filtro. A sintaxe de filtro do SQL Server é mais restrita do que a do PostgreSQL; não copie predicados arbitrários entre eles.
Outros tipos de índice
| Tipo de Índice | Ideal para | Suporte de base de dados |
|---|---|---|
| Hash | Pesquisas de igualdade exata (=) | PostgreSQL, MySQL (motor Memory) |
| GIN | Pesquisa de texto integral, JSONB, arrays | PostgreSQL |
| GiST | Tipos de dados geométricos e de intervalo | PostgreSQL |
| BRIN | Tabelas muito grandes com dados ordenados naturalmente | PostgreSQL |
| Texto integral | Pesquisa de texto com classificação de relevância | MySQL, SQL Server |
Erros Comuns de Indexação
Mesmo os programadores experientes caem nestas armadilhas. Evite-as para manter o bom desempenho da sua base de dados.
1. Indexação excessiva
Adicionar um índice em cada coluna “apenas por precaução” desperdiça espaço em disco e torna as escritas mais lentas. Cada índice deve ser atualizado em cada insert, update e delete. Uma tabela com 15 índices terá um rendimento de escrita significativamente mais lento do que uma com 3 índices bem escolhidos.
2. Indexação de Colunas de Baixa Cardinalidade
Indexar um booleano is_active coluna que contém apenas TRUE e FALSE pode ser útil quando os valores são altamente enviesados ou o índice cobre uma Consulta restrita. A cardinalidade por si só não decide se um índice ajuda. Se tiver de filtrar por tais colunas, combine-as num índice composto com uma coluna de maior cardinalidade, ou use um índice parcial.
3. Ignorar Padrões de Consulta
Um índice só é útil se as suas Consultas reais o puderem aproveitar. Examine sempre as Consultas lentas na sua aplicação primeiro, depois desenhe índices que visem esses padrões de acesso específicos.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Esquecer-se de indexar chaves estrangeiras
No PostgreSQL, as colunas de chave estrangeira são não indexado automaticamente (ao contrário do InnoDB do MySQL, que cria um índice em chaves estrangeiras por padrão). Um índice pode ajudar em junções seletivas e verificações referenciais, mas o otimizador pode escolher uma varredura ou hash join. Verifique se existe um índice cujas colunas iniciais já cobrem a chave estrangeira antes de adicionar outro.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Nunca Rever Índices Não Utilizados
Com o tempo, o código da aplicação muda e os índices antigos podem deixar de servir qualquer consulta. Os índices não utilizados continuam a consumir armazenamento e a abrandar as escritas sem qualquer benefício de leitura.
Monitorização da Utilização de Índices
As bases de dados modernas fornecem vistas de sistema que reportam a frequência com que cada índice é utilizado. A revisão regular destas ajuda a eliminar índices não utilizados e a detetar os que faltam.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Trate zero leituras como um candidato a revisão, e não como permissão para remover um índice. Verifique quando os contadores foram reiniciados, se a instrumentação está ativada e se consultas sazonais, restrições ou verificações de chave estrangeira precisam dele. Teste uma remoção proposta com uma carga de trabalho representativa.
Índices no Design de Esquema e ERDs
Embora os ERDs se foquem principalmente em tabelas, colunas e relacionamentos, os índices são uma parte importante do design geral do esquema. Ao planear a sua base de dados, considere os índices juntamente com as definições das suas tabelas:
- A chave primária normalmente tem um caminho de acesso gerido pelo motor. O INTEGER PRIMARY KEY do SQLite usa o rowid em vez de um índice único separado; verifique o motor antes de adicionar um índice duplicado.
- Reveja os caminhos de acesso para chaves estrangeiras. O PostgreSQL não cria índices do lado do filho automaticamente, mas um índice composto existente pode já cobrir a relação.
- Colunas com Restrições UNIQUE recebem um índice único automático.
- Índices adicionais para colunas consultadas frequentemente devem ser documentados juntamente com o DDL do seu esquema para que não sejam esquecidos durante a implementação.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualize o seu esquema completo — tabelas, relacionamentos e as colunas que planeia indexar — colando o seu DDL no Editor do Erd Go. Ver a estrutura visualmente revela frequentemente colunas que precisam de indexação (como chaves estrangeiras frequentemente associadas) que poderá ignorar ao ler SQL puro.