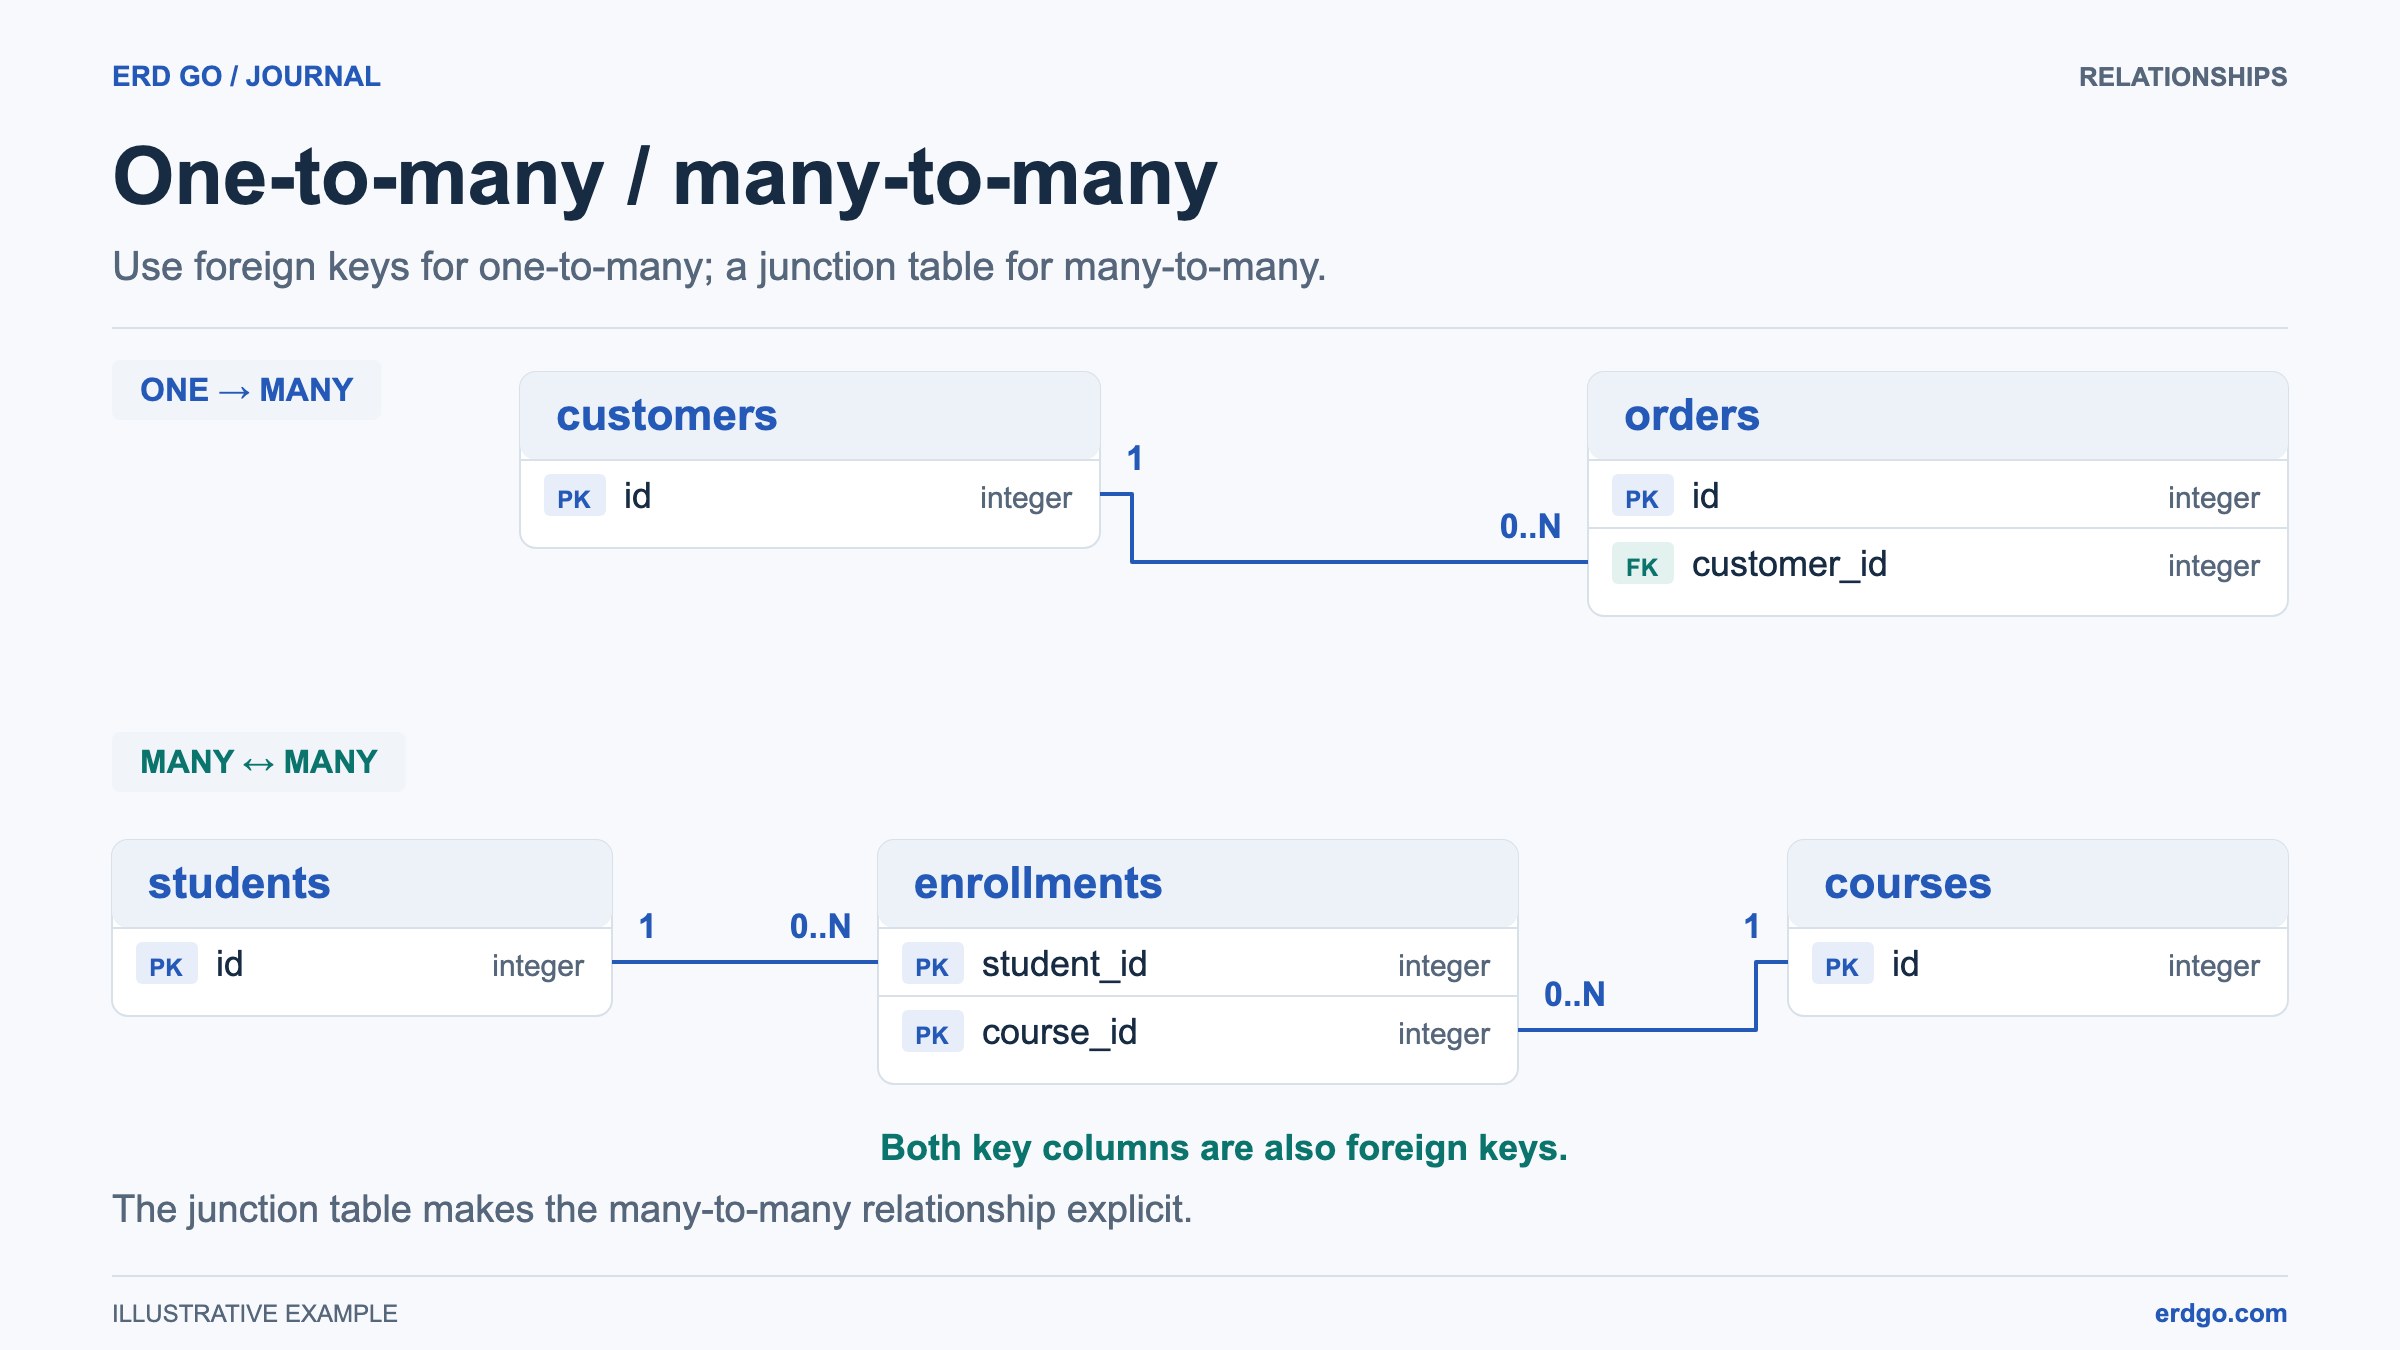
Przykłady SQL używają PostgreSQL, chyba że wymieniono inny dialekt. Krótkie fragmenty zakładają, że tabele, do których się odwołują, już istnieją. Zweryfikuj DDL w docelowej bazie danych przed jego zastosowaniem.
Czym jest normalizacja bazy danych?
Normalizacja bazy danych to proces organizowania relacyjnej bazy danych w celu zmniejszenia redundancji danych i poprawy integralności danych. Wprowadzona przez Edgara F. Codda w latach 70. XX wieku, normalizacja polega na dzieleniu dużych tabel na mniejsze, powiązane tabele i definiowaniu relacji między nimi.
Celem jest spójne reprezentowanie zależności i ograniczenie zbędnego powielania danych. Migawki historyczne, takie jak cena sprzedaży, mogą należeć do innej tabeli, ponieważ reprezentują inne fakty.
Dlaczego warto normalizować?
- Wyeliminuj nadmiarowość — Unikaj przechowywania tych samych danych w wielu miejscach.
- Zapobiegaj anomaliom aktualizacji — Zmiany w danych muszą zachodzić tylko w jednym miejscu.
- Zapobiegaj anomaliom wstawiania — Możesz dodawać nowe dane bez konieczności wprowadzania niepowiązanych danych.
- Zapobiegaj anomaliom usuwania — Usunięcie rekordu nie usuwa przypadkowo niepowiązanych danych.
- Obsługa zapytań łatwych w utrzymaniu — Jasne zależności ułatwiają analizowanie zapytań. Wydajność zależy od wzorców dostępu, indeksów i połączeń; sama normalizacja nie przyspiesza zapytania.
Pierwsza postać normalna (1NF)
Tabela znajduje się w 1NF gdy:
- Każda kolumna zawiera tylko wartości atomowe (niepodzielne)
- Każda kolumna zawiera wartości jednego typu
- Wiersze są rozróżnialne za pomocą klucza kandydującego; zadeklaruj klucz podstawowy, aby wymusić wybrany identyfikator w SQL
- Nie ma powtarzających się grup ani tablic
Przed 1NF (Naruszenie)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
Po 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
Druga postać normalna (2NF)
Tabela znajduje się w 2NF gdy:
- Jest już w 1NF
- Każdy atrybut niekluczowy zależy od każdego cały klucz kandydujący, bez zależności od tylko części klucza
Klucz kandydujący to minimalny zestaw atrybutów, który jednoznacznie identyfikuje wiersz. Atrybuty występujące w dowolnym kluczu kandydującym to atrybuty kluczowe. Zależności częściowe mają znaczenie, gdy klucz kandydujący zawiera kilka kolumn; klucze kandydujące obejmują alternatywne unikalne identyfikatory, a nie tylko wybrany klucz główny. Jeśli kolumna niebędąca kluczem zależy tylko od części klucza, powinna zostać przeniesiona do osobnej tabeli.
Przed 2NF (Naruszenie)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
Po 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Trzecia postać normalna (3NF)
Tabela znajduje się w 3NF gdy:
- Jest już w 2NF
- Dla każdej nietrywialnej zależności funkcyjnej X → A, X jest superkluczem lub A należy do klucza kandydującego. W poniższych przykładach usuwa to zależności przechodnie między atrybutami niebędącymi kluczami.
Przed 3NF (Naruszenie)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
Po 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Kompletny znormalizowany przykład
Oto schemat e-commerce, który rozdziela produkty, klientów, adresy, zamówienia i pozycje zamówień. Zakładając, że każdy wymieniony identyfikator określa pozostałe atrybuty, tabele te spełniają przedstawione formy normalne. Zapisane ceny sprzedaży są faktami historycznymi, a nie kopiami aktualnej ceny produktu.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Wklej to do Edytor Erd Go aby zobaczyć wizualny ERD ze wszystkimi relacjami zmapowanymi automatycznie.
Kiedy denormalizować
Chociaż normalizacja jest ogólnie dobrą praktyką, istnieją przypadki, w których denormalizacja poprawia wydajność:
- Obciążenia z przewagą odczytu — Jeśli Twoja aplikacja czyta znacznie więcej niż zapisuje, przechowywanie obliczonych lub zduplikowanych danych może zapobiec kosztownym operacjom JOIN.
- Raportowanie i analityka — Denormalizowane tabele lub widoki zmaterializowane są często używane w pulpitach nawigacyjnych.
- Buforowanie często używanych danych — Przechowywanie często używanych zagregowanych wartości bezpośrednio w tabeli.
- Worce dostępu w stylu NoSQL — Gdy Twoje zapytania zawsze potrzebują określonej kombinacji danych.
Kluczem jest najpierw normalizuj, potem denormalizuj celowo tam, gdzie wymaga tego wydajność, dokumentując powód pójścia na kompromis.