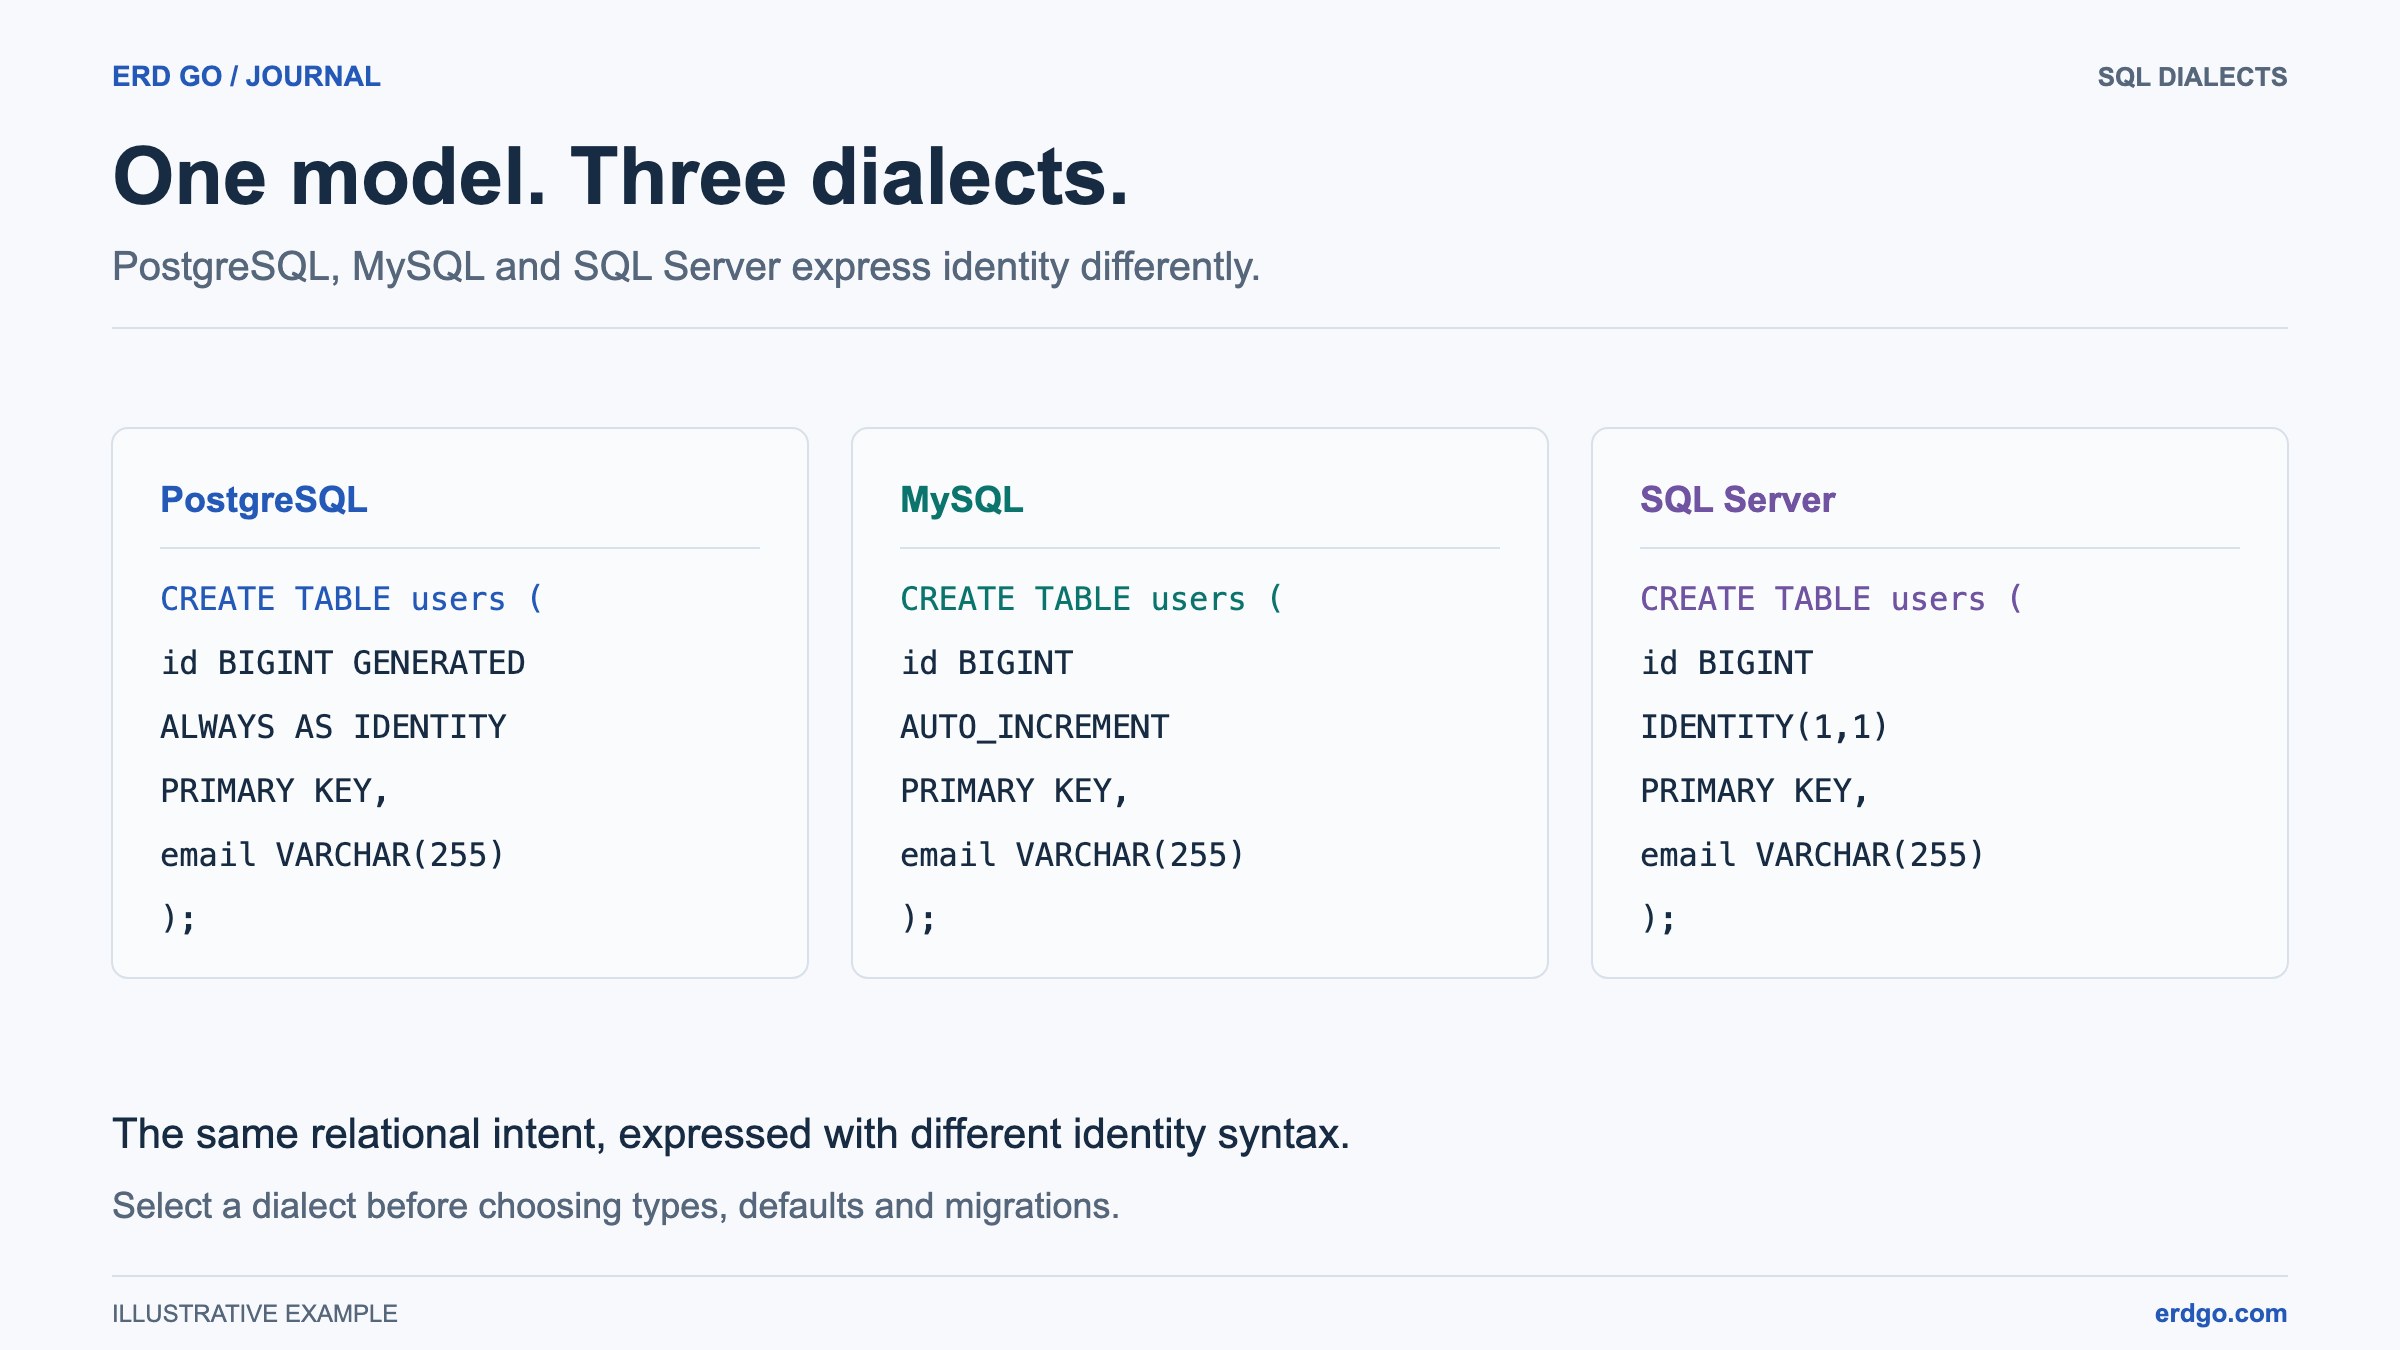
Przykłady SQL używają PostgreSQL, chyba że wymieniono inny dialekt. Krótkie fragmenty zakładają, że tabele, do których się odwołują, już istnieją. Zweryfikuj DDL w docelowej bazie danych przed jego zastosowaniem.
Czym są indeksy bazy danych?
Jeden indeks to struktura danych utrzymywana przez silnik bazy danych, która zapewnia szybką ścieżkę wyszukiwania wierszy w tabeli. W przypadku filtrów selektywnych indeks może ograniczyć liczbę odczytywanych wierszy lub stron. Optymalizator może nadal wybrać skanowanie tabeli w przypadku małych tabel lub zapytań zwracających wiele wierszy. Zmierz plan i czas zamiast zakładać stałe przyspieszenie.
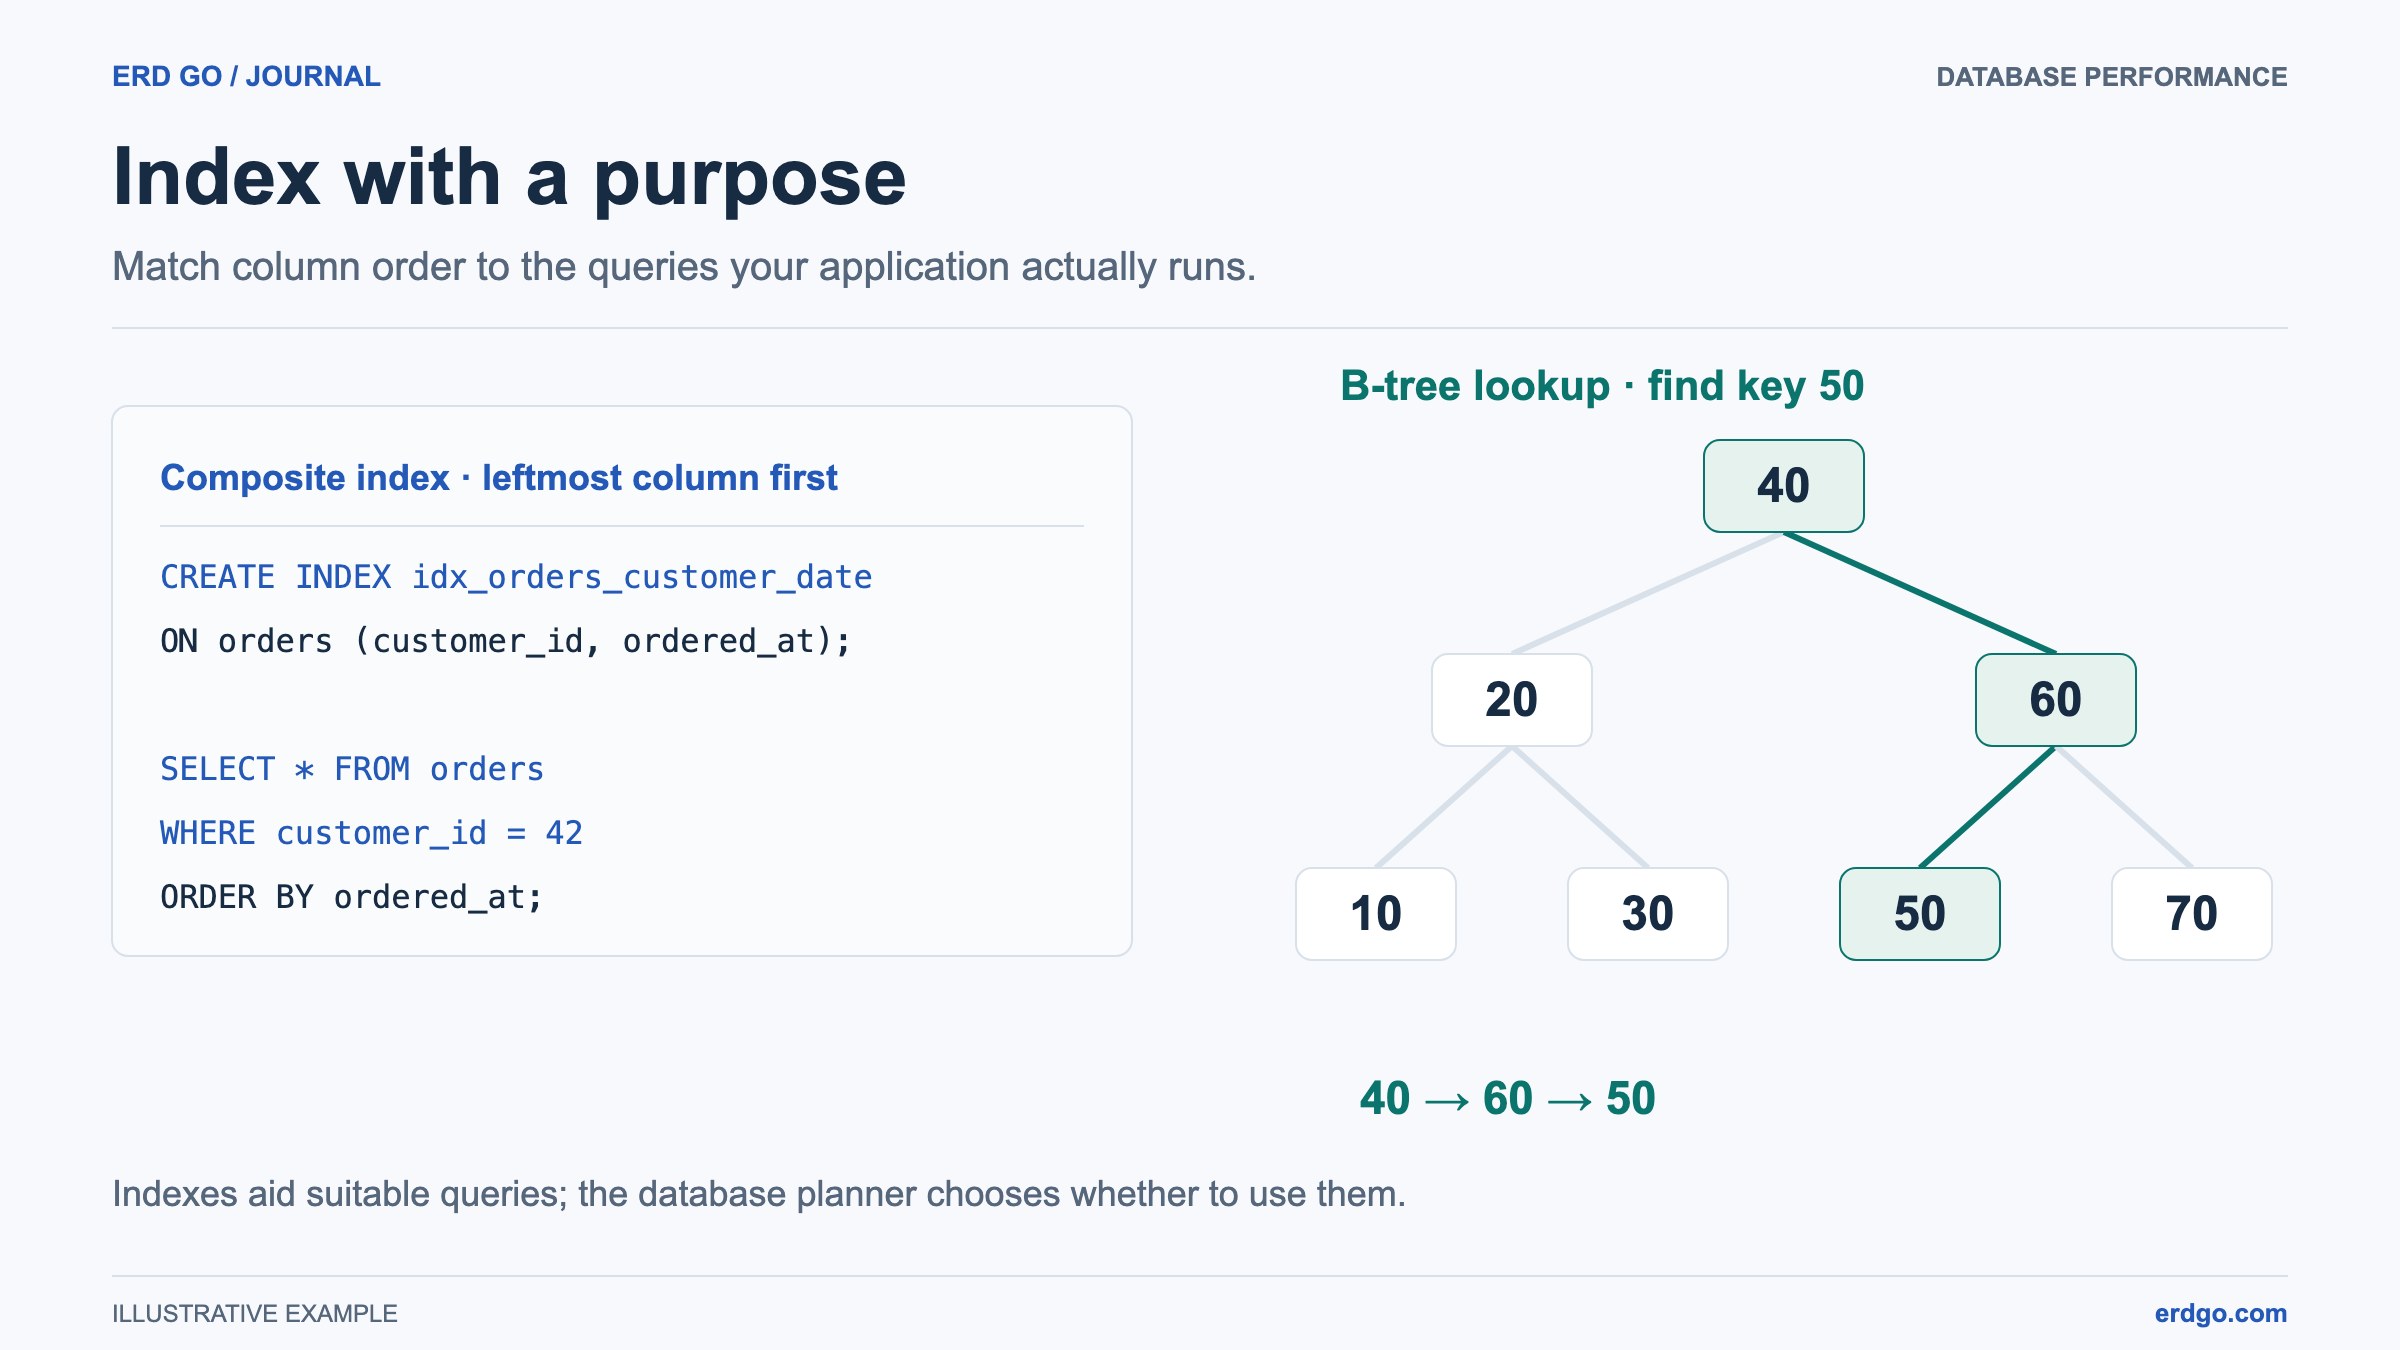
Jak działają indeksy B-drzewa
Najczęstszym typem indeksu w PostgreSQL, MySQL, SQL Server i SQLite jest B-drzewo (zrównoważone drzewo). Pomyśl o tym jak o książce telefonicznej: zamiast czytać każde nazwisko od A do Z, otwierasz na przybliżonej sekcji, zawężasz do właściwej strony i trafiasz na wpis. B-drzewo działa podobnie:
- Drzewo jest zorganizowane w węzły. Każdy węzeł wewnętrzny zawiera posortowane klucze i wskaźniki do węzłów potomnych.
- Wyszukiwanie zaczyna się od root, porównuje szukaną wartość z kluczami węzłów i podąża za właściwym wskaźnikiem w dół przez gałąź węzły.
- Osiąga liść zawierające pasujące wpisy. W zależności od silnika i indeksu, wpisy identyfikują wiersze, zawierają klucz klastrowany lub przechowują same dane wiersza.
- Drzewo pozostaje zrównoważone, ale jego głębokość i operacje we/wy zależą od szerokości klucza, rozmiaru strony, liczby wierszy, buforowania oraz tego, czy Zapytanie pobiera również strony tabeli.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Kiedy należy używać indeksów?
Indeksy nie są darmowe. Zużywają miejsce na dysku i obciążają każdą INSERT, UPDATE, oraz DELETE ponieważ silnik musi utrzymywać synchronizację indeksu z danymi tabeli. Używaj ich strategicznie:
- Kolumny w
WHEREklauzule. Odpowiedni indeks może pomóc w przypadku częstego selektywnego filtra; jego korzyść zależy od rozkładu danych i wybranego planu. - Kolumny w
JOINwarunki. Indeksy mogą pomagać w złączeniach kluczy obcych oraz aktualizacjach lub usuwaniu rekordów nadrzędnych; duże złączenie może nadal preferować skanowanie. - Kolumny w
ORDER BYiGROUP BY. Indeks może dostarczać wstępnie posortowane Dane, eliminując kosztowną operację sortowania. - Kolumny o wysokiej kardynalności. Kolumny z wieloma unikalnymi wartościami (takimi jak e-mail lub UUID) zyskują więcej niż kolumny z niewielką liczbą unikalnych wartości (takimi jak boolean
is_activeflaga). - Duże tabele. Tabela ze 100 wierszami rzadko wymaga dodatkowych indeksów. Tabela z 10 milionami wierszy prawie na pewno ich wymaga.
Zgodnie z ogólną zasadą: zacznij bez dodatkowych indeksów, zmierz wydajność zapytania za pomocą EXPLAIN, a następnie dodaj indeksy tam, gdzie wskazują na to Dane.
Typy indeksów
Indeks jednokolumnowy
Najprostsza forma. Tworzy B-drzewo na jednej kolumnie. Idealne dla zapytań, które filtrują lub sortują wyłącznie według tej kolumny.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Indeks złożony (wielokolumnowy)
Indeks na dwóch lub więcej kolumnach. Filtry równości na kolumnach wiodących i zakres na kolejnej często tworzą wydajną ścieżkę dostępu B-drzewa. Inne warunki mogą nadal korzystać ze skanowania lub skanowania z pomijaniem (skip scan); wsparcie i koszt różnią się w zależności od silnika i wersji.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Wybierz kolejność kolumn na podstawie filtrów równości, warunków zakresu, sortowania i potrzeb pokrycia. „Najbardziej selektywne najpierw” nie jest uniwersalną zasadą. PostgreSQL 18 może używać skanowania z pomijaniem B-drzewa dla odpowiednich filtrów niebędących na początku.
Indeks unikalny
Wymusza ograniczenie unikalności, zapewniając jednocześnie wydajność wyszukiwania opartą na indeksach. Większość baz danych automatycznie tworzy unikalny indeks po zdefiniowaniu UNIQUE ograniczenie lub PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Indeks częściowy (filtrowany)
Indeksuje tylko wiersze spełniające WHERE warunek. Dzięki temu indeks pozostaje mały i precyzyjnie ukierunkowany.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Indeks częściowy lub filtrowany może pomóc w przypadku małego, często odpytywanego podzbioru. Predykat zapytania musi implikować filtr. Składnia filtrów SQL Server jest bardziej ograniczona niż w PostgreSQL; nie kopiuj między nimi dowolnych predykatów.
Inne typy indeksów
| Typ indeksu | Najlepsze dla | Wsparcie bazy danych |
|---|---|---|
| Hash | Wyszukiwania dokładnej równości (=) | PostgreSQL, MySQL (silnik Memory) |
| GIN | Wyszukiwanie pełnotekstowe, JSONB, tablice | PostgreSQL |
| GiST | Geometryczne i zakresowe typy danych | PostgreSQL |
| BRIN | Bardzo duże tabele z naturalnie uporządkowanymi danymi | PostgreSQL |
| Pełnotekstowy | Wyszukiwanie tekstowe z rankingiem trafności | MySQL, SQL Server |
Typowe błędy indeksowania
Nawet doświadczeni programiści wpadają w te pułapki. Unikaj ich, aby utrzymać wysoką wydajność bazy danych.
1. Nadmierne indeksowanie
Dodawanie indeksu na każdej kolumnie „na wszelki wypadek” marnuje miejsce na dysku i spowalnia zapisy. Każdy indeks musi być aktualizowany przy każdym wstawieniu, aktualizacji i usunięciu. Tabela z 15 indeksami będzie miała znacznie mniejszą przepustowość zapisu niż tabela z 3 dobrze dobranymi indeksami.
2. Indeksowanie kolumn o niskiej kardynalności
Indeksowanie typu boolean is_active kolumna, która zawiera tylko TRUE i FALSE może być przydatne, gdy wartości są wysoce niesymetryczne lub indeks obejmuje wąskie zapytanie. Sama kardynalność nie decyduje o tym, czy indeks pomaga. Jeśli musisz filtrować po takich kolumnach, połącz je w indeksie złożonym z kolumną o wyższej kardynalności lub użyj indeksu częściowego.
3. Ignorowanie wzorców zapytania
Indeks jest użyteczny tylko wtedy, gdy Twoje rzeczywiste Zapytania mogą go wykorzystać. Zawsze badaj powolne Zapytania w swojej aplikacji najpierw, a następnie zaprojektuj indeksy ukierunkowane na te konkretne wzorce dostępu.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Zapominanie o indeksowaniu kluczy obcych
W PostgreSQL kolumny klucza obcego są nie indeksowane automatycznie (w przeciwieństwie do InnoDB w MySQL, który domyślnie tworzy indeks na kluczach obcych). Indeks może pomóc w selektywnych złączeniach i sprawdzeniach referencyjnych, ale optymalizator może wybrać skanowanie lub złączenie typu hash. Przed dodaniem kolejnego sprawdź, czy istnieje indeks, którego kolumny wiodące już pokrywają klucz obcy.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Brak przeglądu nieużywanych indeksów
Z biegiem czasu kod aplikacji zmienia się, a stare indeksy mogą przestać obsługiwać jakiekolwiek Zapytanie. Nieużywane indeksy nadal zużywają miejsce i spowalniają zapisy, nie dając żadnych korzyści przy odczycie.
Monitorowanie użycia indeksów
Nowoczesne bazy danych udostępniają widoki systemowe, które raportują, jak często używany jest każdy indeks. Regularne ich przeglądanie pomaga usuwać nieużywane indeksy i dostrzegać te brakujące.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Traktuj zero odczytów jako kandydata do przeglądu, a nie pozwolenie na usunięcie indeksu. Sprawdź, kiedy liczniki zostały zresetowane, czy instrumentacja jest włączona oraz czy sezonowe zapytania, ograniczenia lub sprawdzenia kluczy obcych go wymagają. Przetestuj proponowane usunięcie przy reprezentatywnym obciążeniu.
Indeksy w projektowaniu schematów i ERD
Chociaż diagramy ERD koncentrują się głównie na tabelach, kolumnach i relacjach, indeksy są ważną częścią ogólnego projektu schematu. Planując bazę danych, rozważ indeksy wraz z definicjami tabel:
- A klucz główny zazwyczaj posiada ścieżkę dostępu zarządzaną przez silnik. SQLite INTEGER PRIMARY KEY używa rowid zamiast oddzielnego unikalnego indeksu; sprawdź silnik przed dodaniem duplikatu indeksu.
- Przejrzyj ścieżki dostępu dla klucze obce. PostgreSQL nie tworzy automatycznie indeksów po stronie podrzędnej, ale istniejący indeks złożony może już obejmować tę relację.
- Kolumny z Ograniczenia UNIQUE otrzymują automatyczny indeks unikalny.
- Dodatkowe indeksy dla często odpytywanych kolumn powinny być udokumentowane wraz z DDL schematu, aby nie zostały pominięte podczas wdrażania.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Zwizualizuj swój pełny schemat — tabele, relacje i kolumny, które planujesz indeksować — wklejając swój DDL do Edytor Erd Go. Wizualne zapoznanie się ze strukturą często ujawnia kolumny wymagające indeksowania (takie jak często łączone klucze obce), które można przeoczyć podczas czytania surowego SQL.