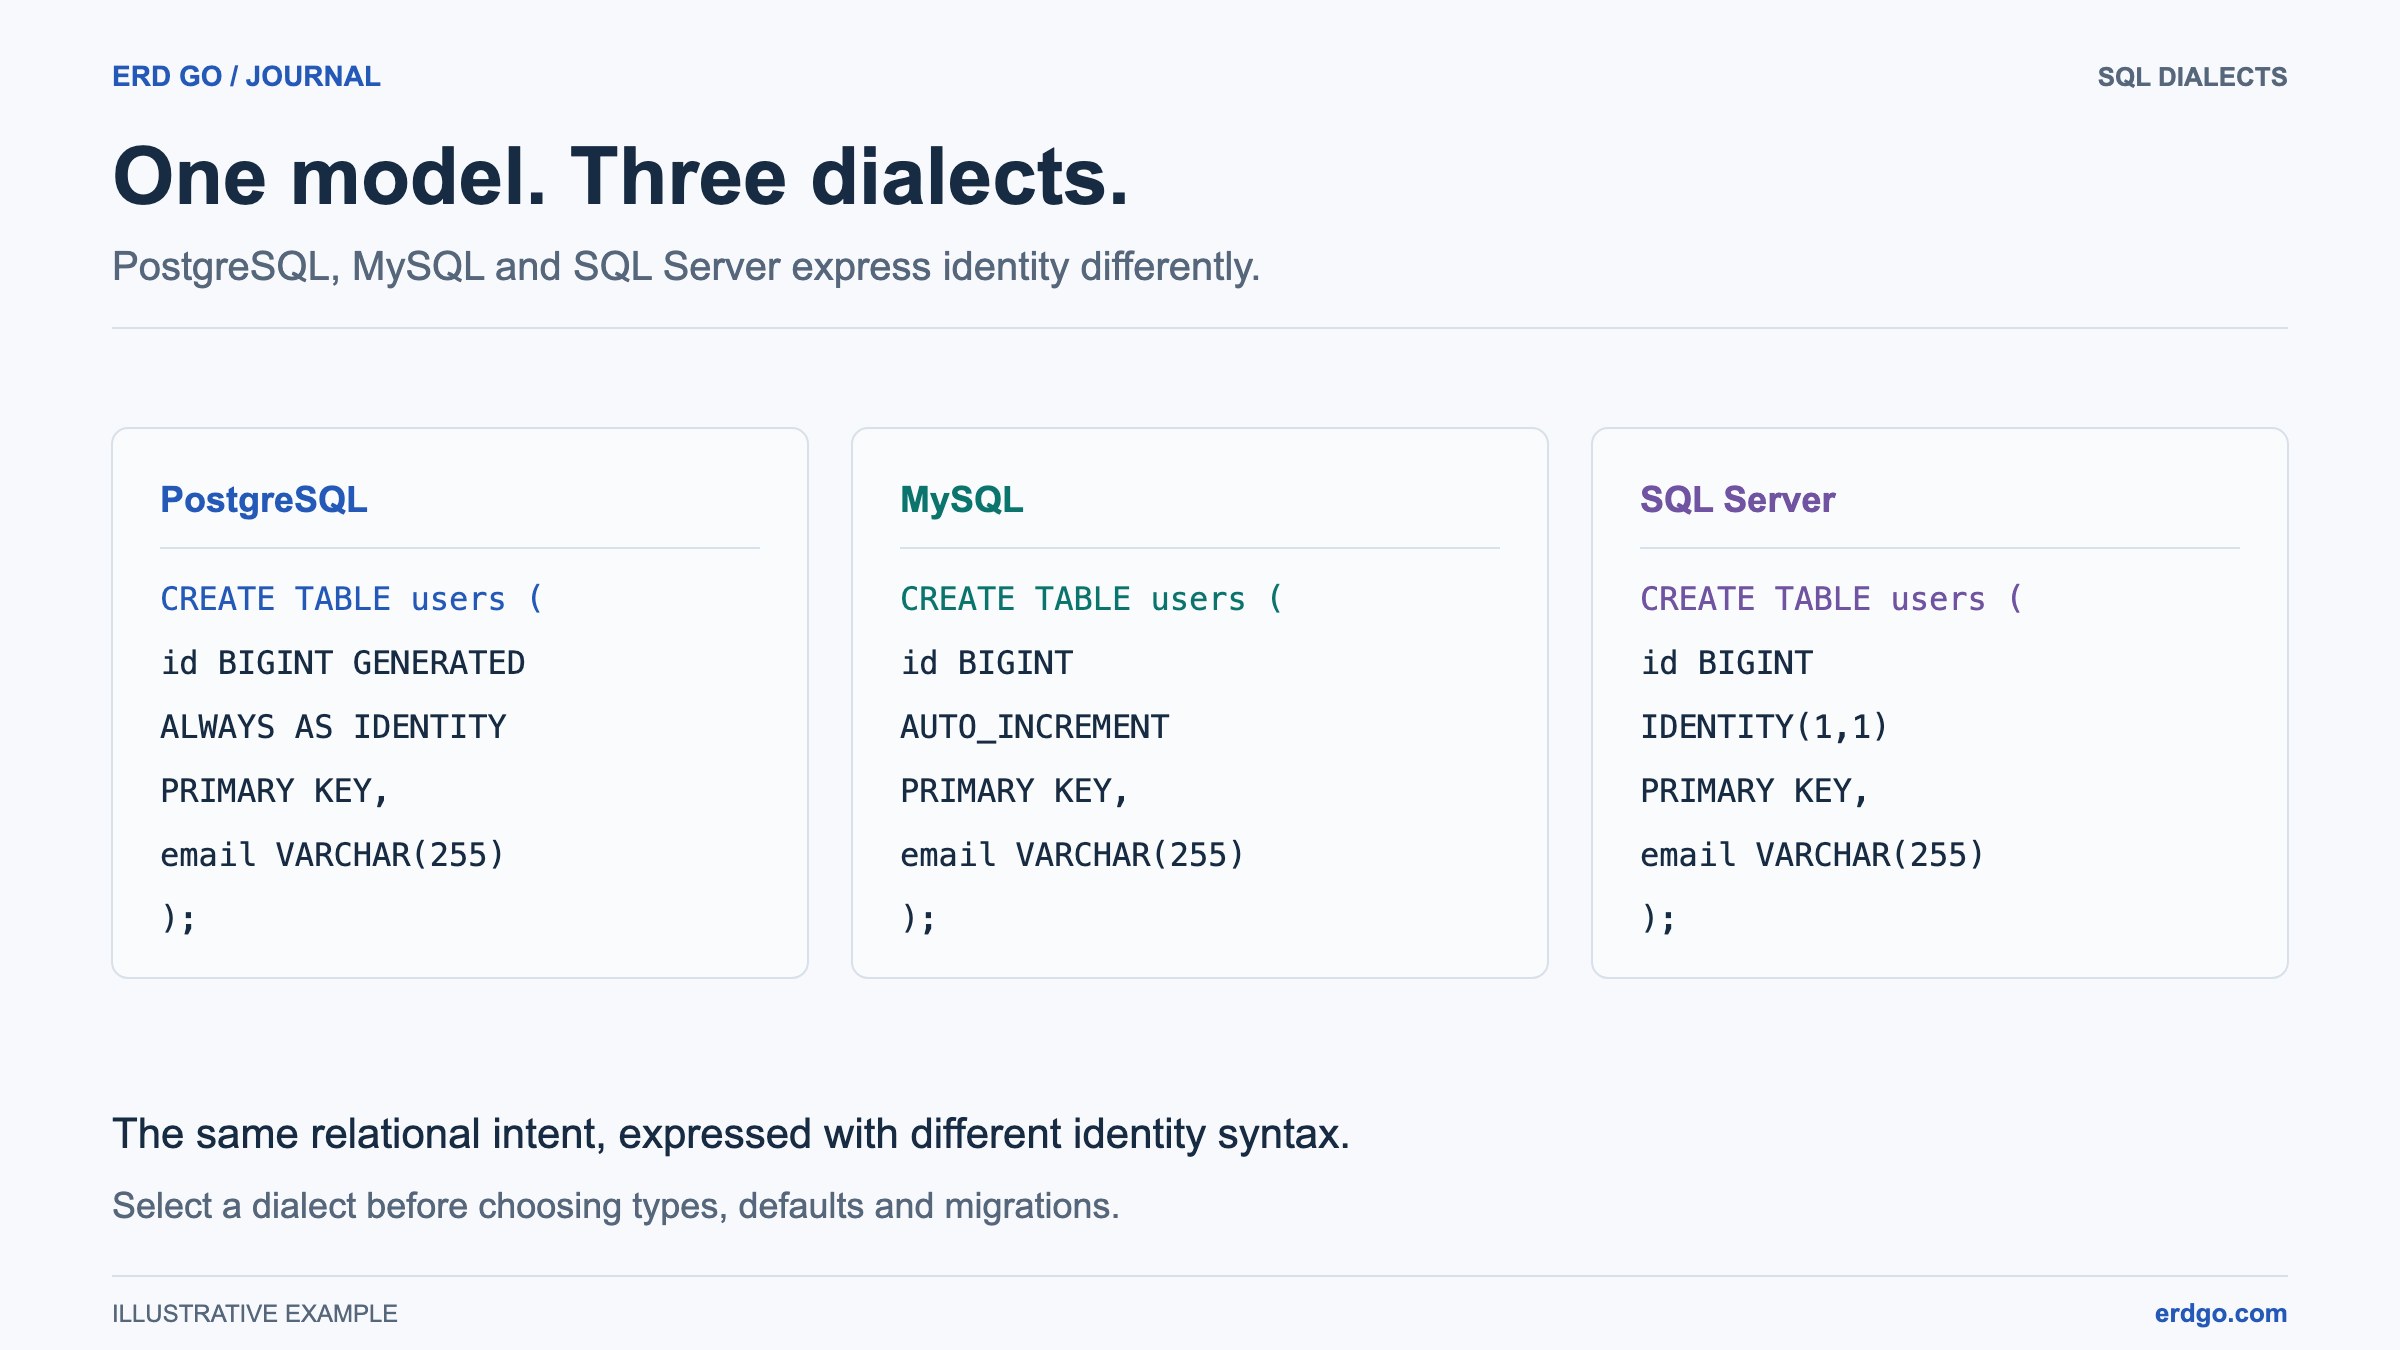
SQL-voorbeelden gebruiken PostgreSQL, tenzij een andere dialect wordt genoemd. Korte fragmenten gaan ervan uit dat hun verwijderde tabellen al bestaan. Valideer DDL in uw doeldatabase voordat u deze toepast.
Wat Zijn Database-indexen?
Een index is een gegevensstructuur die wordt onderhouden door de database-engine en die een snel opzoekpad biedt naar rijen in een tabel. Voor selectieve filters kan een index het aantal gelezen rijen of pagina's verminderen. De optimizer kan nog steeds kiezen voor een tabelscan voor kleine tabellen of queries die veel rijen retourneren. Meet het plan en de timing in plaats van uit te gaan van een vaste snelheidsverhoging.
Hoe B-Tree-indexen werken
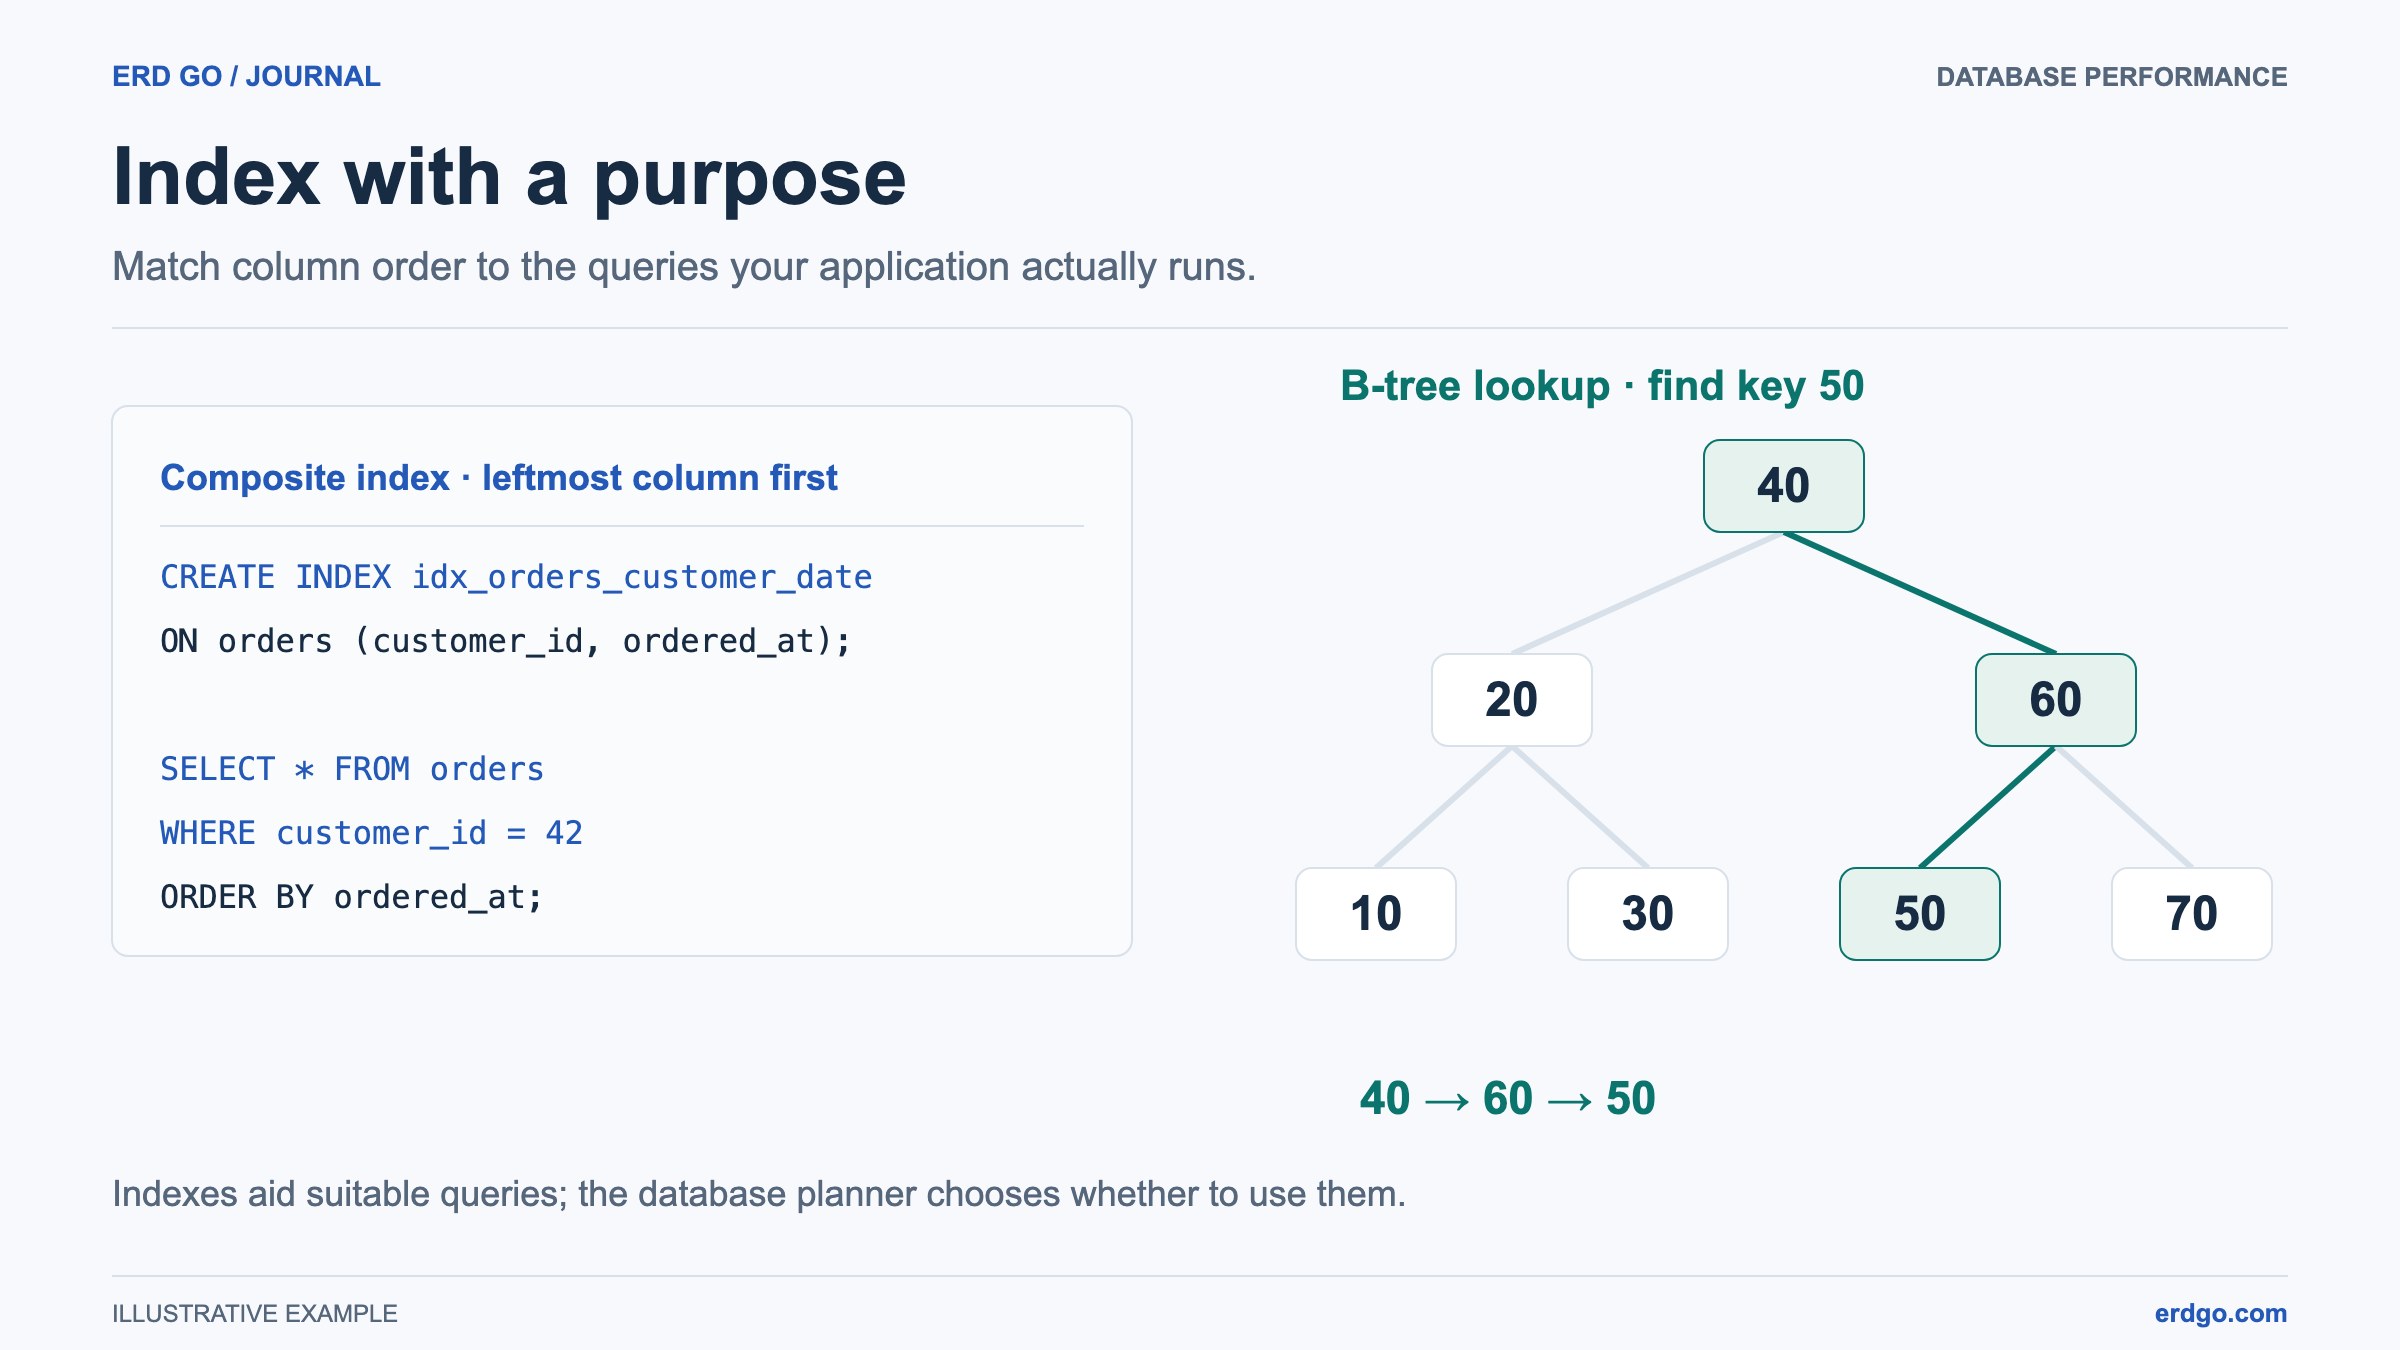
Het meest voorkomende index type op PostgreSQL, MySQL, SQL Server en SQLite is de B-tree (gebalanceerde boom). Denk aan een telefoongids: in plaats van elke naam van A tot Z te lezen, sla je de gids open bij de juiste sectie, zoom je in op de juiste pagina en kom je uit bij het item. Een B-boom werkt op vergelijkbare wijze:
- De boom is georganiseerd in knooppunten. Elk intern knooppunt bevat gesorteerde sleutels en verwijzingen naar onderliggende knooppunten.
- Een opzoeking begint bij de root, vergelijkt de zoekwaarde met knooppuntsleutels en volgt de juiste wijzer omlaag door tak knooppunten.
- Het bereikt een blad met overeenkomende vermeldingen. Afhankelijk van de engine en index identificeren vermeldingen rijen, bevatten ze een geclusterde sleutel of bevatten ze de rijgegevens zelf.
- De boom blijft gebalanceerd, maar de diepte en I/O zijn afhankelijk van de breedte van de sleutel, de paginagrootte, het aantal rijen, de caching en of de query ook tabelpagina's ophaalt.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Wanneer moet je indexen gebruiken?
Indexen zijn niet gratis. Ze verbruiken schijfruimte en voegen overhead toe aan elke INSERT, UPDATE, en DELETE omdat de engine de index synchroon moet houden met de tabelgegevens. Gebruik ze strategisch:
- Kolommen in
WHEREclausules. Een geschikte index kan helpen bij een frequent selectief filter; het voordeel hangt af van de gegevensdistributie en het gekozen plan. - Kolommen in
JOINcondities. Indexen kunnen helpen bij joins van vreemde sleutels en updates of verwijderingen van ouders; een grote join kan nog steeds de voorkeur geven aan een scan. - Kolommen in
ORDER BYenGROUP BY. Een index kan vooraf gesorteerde gegevens opleveren, waardoor een dure sorteerbewerking overbodig wordt. - Kolommen met een hoge cardinaliteit. Kolommen met veel distincte waarden (zoals e-mail of UUID) profiteren hier meer van dan kolommen met weinig distincte waarden (zoals een booleaanse waarde
is_activevlag). - Grote tabellen. Een tabel met 100 rijen heeft zelden extra indexen nodig. Een tabel met 10 miljoen rijen vrijwel zeker wel.
Als algemene regel: beginnen zonder extra indexen, meet de queryprestaties met EXPLAIN, voeg dan indexen toe waar de gegevens aangeven dat dit nodig is.
Typen indexen
Index met één kolom
De eenvoudigste vorm. Creëert een B-boom op één kolom. Ideaal voor queries die filteren of sorteren op die kolom alleen.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Samengestelde (multikolom) index
Een index op twee of meer kolommen. Gelijkheidsfilters op leidende kolommen en een bereik op de volgende vormen vaak een efficiënt B-tree toegangspad. Andere voorwaarden kunnen nog steeds gebruikmaken van een scan of skip-scan; ondersteuning en kosten variëren per engine en versie.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Kies de kolomvolgorde op basis van gelijkheidsfilters, bereikvoorwaarden, sortering en dekkingsbehoeften. "Meest selectief eerst" is geen universele regel. PostgreSQL 18 kan B-tree skip scans gebruiken voor geschikte niet-leidende filters.
Unieke index
Handhaaft een uniekheidsbeperking en biedt tegelijkertijd indexgebaseerde zoekprestaties. De meeste databases maken automatisch een unieke index aan wanneer u een UNIQUE constraint of PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Gedeeltelijke (gefilterde) index
Indexeert alleen de rijen die voldoen aan een WHERE conditie. Dit houdt de index klein en zeer gericht.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Een gedeeltelijke of gefilterde index kan helpen bij een kleine, vaak opgevraagde subset. Het querypredikaat moet de filter impliceren. De filtersyntaxis van SQL Server is beperkter dan die van PostgreSQL; kopieer geen willekeurige predikaten hiertussen.
Overige indextypen
| Indextype | Beste voor | Databaseondersteuning |
|---|---|---|
| Hash | Exacte gelijkheidszoekopdrachten (=) | PostgreSQL, MySQL (Memory-engine) |
| GIN | Full-text zoeken, JSONB, arrays | PostgreSQL |
| GiST | Geometrische en bereikgegevenstypen | PostgreSQL |
| BRIN | Zeer grote tabellen met natuurlijk geordende gegevens | PostgreSQL |
| Volledige tekst | Tekst zoeken met relevantie-ranking | MySQL, SQL Server |
Veelvoorkomende indexeerfouten
Zelfs ervaren ontwikkelaars trappen in deze vallen. Vermijd ze om uw database goed te laten presteren.
1. Overmatige indexering
Het toevoegen van een index op elke kolom "voor de zekerheid" verspilt schijfruimte en vertraagt schrijfbewerkingen. Elke index moet worden bijgewerkt bij elke insert, update en delete. Een tabel met 15 indexen zal een aanzienlijk tragere schrijfdoorvoer hebben dan een tabel met 3 zorgvuldig gekozen indexen.
2. Indexering van kolommen met een lage kardinaliteit
Een booleaanse waarde indexeren is_active kolom die alleen bevat TRUE en FALSE kan nuttig zijn wanneer waarden sterk scheef zijn of de index een smalle query dekt. Kardinaliteit alleen bepaalt niet of een index helpt. Als u op dergelijke kolommen moet filteren, combineer ze dan in een samengestelde index met een kolom met een hogere kardinaliteit, of gebruik een gedeeltelijke index.
3. Querypatronen negeren
Een index is alleen nuttig als uw daadwerkelijke queries er gebruik van kunnen maken. Onderzoek altijd de trage queries in uw toepassing eerst, en ontwerp vervolgens indexen die zich richten op die specifieke toegangspatronen.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Vergeten om vreemde sleutels te indexeren
In PostgreSQL zijn vreemde-sleutelkolommen niet automatisch geïndexeerd (in tegenstelling tot MySQL's InnoDB, dat standaard een index op vreemde sleutels aanmaakt). Een index kan selectieve joins en referentiële controles helpen, maar de optimizer kan een scan of hash join kiezen. Controleer op een bestaande index waarvan de leidende kolommen al overeenkomen met de vreemde sleutel voordat u er nog een toevoegt.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Ongebruikte indexen nooit beoordelen
Na verloop van tijd verandert applicatiecode en dienen oude indexen mogelijk geen enkel doel meer voor queries. Ongebruikte indexen verbruiken nog steeds opslagruimte en vertragen schrijfbewerkingen zonder leesvoordeel.
Indexgebruik bewaken
Moderne databases bieden systeemweergaven die rapporteren hoe vaak elk index wordt gebruikt. Regelmatig controleren hiervan helpt je ongebruikte indexen te verwijderen en ontbrekende te ontdekken.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Beschouw nul-reads als een kandidaat voor beoordeling, niet als toestemming om een index te verwijderen. Controleer wanneer tellers zijn gereset, of instrumentatie is ingeschakeld, en of seizoensgebonden query's, beperkingen of vreemde-sleutelcontroles dit nodig hebben. Test een voorgestelde verwijdering met een representatieve workload.
Indexen in Schemadesign en ERD's
Hoewel ERD's zich primair richten op tabellen, kolommen en relaties, zijn indexen een belangrijk onderdeel van het algemene schemadesign. Houd bij het plannen van je database rekening met indexen naast je tabeldefinities:
- A primaire sleutel heeft normaal gesproken een door de engine beheerd toegangspad. SQLite INTEGER PRIMARY KEY gebruikt de rowid in plaats van een aparte unieke index; controleer de engine voordat u een dubbele index toevoegt.
- Bekijk toegangspaden voor vreemde sleutels. PostgreSQL maakt niet automatisch indexen aan de kindzijde aan, maar een bestaande samengestelde index dekt de relatie mogelijk al af.
- Kolommen met UNIEKE beperkingen krijgen automatisch een unieke index.
- Extra indexen voor vaak bevraagde kolommen moeten worden gedocumenteerd naast uw schema-DDL zodat ze niet worden vergeten tijdens de implementatie.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualiseer uw volledige schema—tabellen, relaties en de kolommen die u wilt indexeren—door uw DDL te plakken in de Erd Go-editor. Het visueel bekijken van de structuur onthult vaak kolommen die geïndexeerd moeten worden (zoals vaak gekoppelde vreemde sleutels) die u over het hoofd zou kunnen zien bij het lezen van ruwe SQL.