다른 방언이 명시되지 않는 한 SQL 예제는 PostgreSQL을 사용합니다. 짧은 코드 조각은 참조된 테이블이 이미 존재한다고 가정합니다. 적용하기 전에 대상 데이터베이스에서 DDL을 검증하세요.
데이터베이스 정규화란 무엇인가요?
데이터베이스 정규화 데이터 중복을 줄이고 데이터 무결성을 향상시키기 위해 관계형 데이터베이스를 구성하는 프로세스입니다. 1970년대 Edgar F. Codd에 의해 도입된 정규화(normalization)는 큰 테이블을 더 작고 관련된 테이블로 나누고 그들 사이의 관계를 정의하는 것을 포함합니다.
목표는 종속성을 일관되게 표현하고 피할 수 있는 중복을 줄이는 것입니다. 판매 가격과 같은 이력 스냅샷은 서로 다른 사실을 나타내므로 다른 테이블에 속할 수 있습니다.
왜 정규화해야 하나요?
- 중복 제거 — 동일한 데이터를 여러 곳에 저장하지 마세요.
- 갱신 이상 방지 — 데이터 변경은 한 곳에서만 일어나면 됩니다.
- 삽입 이상 방지 — 관련 없는 데이터 없이도 새로운 데이터를 추가할 수 있습니다.
- 삭제 이상 방지 — 레코드를 삭제해도 관련 없는 데이터가 실수로 제거되지 않습니다.
- 유지 관리 가능한 쿼리 지원 — 명확한 종속성은 쿼리를 추론하기 쉽게 만듭니다. 성능은 액세스 패턴, 인덱스 및 조인에 따라 달라집니다. 정규화만으로는 쿼리 속도가 빨라지지 않습니다.
제1정규형 (1NF)
테이블이 다음에 있습니다: 1NF 다음의 경우:
- 각 열에는 원자적(분할 불가능한) 값만 포함됩니다.
- 각 열은 단일 유형의 값을 포함합니다
- 행은 후보 키로 구분할 수 있습니다. SQL에서 선택한 식별자를 강제하려면 기본 키를 선언하세요.
- 반복되는 그룹이나 배열이 없습니다.
제1정규형(1NF) 전 (위반 중)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
1NF 이후
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
제2정규형 (2NF)
테이블이 다음에 있습니다: 2NF 다음의 경우:
- 이미 제1정규형(1NF) 상태입니다.
- 모든 비기본 속성은 각각에 의존합니다 전체 키의 일부에만 의존하지 않는 후보 키
후보 키는 행을 고유하게 식별하는 최소 속성 집합입니다. 후보 키에 나타나는 속성은 기본 속성입니다. 후보 키가 여러 컬럼을 포함할 때 부분 종속성이 중요해집니다. 후보 키에는 선택된 기본 키뿐만 아니라 대체 고유 식별자도 포함됩니다. 비키 컬럼이 키의 일부에만 종속되는 경우 별도의 테이블로 이동해야 합니다.
제2정규형(2NF) 전 (위반 중)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
2NF 이후
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

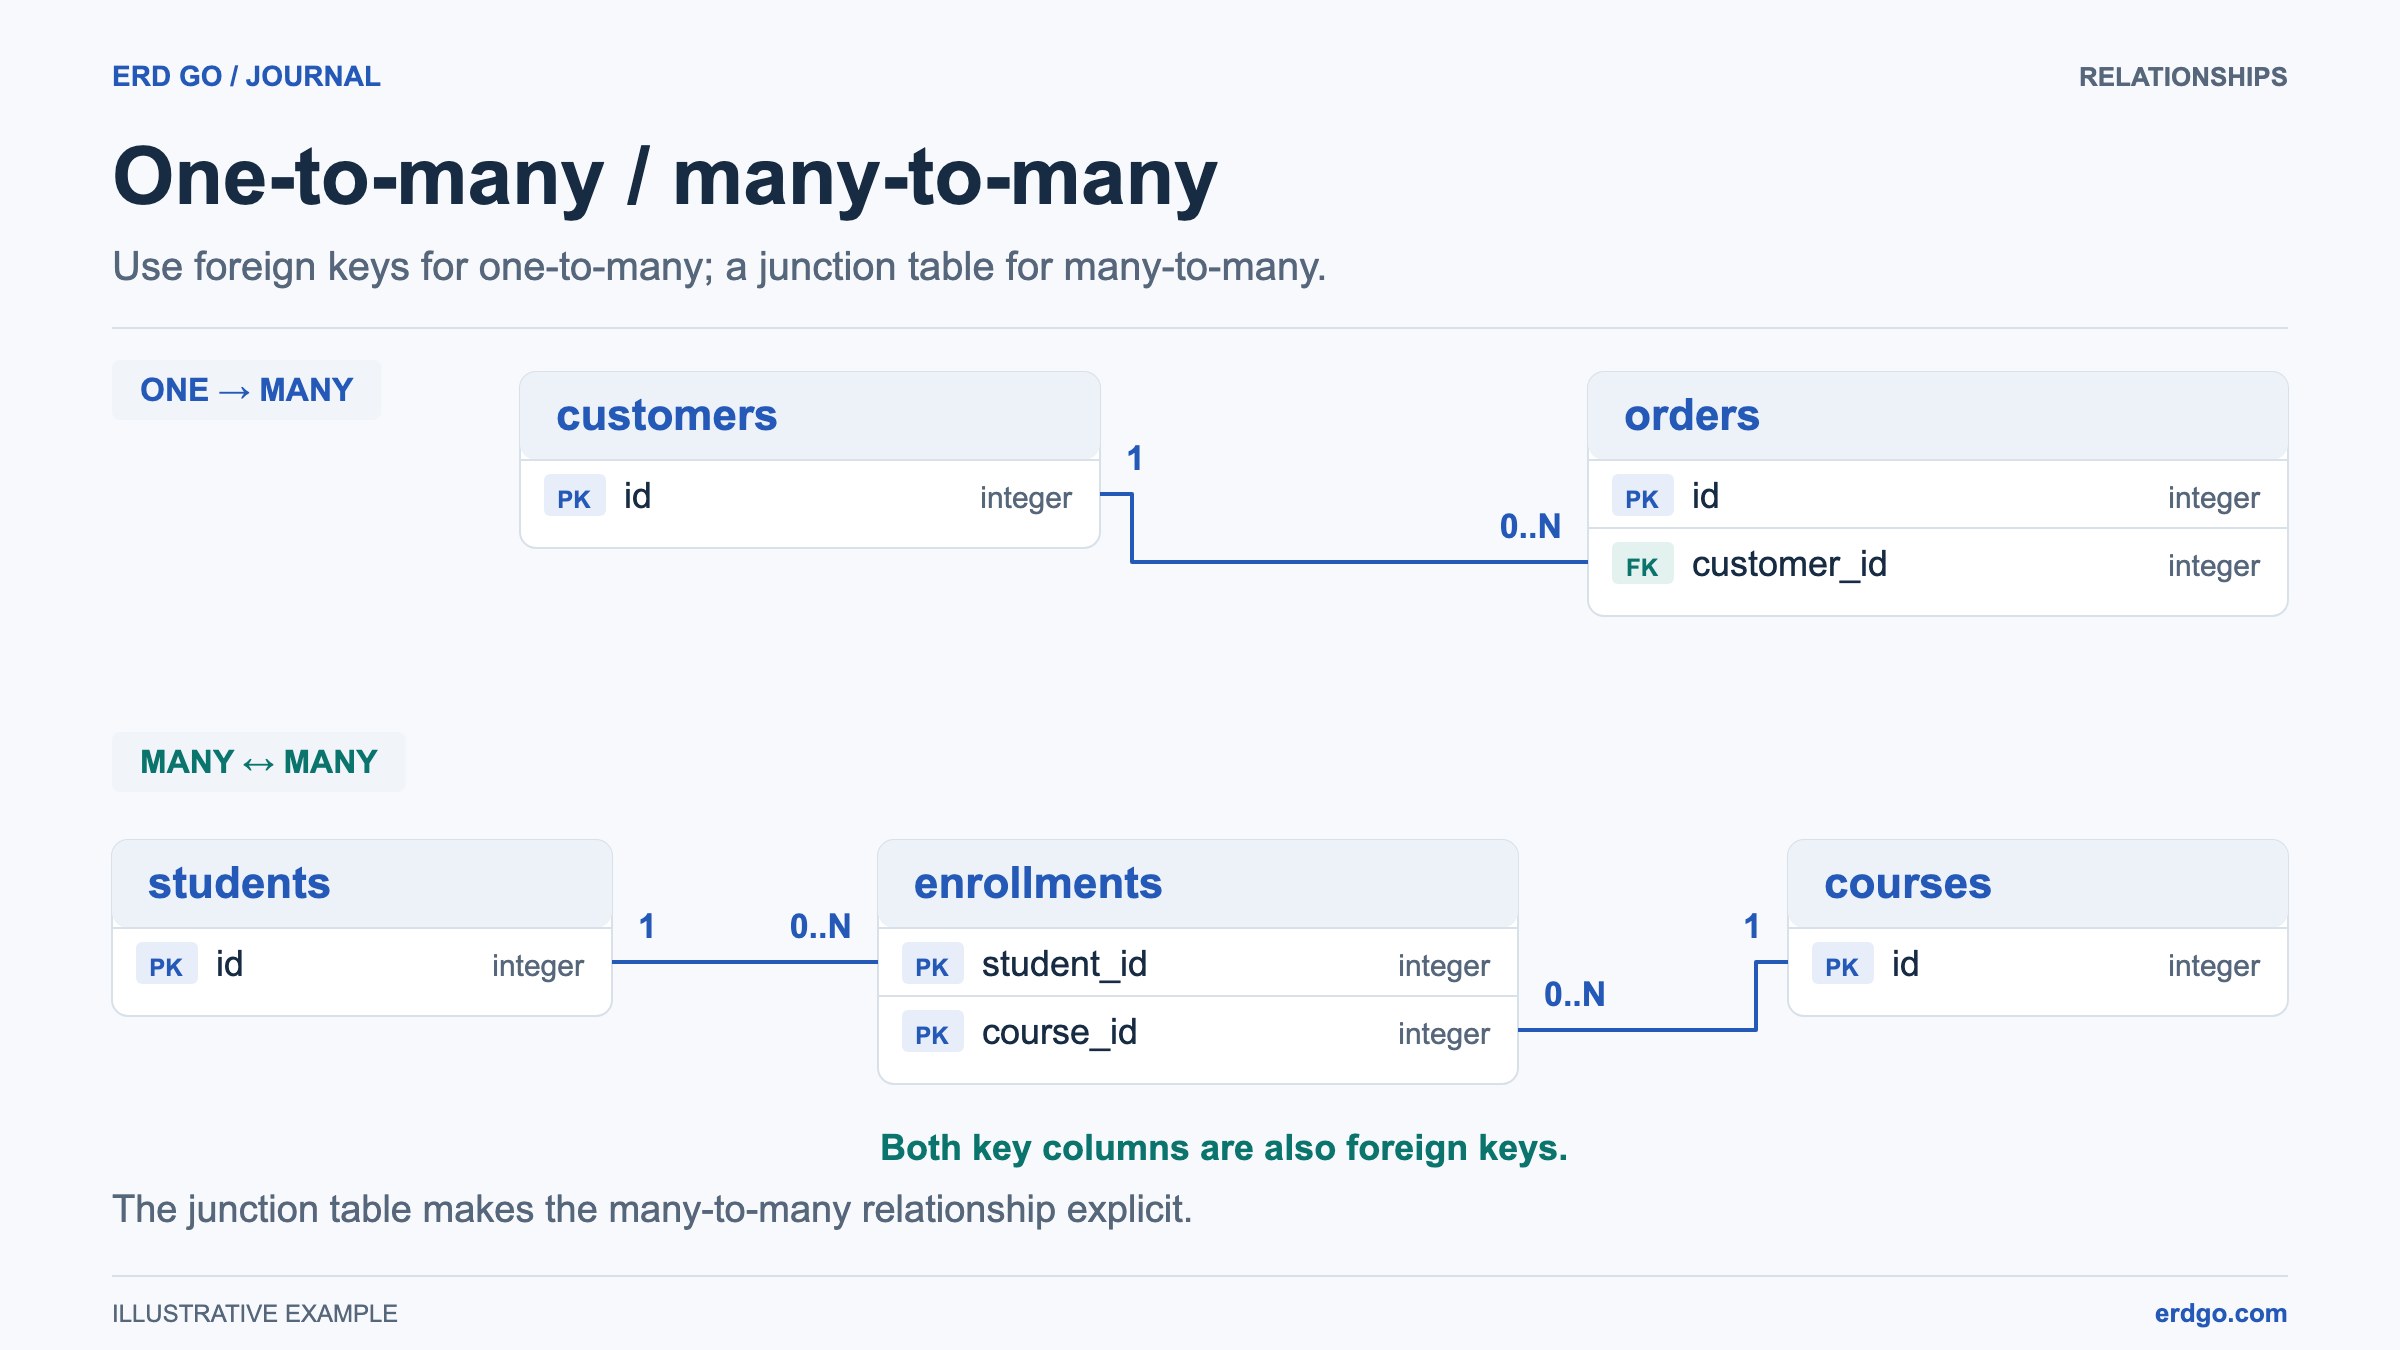
CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
제3정규형 (3NF)
테이블이 다음에 있습니다: 3NF 다음의 경우:
- 이미 제2정규형(2NF) 상태입니다.
- 각 비자명 함수 종속성(nontrivial functional dependency) X → A에 대해, X는 슈퍼키이거나 A는 후보키에 속합니다. 아래 예시에서 이는 키가 아닌 속성 간의 이행적 종속성(transitive dependencies)을 제거합니다.
제3정규형(3NF) 전 (위반 중)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
3NF 이후
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
전체 정규화 예시
제품, 고객, 주소, 주문 및 주문 내역을 분리하는 이커머스 스키마입니다. 나열된 각 식별자가 나머지 속성을 결정한다고 가정하면, 이 테이블들은 예시된 정규형을 충족합니다. 저장된 판매 가격은 현재 제품 가격의 복사본이 아니라 과거의 사실입니다.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
이것을 다음에 붙여넣기 Erd Go 편집기 모든 관계가 자동으로 매핑된 시각적 ERD를 확인하기 위해.
비정규화가 필요한 경우
정규화는 일반적으로 좋은 관행이지만, 비정규화가 성능을 향상시키는 경우도 있습니다.
- 읽기 집약적인 워크로드 — 애플리케이션이 쓰는 것보다 읽는 양이 훨씬 많다면, 계산된 데이터나 중복된 데이터를 저장하여 비용이 많이 드는 JOIN을 피할 수 있습니다.
- 보고 및 분석 — 비정규화된 테이블이나 구체화된 뷰는 대시보드에 자주 사용됩니다.
- 핫 데이터 캐싱 — 자주 액세스되는 집계 값을 테이블에 직접 저장합니다.
- NoSQL 스타일 액세스 패턴 — 쿼리에 항상 특정 데이터 조합이 필요할 때.
핵심은 ~하는 것입니다. 먼저 정규화한 다음, 의도적으로 비정규화하세요 성능상 필요한 경우, 트레이드오프가 발생한 이유를 문서화합니다.