다른 방언이 명시되지 않는 한 SQL 예제는 PostgreSQL을 사용합니다. 짧은 코드 조각은 참조된 테이블이 이미 존재한다고 가정합니다. 적용하기 전에 대상 데이터베이스에서 DDL을 검증하세요.
데이터베이스 인덱스란 무엇인가요?
하나의 인덱스 테이블의 행에 대한 빠른 조회 경로를 제공하는 데이터베이스 엔진에서 유지 관리하는 데이터 구조입니다. 선택적 필터의 경우 인덱스는 읽는 행이나 페이지를 줄일 수 있습니다. 옵티마이저는 작은 테이블이나 많은 행을 반환하는 쿼리에 대해 여전히 테이블 스캔을 선택할 수 있습니다. 고정된 속도 향상을 가정하는 대신 실행 계획과 시간을 측정하십시오.
B-Tree 인덱스 작동 방식
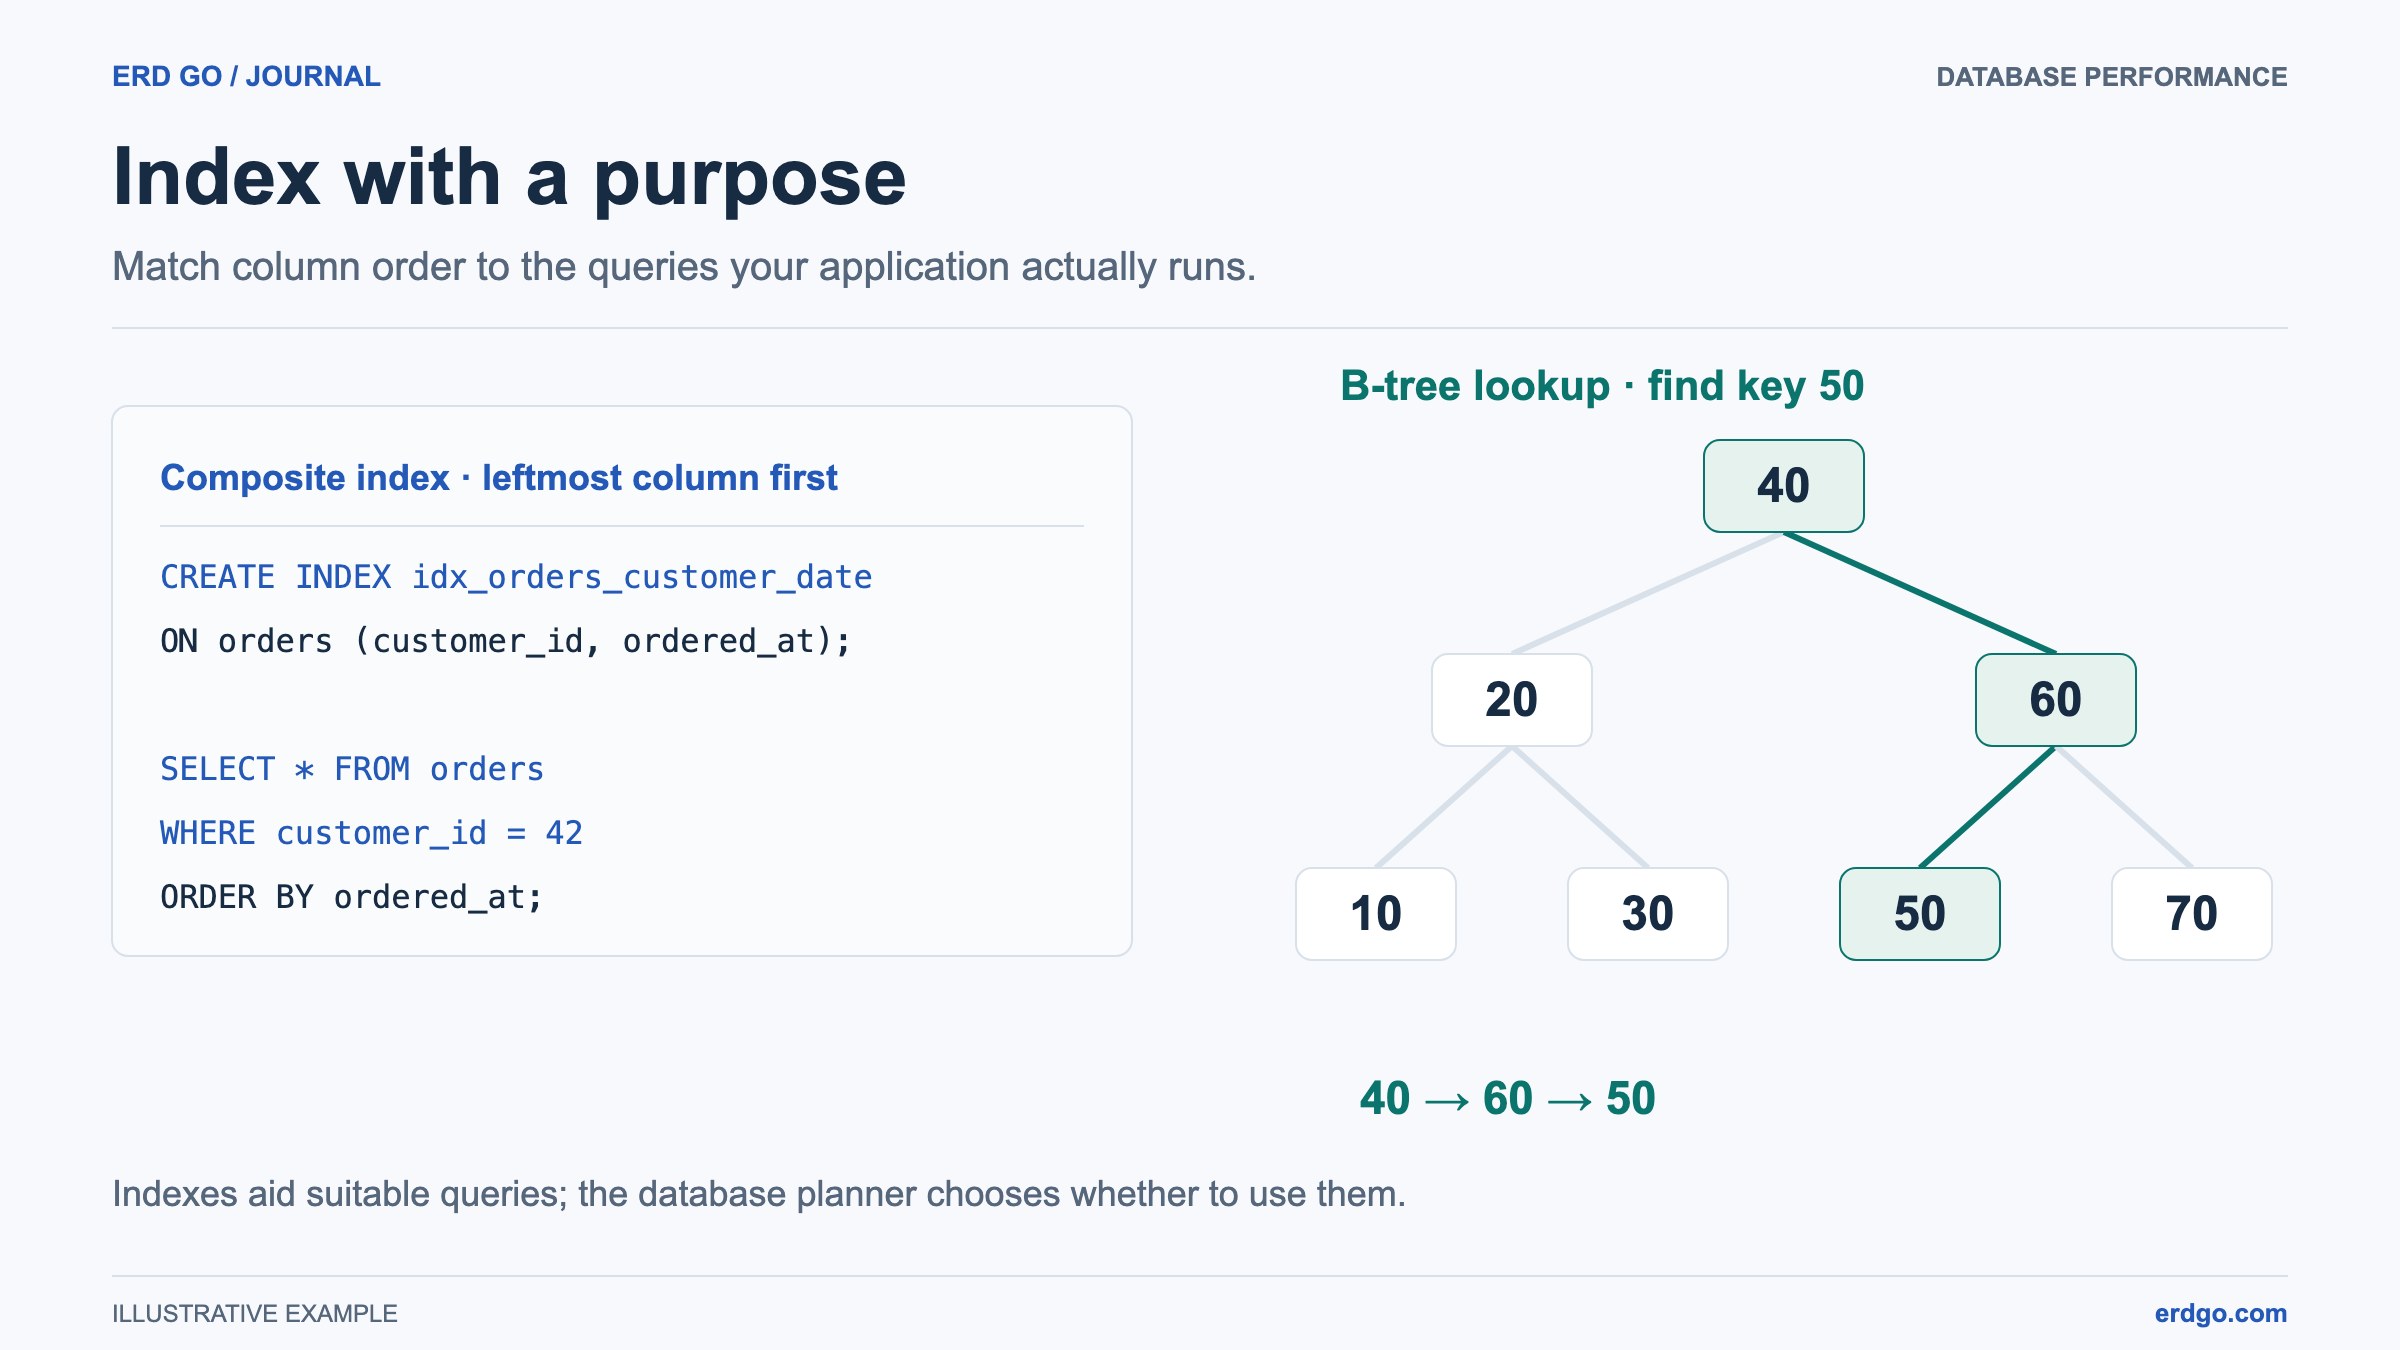
PostgreSQL, MySQL, SQL Server 및 SQLite에서 가장 일반적인 인덱스 유형은 B-트리 (균형 트리). 전화번호부처럼 생각해보세요: A부터 Z까지 모든 이름을 읽는 대신, 대략적인 섹션을 열고, 올바른 페이지로 좁혀가며, 항목을 찾습니다. B-트리도 비슷하게 작동합니다:
- 트리는 다음과 같이 구성됩니다. 노드. 각 내부 노드에는 정렬된 키와 자식 노드에 대한 포인터가 포함되어 있습니다.
- 조회가 다음에서 시작됩니다: 루트, 검색 값을 노드 키와 비교하고 다음을 통해 올바른 포인터를 따라 내려갑니다. 브랜치 노드.
- 다음에 도달합니다 리프 일치하는 항목을 포함합니다. 엔진과 인덱스에 따라 항목은 행을 식별하거나, 클러스터형 키를 포함하거나, 행 데이터 자체를 보유합니다.
- 트리는 균형을 유지하지만, 그 깊이와 I/O는 키 너비, 페이지 크기, 행 수, 캐싱 및 쿼리가 테이블 페이지도 가져오는지 여부에 따라 달라집니다.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
인덱스는 언제 사용해야 하나요?
인덱스는 공짜가 아닙니다. 디스크 공간을 차지하며 모든 작업에 오버헤드를 추가합니다. INSERT, UPDATE, 그리고 DELETE 엔진이 인덱스를 테이블 데이터와 동기화된 상태로 유지해야 하기 때문입니다. 전략적으로 사용하십시오:
- 다음의 컬럼:
WHERE절. 적절한 인덱스는 빈번한 선택적 필터에 도움이 될 수 있습니다. 그 이점은 데이터 분포와 선택된 계획에 따라 달라집니다. - 다음의 컬럼:
JOIN조건. 인덱스는 외래 키 조인 및 부모 업데이트 또는 삭제에 도움이 될 수 있습니다. 대규모 조인은 여전히 스캔을 선호할 수 있습니다. - 다음의 컬럼:
ORDER BY및GROUP BY. 인덱스는 미리 정렬된 데이터를 제공하여 비용이 많이 드는 정렬 작업을 제거할 수 있습니다. - 높은 카디널리티 컬럼. 고유 값이 많은 컬럼(이메일 또는 UUID 등)은 고유 값이 적은 컬럼(불리언 등)보다 더 많은 이점을 얻습니다.
is_active플래그). - 대형 테이블. 100개의 행이 있는 테이블에는 추가 인덱스가 거의 필요하지 않습니다. 1,000만 개의 행이 있는 테이블에는 거의 확실히 필요합니다.
일반적인 규칙으로: 추가 인덱스 없이 시작하고, 다음을 사용하여 쿼리 성능을 측정하세요 EXPLAIN, 그런 다음 데이터가 지시하는 곳에 인덱스를 추가하세요.
인덱스의 유형
단일 열 인덱스
가장 단순한 형태입니다. 하나의 컬럼에 B-트리를 생성합니다. 해당 컬럼만으로 필터링하거나 정렬하는 쿼리에 이상적입니다.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
복합 (다중 열) 인덱스
두 개 이상의 컬럼에 대한 인덱스입니다. 선행 컬럼에 대한 등치 필터와 다음 컬럼에 대한 범위는 종종 효율적인 B-트리 액세스 경로를 형성합니다. 다른 조건은 여전히 스캔 또는 스킵 스캔을 사용할 수 있으며, 지원 여부와 비용은 엔진 및 버전에 따라 다릅니다.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
동등 필터, 범위 조건, 정렬 및 커버리지 요구 사항에 따라 열 순서를 선택하세요. “가장 선택적인 것이 먼저”라는 것은 보편적인 규칙이 아닙니다. PostgreSQL 18은 적절한 비-리딩 필터에 대해 B-트리 스킵 스캔을 사용할 수 있습니다.
고유 인덱스
고유성 제약 조건을 적용하는 동시에 인덱스 기반 조회 성능을 제공합니다. 대부분의 데이터베이스는 사용자가 정의할 때 자동으로 고유 인덱스를 생성합니다. UNIQUE 제약 조건 또는 PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
부분(필터링된) 인덱스
다음을 만족하는 행만 인덱싱합니다. WHERE 조건. 이를 통해 인덱스를 작고 고도로 타겟팅된 상태로 유지합니다.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
부분 또는 필터링된 인덱스는 자주 쿼리되는 작은 하위 집합에 도움이 될 수 있습니다. 쿼리 서술어는 필터를 암시해야 합니다. SQL Server의 필터 구문은 PostgreSQL보다 더 제한적이므로, 둘 사이에 임의의 서술어를 복사하지 마세요.
기타 인덱스 유형
| 인덱스 유형 | 다음에 가장 적합 | 데이터베이스 지원 |
|---|---|---|
| 해시 | 정확한 일치 조회 (=) | PostgreSQL, MySQL (메모리 엔진) |
| GIN | 전체 텍스트 검색, JSONB, 배열 | PostgreSQL |
| GiST | 기하학적 및 범위 데이터 유형 | PostgreSQL |
| BRIN | 자연스럽게 정렬된 데이터가 있는 매우 큰 테이블 | PostgreSQL |
| 전체 텍스트 | 관련성 순위가 포함된 텍스트 검색 | MySQL, SQL Server |
일반적인 인덱싱 실수
숙련된 개발자도 이러한 함정에 빠지곤 합니다. 데이터베이스 성능을 유지하려면 이를 피하십시오.
1. 과도한 인덱싱
“혹시 모르니까” 모든 열에 인덱스를 추가하는 것은 디스크 공간을 낭비하고 쓰기 속도를 늦춥니다. 각 인덱스는 모든 insert, update 및 delete 시마다 업데이트되어야 합니다. 15개의 인덱스가 있는 테이블은 잘 선택된 3개의 인덱스가 있는 테이블보다 쓰기 처리량이 현저히 낮아집니다.
2. 낮은 카디널리티 열 인덱싱
불리언 인덱싱 is_active ~만 포함하는 열 TRUE 및 FALSE 값이 매우 편향되어 있거나 인덱스가 좁은 범위의 쿼리를 다룰 때 유용할 수 있습니다. 카디널리티만으로는 인덱스가 도움이 되는지 여부를 결정하지 않습니다. 이러한 열을 필터링해야 하는 경우 카디널리티가 더 높은 열과 복합 인덱스로 결합하거나 부분 인덱스를 사용하십시오.
3. 쿼리 패턴 무시
인덱스는 실제 쿼리가 이를 활용할 수 있는 경우에만 유용합니다. 항상 애플리케이션의 느린 쿼리를 검토하십시오. 첫 번째, 그런 다음 해당 특정 액세스 패턴을 대상으로 하는 인덱스를 설계하세요.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. 외래 키 인덱싱 누락
PostgreSQL에서 외래 키 컬럼은 아님 자동으로 인덱싱됩니다 (외래 키에 기본적으로 인덱스를 생성하는 MySQL의 InnoDB와는 다릅니다). 인덱스는 선택적 조인 및 참조 확인에 도움이 될 수 있지만, 옵티마이저가 스캔이나 해시 조인을 선택할 수도 있습니다. 다른 인덱스를 추가하기 전에 선행 열이 이미 외래 키를 포함하고 있는 기존 인덱스가 있는지 확인하십시오.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. 사용되지 않는 인덱스를 검토하지 않음
시간이 지남에 따라 애플리케이션 코드가 변경되고 오래된 인덱스는 더 이상 어떠한 쿼리에도 도움이 되지 않을 수 있습니다. 사용되지 않는 인덱스는 읽기 이점이 전혀 없으면서도 여전히 스토리지를 차지하고 쓰기 속도를 늦춥니다.
인덱스 사용량 모니터링
현대적인 데이터베이스는 각 인덱스가 얼마나 자주 사용되는지 보고하는 시스템 뷰를 제공합니다. 이를 정기적으로 검토하면 사용되지 않는 인덱스를 삭제하고 누락된 인덱스를 찾는 데 도움이 됩니다.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
읽기 횟수가 0인 경우를 인덱스 삭제 권한이 아닌 검토 대상으로 취급하세요. 카운터가 재설정된 시점, 계측 활성화 여부, 계절적 쿼리, 제약 조건 또는 외래 키 검사에 필요한지 확인하세요. 대표적인 워크로드로 제안된 삭제를 테스트하세요.
스키마 설계 및 ERD의 인덱스
ERD는 주로 테이블, 열 및 관계에 중점을 두지만, 인덱스는 전체 스키마 설계의 중요한 부분입니다. 데이터베이스를 계획할 때 테이블 정의와 함께 인덱스를 고려하세요.
- A 기본 키 일반적으로 엔진에서 관리하는 액세스 경로를 가집니다. SQLite INTEGER PRIMARY KEY는 별도의 고유 인덱스 대신 rowid를 사용합니다. 중복 인덱스를 추가하기 전에 엔진을 확인하세요.
- 다음에 대한 액세스 경로 검토 외래 키. PostgreSQL은 자식 쪽 인덱스를 자동으로 생성하지 않지만, 기존 복합 인덱스가 이미 관계를 포함하고 있을 수 있습니다.
- 다음을 포함하는 컬럼: UNIQUE 제약 조건 자동 고유 인덱스를 받습니다.
- 자주 쿼리되는 열에 대한 추가 인덱스는 배포 중에 잊어버리지 않도록 스키마 DDL과 함께 문서화해야 합니다.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
DDL을 다음에 붙여넣어 테이블, 관계 및 인덱싱하려는 열을 포함한 전체 스키마를 시각화하세요. Erd Go 편집기. 구조를 시각적으로 보면 원시 SQL을 읽을 때 간과할 수 있는 인덱싱이 필요한 열(자주 조인되는 외래 키 등)이 드러나는 경우가 많습니다.