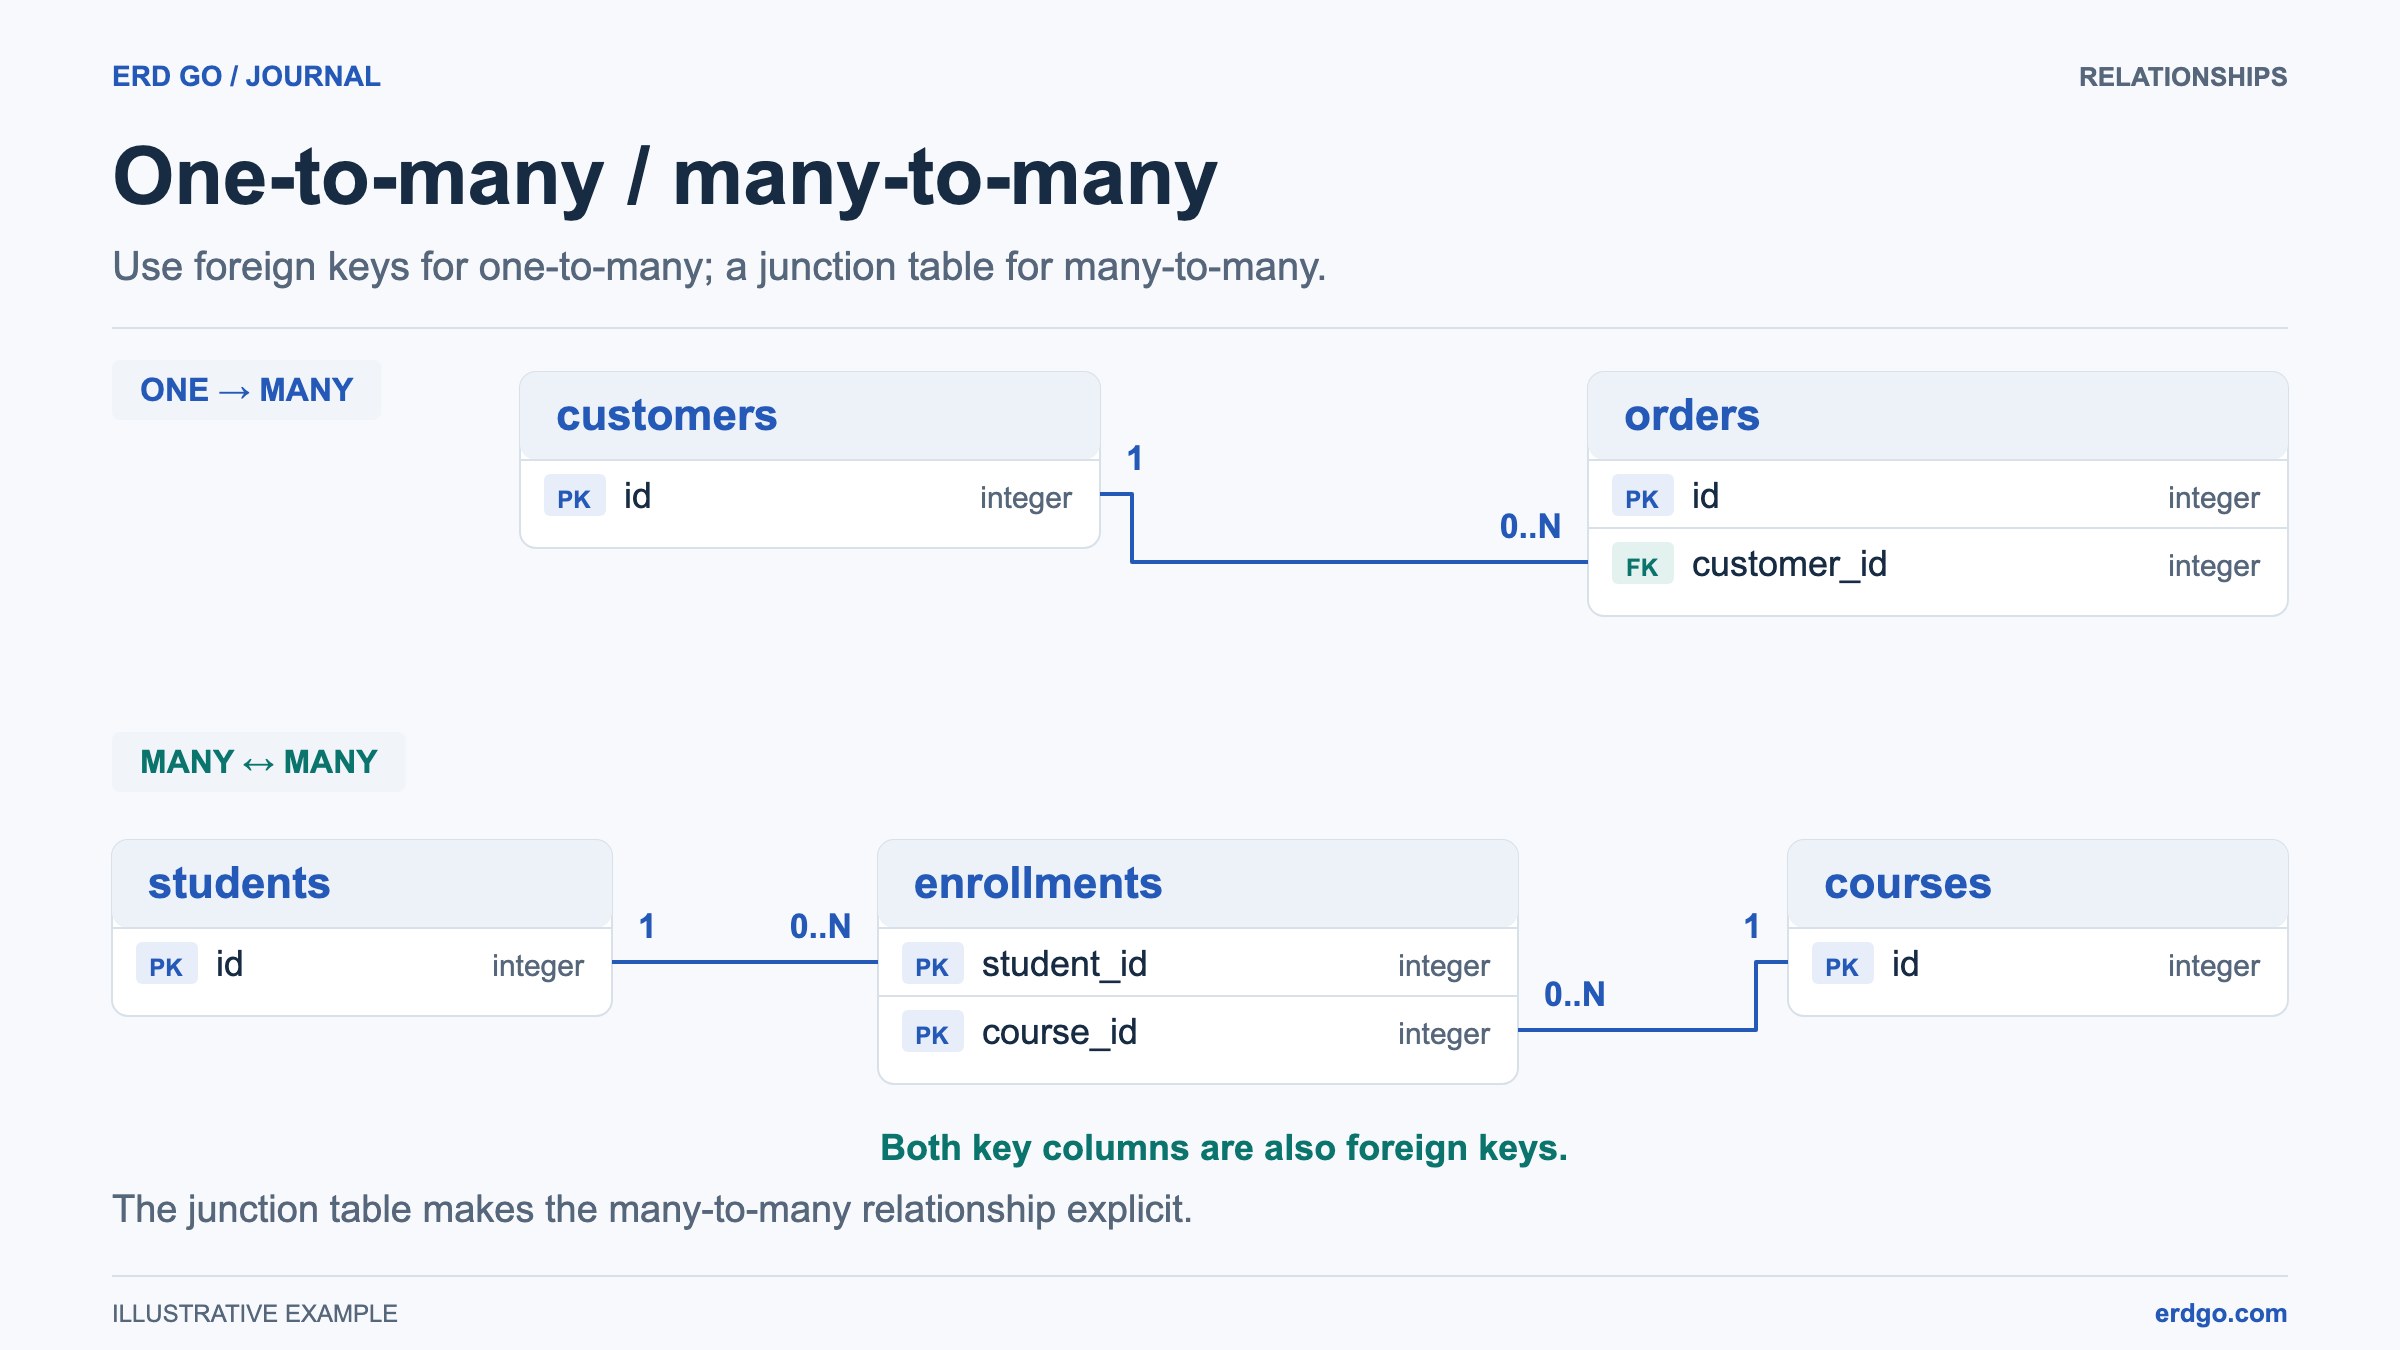
SQL の例では、別のダイアレクトが指定されていない限り PostgreSQL を使用します。短いスニペットは、参照されているテーブルがすでに存在することを前提としています。適用する前に、ターゲットデータベースで DDL を検証してください。
データベースの正規化とは?
データベース正規化 データの冗長性を減らし、データの整合性を向上させるためにリレーショナルデータベースを整理するプロセスです。1970年代にEdgar F. Coddによって導入された正規化には、大きなテーブルをより小さな関連するテーブルに分割し、それらの間の関係を定義することが含まれます。
目標は、依存関係を一貫して表現し、回避可能な重複を減らすことです。販売価格などの履歴スナップショットは、異なる事実を表しているため、別のテーブルに属する場合があります。
なぜ正規化するのか?
- 冗長性の排除 — 同じデータを複数の場所に保存しないでください。
- 更新異常を防ぐ — データの変更は1か所で行うだけで済みます。
- 挿入異常を防ぐ — 無関係なデータを必要とせずに、新しいデータを追加できます。
- 削除異常を防ぐ — レコードを削除しても、無関係なデータが誤って削除されることはありません。
- 保守可能なクエリをサポート — 依存関係を明確にすることで、クエリの推論が容易になります。パフォーマンスはアクセスパターン、インデックス、結合に依存します。正規化だけでクエリが速くなるわけではありません。
第1正規形 (1NF)
テーブルは次の状態にあります: 第1正規形 (1NF) 次の場合:
- 各列にはアトミック(不可分)な値のみが含まれます
- 各列には単一の型の値が含まれます
- 行は候補キーによって識別可能です。SQL で選択した識別子を強制するには、主キーを宣言します。
- 繰り返しグループや配列はありません
第1正規形以前(違反)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
第1正規化 (1NF) の後
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
第2正規形 (2NF)
テーブルは次の状態にあります: 第2正規形 (2NF) 次の場合:
- すでに第1正規形(1NF)です
- すべての非プライム属性は各 全体 候補キーであり、キーの一部のみへの依存はありません
候補キーとは、行を一意に識別する属性の最小限のセットです。いずれかの候補キーに現れる属性は主属性です。候補キーが複数の列を含む場合、部分関数従属が重要になります。候補キーには、選択された主キーだけでなく、代替の一意の識別子も含まれます。非キー列がキーの一部のみに依存している場合は、別のテーブルに移動する必要があります。
第2正規形以前(違反)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
第2正規化 (2NF) の後
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
第3正規形 (3NF)
テーブルは次の状態にあります: 第3正規形 (3NF) 次の場合:
- すでに第2正規形(2NF)です
- 自明ではない各関数従属 X → A について、X はスーパーキーであるか、A は候補キーに属します。以下の例では、これにより非キー属性間の推移的従属が削除されます。
第3正規形以前(違反)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
第3正規化 (3NF) の後
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
完全な正規化の例
以下は、商品、顧客、住所、注文、注文明細を分離する e コマースのスキーマです。リストされた各識別子が残りの属性を決定すると仮定すると、これらのテーブルは図示された正規形を満たしています。保存された販売価格は過去の事実であり、現在の製品価格のコピーではありません。
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
これを次へ貼り付けます: Erd Go のエディター すべてのリレーションシップが自動的にマッピングされた視覚的な ERD を表示するために。
非正規化すべきタイミング
正規化は一般的に優れたプラクティスですが、非正規化によってパフォーマンスが向上するケースもあります。
- 読み取りが多いワークロード — アプリケーションの読み取りが書き込みよりもはるかに多い場合、計算されたデータや重複したデータを保存することで、コストの高いJOINを回避できます。
- レポーティングとアナリティクス — 非正規化されたテーブルやマテリアライズドビューは、ダッシュボードによく使用されます。
- ホットデータのキャッシュ — 頻繁にアクセスされる集計値をテーブルに直接保存します。
- NoSQLスタイルのアクセスパターン — クエリが常に特定のデータの組み合わせを必要とする場合。
ポイントは 最初に正規化し、次に意図的に非正規化する パフォーマンスがそれを必要とする場合、なぜそのトレードオフが行われたのかを文書化します。