SQL の例では、別のダイアレクトが指定されていない限り PostgreSQL を使用します。短いスニペットは、参照されているテーブルがすでに存在することを前提としています。適用する前に、ターゲットデータベースで DDL を検証してください。
データベースインデックスとは何か?
1つの インデックス データベースエンジンによって維持されるデータ構造であり、テーブル内の行への高速な検索パスを提供します。選択的なフィルターの場合、インデックスは読み取られる行またはページを減らすことができます。オプティマイザは、小さなテーブルや多くの行を返すクエリに対して、依然としてテーブルスキャンを選択する場合があります。一定の速度向上を想定するのではなく、プランとタイミングを測定してください。
Bツリーインデックスの仕組み
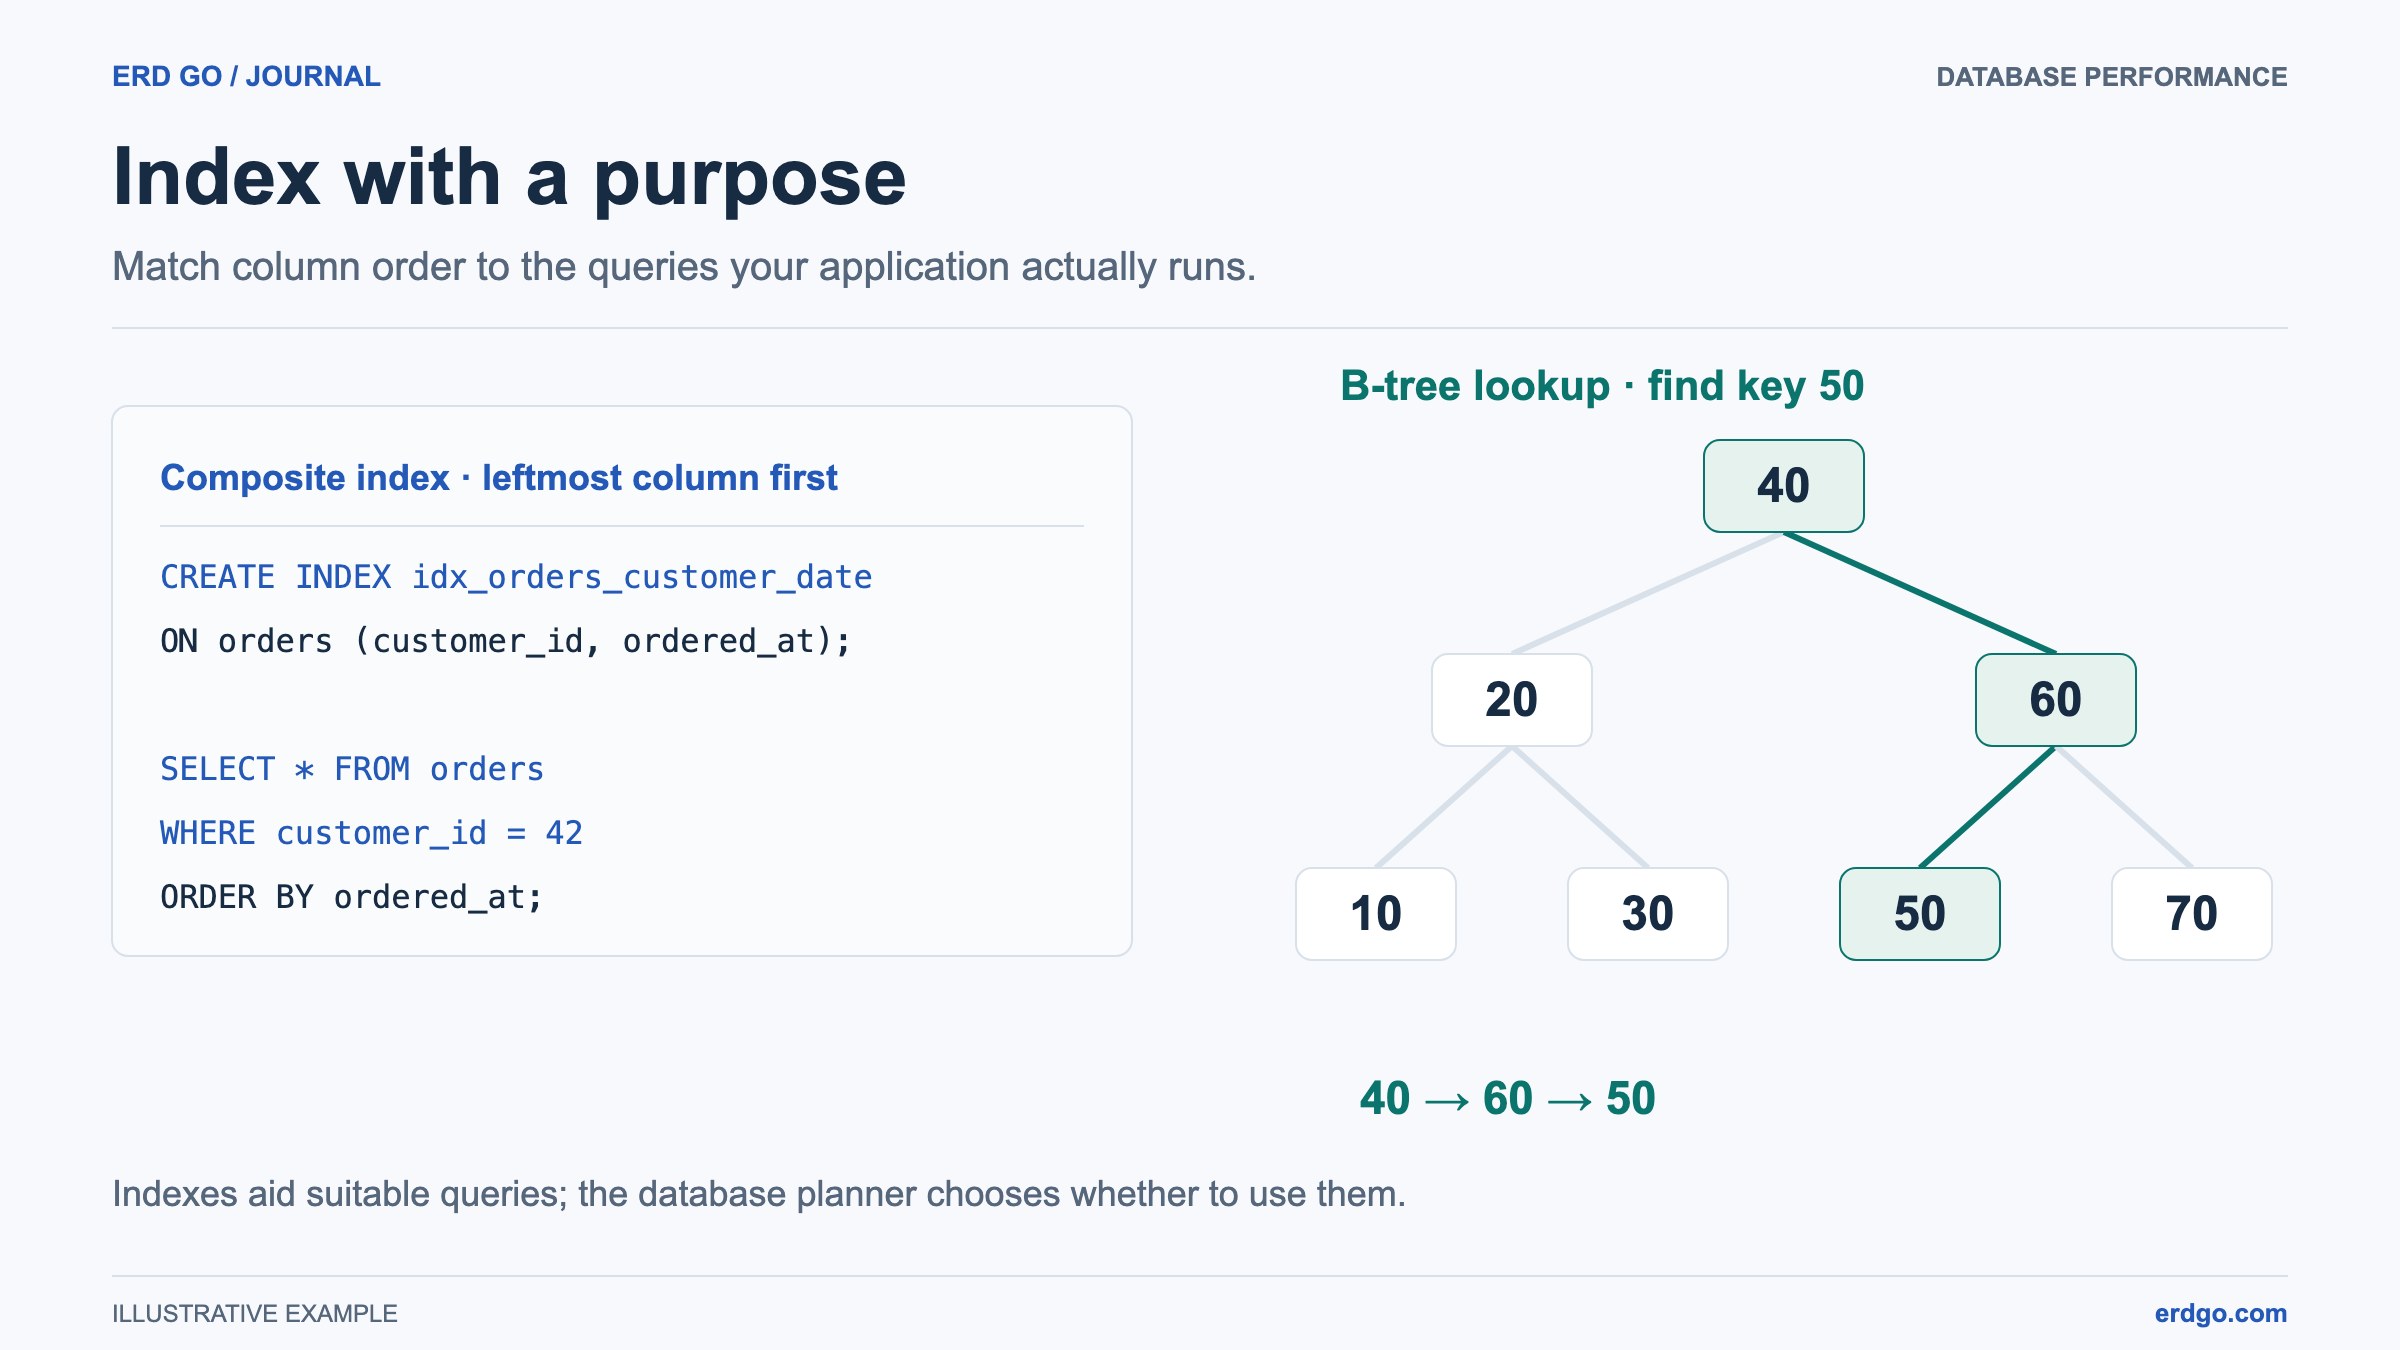
PostgreSQL、MySQL、SQL Server、および SQLite で最も一般的に使用されるインデックスの種類は、 Bツリー (B 樹)。電話帳のようなものです。A から Z まですべての名前を読むのではなく、大体のセクションを開き、適切なページに絞り込んで、エントリにたどり着きます。B ツリーも同様に機能します。
- ツリーは次のように構成されています ノード。各内部ノードには、ソートされたキーと子ノードへのポインタが含まれています。
- ルックアップの開始位置: ルート、検索値をノードキーと比較し、次の場所を通じて正しいポインタを下に辿ります: ブランチ ノード。
- に到達します リーフ 一致するエントリを含みます。エンジンとインデックスに応じて、エントリは行を識別したり、クラスタードキーを含んだり、行データ自体を保持したりします。
- ツリーのバランスは保たれますが、その深さと I/O はキーの幅、ページサイズ、行数、キャッシュ、およびクエリがテーブルページも取得するかどうかによって異なります。
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
インデックスはいつ使用すべきですか?
インデックスは無料ではありません。ディスクスペースを消費し、すべてにオーバーヘッドを追加します INSERT, UPDATE、および DELETE エンジンはインデックスをテーブルデータと同期させる必要があるためです。戦略的に使用してください:
- の列
WHERE句。 適切なインデックスは、頻繁な選択的フィルターに役立ちます。その利点は、データの分布と選択されたプランによって異なります。 - の列
JOIN条件。 インデックスは、外部キーの結合や親の更新または削除に役立つ場合があります。大きな結合では、依然としてスキャンが有利になることがあります。 - の列
ORDER BYおよびGROUP BY. インデックスは、事前にソートされたデータを提供し、コストのかかるソート操作を排除できます。 - 高カーディナリティの列。 (email や UUID のように) 異なる値が多い列は、(ブール値のように) 異なる値が少ない列よりも効果的です
is_activeフラグ)。 - 大きなテーブル。 100 行のテーブルに追加のインデックスが必要になることはめったにありません。1,000 万行のテーブルでは、ほぼ確実に追加のインデックスが必要です。
一般規則として: 余分なインデックスなしで開始し、...でクエリのパフォーマンスを測定します。 EXPLAIN、データが示す場所にインデックスを追加します。
インデックスの種類
単一カラムインデックス
最もシンプルな形式。1 つの列に B ツリーを作成します。その列のみでフィルタリングまたは並べ替えを行うクエリに最適です。
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
複合(マルチカラム)インデックス
2つ以上の列に対するインデックス。先頭の列に対する等価フィルターと次の列の範囲は、多くの場合、効率的な B ツリー アクセス パスを形成します。その他の条件では、スキャンまたはスキップスキャンが引き続き使用される場合があります。サポートとコストは、エンジンとバージョンによって異なります。
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
等価フィルター、範囲条件、ソート、カバレッジのニーズから列の順序を選択します。「最も選択性の高いものを最初に」は普遍的なルールではありません。PostgreSQL 18 では、適切な非先頭フィルターに対して B ツリースキップスキャンを使用できます。
ユニークインデックス
一意性制約を強制すると同時に、インデックスに基づいたルックアップパフォーマンスを提供します。ほとんどのデータベースでは、次を定義すると自動的に一意インデックスが作成されます: UNIQUE 制約または PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
部分(フィルタリング済み)インデックス
を満たす行のみにインデックスを作成します WHERE 条件。これによりインデックスが小さく保たれ、非常に絞り込まれた状態になります。
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
部分インデックスやフィルタ付きインデックスは、頻繁にクエリされる小さなサブセットに役立ちます。クエリの述語はフィルターを暗示している必要があります。SQL Server のフィルター構文は PostgreSQL よりも制限されているため、両者の間で任意の述語をコピーしないでください。
その他のインデックスタイプ
| インデックス型 | 最適用途 | データベースサポート |
|---|---|---|
| ハッシュ | 完全一致ルックアップ (=) | PostgreSQL、MySQL (Memory エンジン) |
| GIN | 全文検索、JSONB、配列 | PostgreSQL |
| GiST | 幾何学データ型および範囲データ型 | PostgreSQL |
| BRIN | 自然に順序付けられたデータを持つ非常に大きなテーブル | PostgreSQL |
| 全文 | 関連度ランキング付きテキスト検索 | MySQL、SQL Server |
一般的なインデックス作成のミス
経験豊富な開発者でもこれらの罠に陥ります。データベースのパフォーマンスを良好に保つために避けてください。
1. 過剰なインデックス作成
「念のため」にすべての列にインデックスを追加すると、ディスク容量が無駄になり、書き込みが遅くなります。各インデックスは、すべての INSERT、UPDATE、および DELETE で更新する必要があります。15 個のインデックスを持つテーブルは、適切に選択された 3 個のインデックスを持つテーブルよりも、書き込みスループットが大幅に低下します。
2. 低カーディナリティ列のインデックス作成
ブール値のインデックス作成 is_active 〜のみを含む列 TRUE および FALSE 値が極端に偏っている場合や、インデックスが狭い範囲のクエリをカバーする場合に役立ちます。カーディナリティだけでインデックスが効果的かどうかは決まりません。そのような列でフィルタリングする必要がある場合は、カーディナリティの高い列と複合インデックスで組み合わせるか、部分インデックスを使用してください。
3. クエリパターンの無視
インデックスは、実際のクエリがそれを活用できる場合にのみ役立ちます。アプリケーション内の遅いクエリを常に調べてください 最初に、それらの特定のアクセスパターンをターゲットとするインデックスを設計します。
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. 外部キーのインデックス付けの忘れ
PostgreSQL では、外部キー列は ではない 自動的にインデックスが作成されません(デフォルトで外部キーにインデックスを作成する MySQL の InnoDB とは異なります)。インデックスは選択的な結合や参照チェックに役立ちますが、オプティマイザはスキャンやハッシュ結合を選択する場合があります。追加する前に、先頭列がすでに外部キーをカバーしている既存のインデックスがあるか確認してください。
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. 未使用のインデックスを確認しないこと
時間が経つにつれてアプリケーションコードは変更され、古いインデックスがどのクエリにも役立たなくなることがあります。未使用のインデックスはストレージを消費し続け、読み取りのメリットがないまま書き込みを遅くします。
インデックス使用状況の監視
最新のデータベースには、各インデックスの使用頻度を報告するシステムビューが用意されています。これらを定期的に確認することで、使用されていないインデックスを削除し、不足しているインデックスを見つけることができます。
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
読み取り回数ゼロをインデックス削除の許可ではなく、レビュー対象として扱います。カウンターがリセットされたタイミング、インストゥルメンテーションが有効か、季節的なクエリ、制約、外部キーチェックで必要かどうかを確認してください。削除を提案する前に、代表的なワークロードでテストしてください。
スキーマ設計と ERD におけるインデックス
ERD は主にテーブル、列、リレーションシップに焦点を当てますが、インデックスもスキーマ設計全体の重要な要素です。データベースを計画する際は、テーブル定義とともにインデックスについても検討してください。
- A 主キー 通常、エンジン管理のアクセスパスがあります。SQLite の INTEGER PRIMARY KEY は、個別のユニークインデックスではなく rowid を使用します。重複するインデックスを追加する前にエンジンを確認してください。
- 次へのアクセスパスをレビューします: 外部キー。PostgreSQL は子側のインデックスを自動的には作成しませんが、既存の複合インデックスがすでにリレーションをカバーしている場合があります。
- 次の列を持つ UNIQUE制約 自動的に一意のインデックスを受け取ります。
- 頻繁にクエリされる列の追加インデックスは、デプロイ時に忘れられないように、スキーマ DDL と一緒に文書化する必要があります。
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
DDLを以下に貼り付けることで、テーブル、リレーションシップ、インデックスを作成する予定の列など、スキーマ全体を視覚化します: Erd Go エディター。構造を視覚的に確認すると、生の SQL を読んでいるときには見落としがちな、インデックスが必要な列(頻繁に結合される外部キーなど)が明らかになることがよくあります。