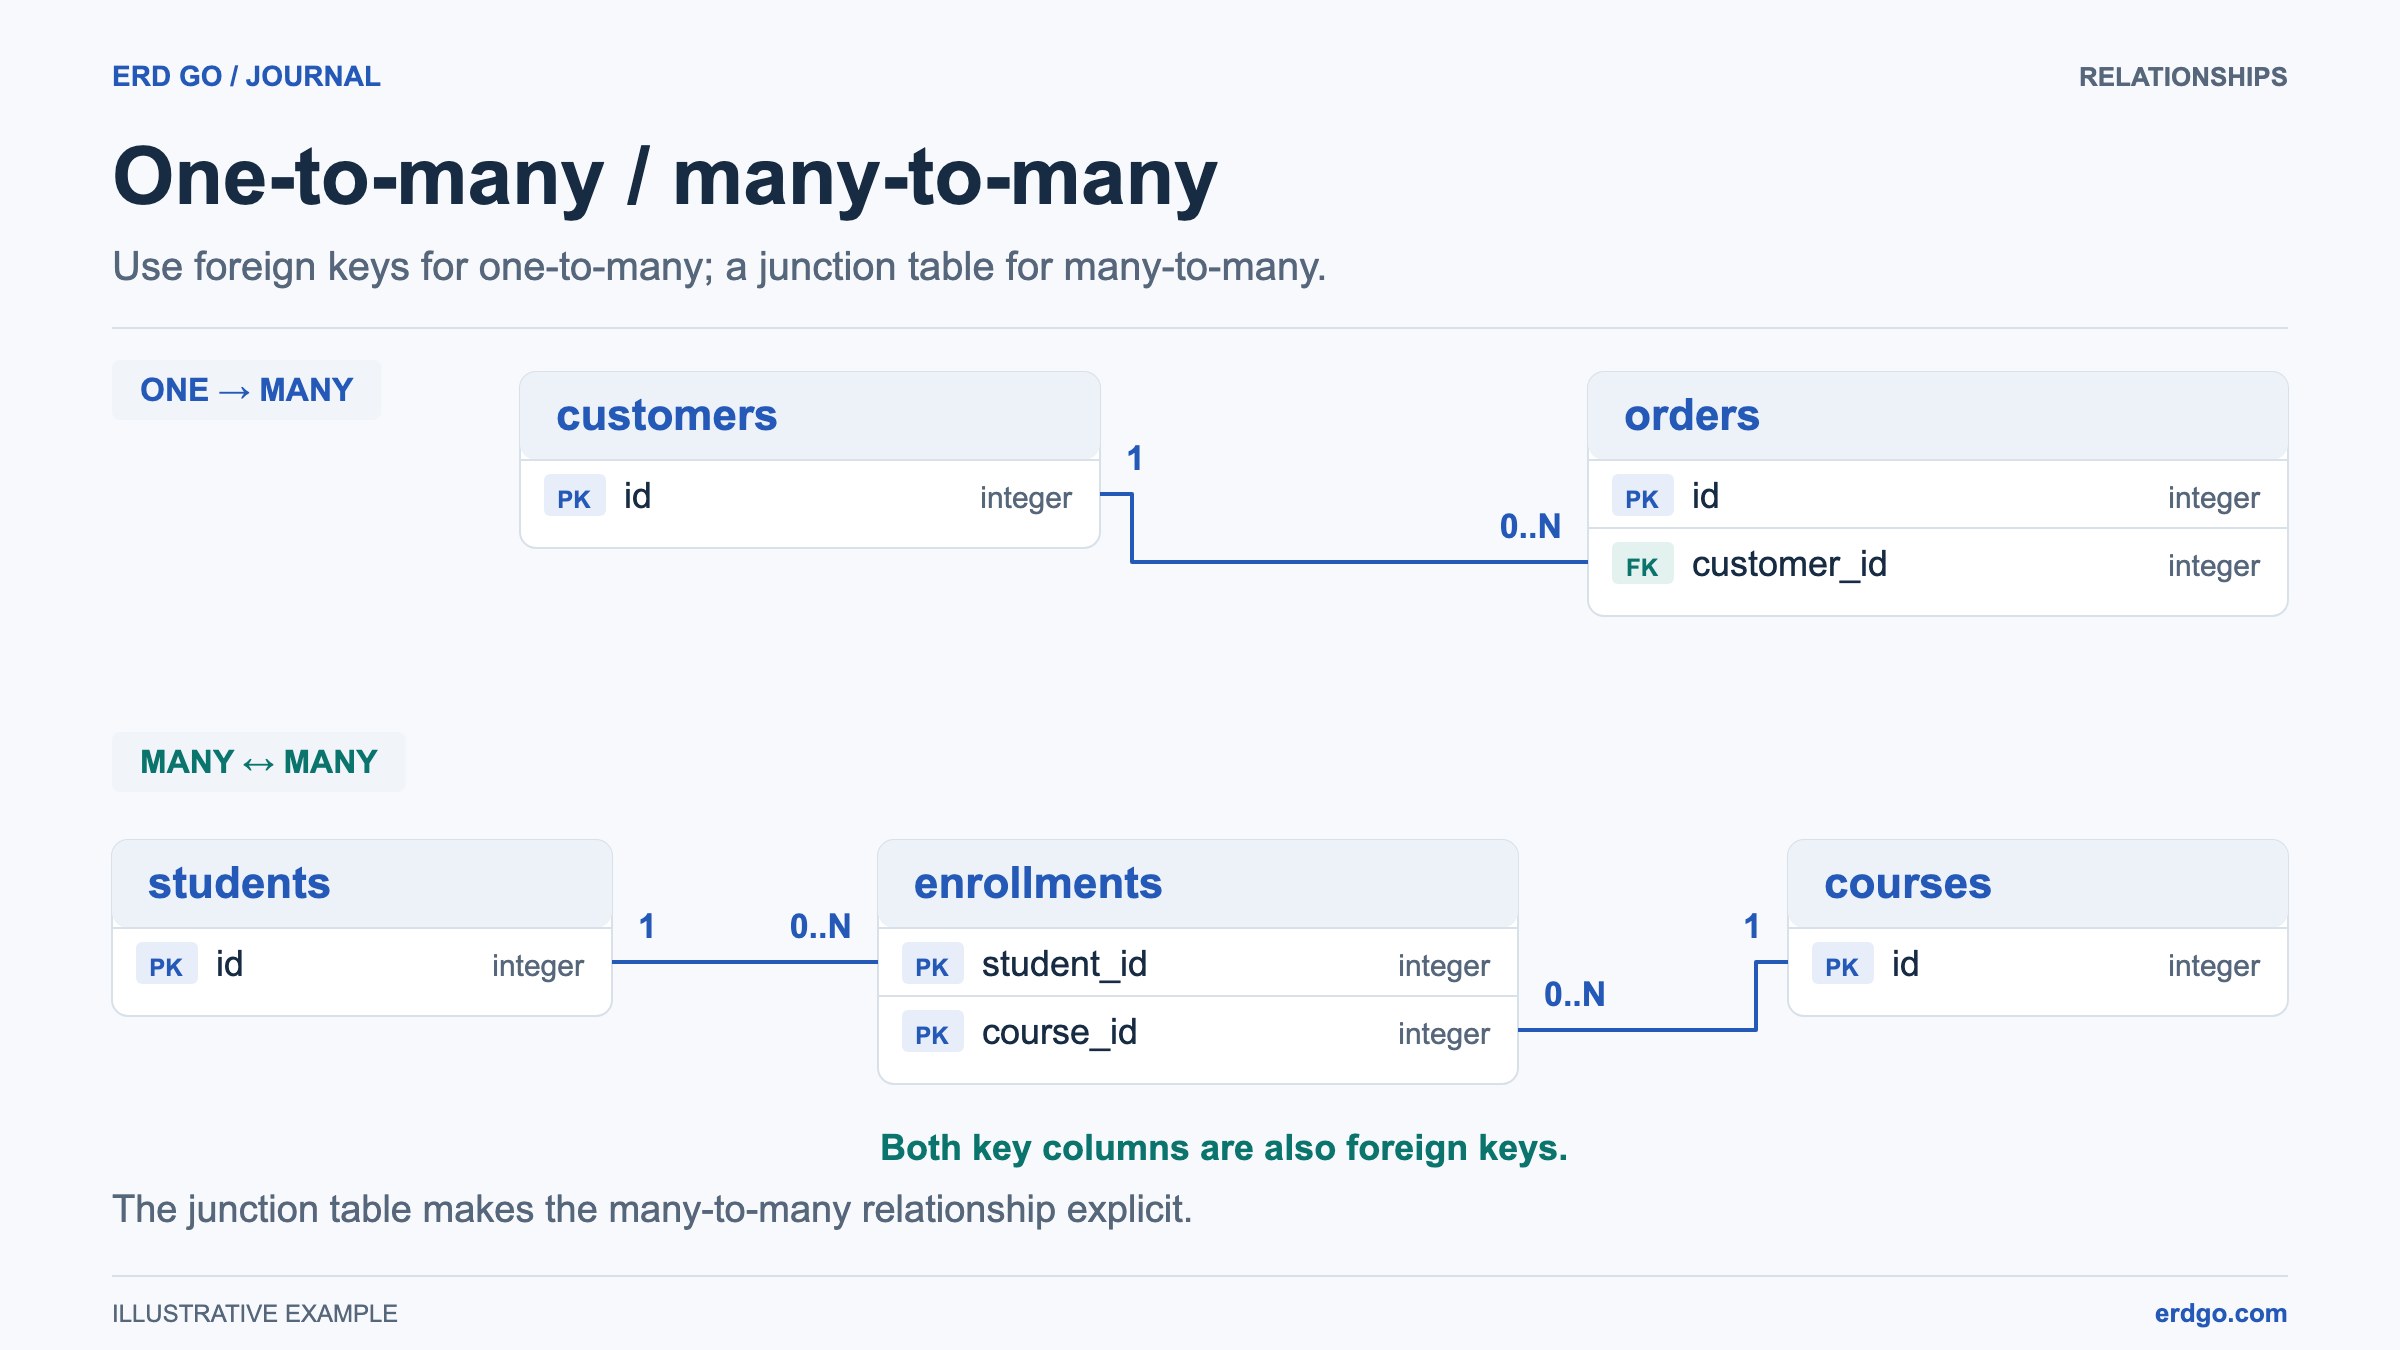
Gli esempi SQL utilizzano PostgreSQL a meno che non sia specificato un altro dialetto. Brevi frammenti presuppongono che le tabelle a cui fanno riferimento esistano già. Convalida il DDL nel tuo database di destinazione prima di applicarlo.
Che cos'è la normalizzazione del database?
Normalizzazione del database è il processo di organizzazione di un database relazionale per ridurre la ridondanza dei Dati e migliorare l'integrità dei Dati. Introdotta da Edgar F. Codd negli anni '70, la normalizzazione comporta la suddivisione di tabelle di grandi dimensioni in tabelle correlate più piccole e la definizione delle relazioni tra di esse.
L'obiettivo è rappresentare le dipendenze in modo coerente e ridurre le duplicazioni evitabili. Le istantanee storiche, come il prezzo di vendita, possono appartenere a una tabella diversa perché rappresentano fatti diversi.
Perché normalizzare?
- Elimina la ridondanza — Evita di memorizzare gli stessi dati in più posizioni.
- Prevenire anomalie di aggiornamento — Le modifiche ai dati devono avvenire solo in un unico posto.
- Prevenire anomalie di inserimento — Puoi aggiungere nuovi dati senza richiedere dati non correlati.
- Prevenire anomalie di eliminazione — L'eliminazione di un record non rimuove accidentalmente dati non correlati.
- Supporta query gestibili — Dipendenze chiare rendono più facile comprendere le query. Le prestazioni dipendono dai pattern di accesso, dagli indici e dalle join; la normalizzazione da sola non rende una query più veloce.
Prima forma normale (1NF)
Una tabella è in 1NF quando:
- Ogni colonna contiene solo valori atomici (indivisibili)
- Ogni colonna contiene valori di un singolo tipo
- Le righe sono distinguibili da una chiave candidata; dichiara una chiave primaria per imporre un identificatore scelto in SQL
- Non sono presenti gruppi ripetuti o array
Prima della 1NF (Violazione)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
Dopo la 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
Seconda Forma Normale (2NF)
Una tabella è in 2NF quando:
- È già in 1NF
- Ogni attributo non primo dipende da ciascun intero chiave candidata, senza dipendenza da solo una parte di una chiave
Una chiave candidata è un insieme minimale di attributi che identifica univocamente una riga. Gli attributi che compaiono in qualsiasi chiave candidata sono attributi primi. Le dipendenze parziali sono importanti quando una chiave candidata contiene più colonne; le chiavi candidate includono identificatori univoci alternativi, non solo la chiave primaria scelta. Se una colonna non chiave dipende solo da una parte della chiave, dovrebbe essere spostata in una tabella separata.
Prima della 2NF (Violazione)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
Dopo la 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Terza Forma Normale (3NF)
Una tabella è in 3NF quando:
- È già in 2NF
- Per ogni dipendenza funzionale non banale X → A, X è una superchiave o A appartiene a una chiave candidata. Negli esempi seguenti, questo rimuove le dipendenze transitive tra attributi non chiave.
Prima della 3NF (Violazione)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
Dopo la 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Un esempio normalizzato completo
Ecco uno schema di e-commerce che separa prodotti, clienti, indirizzi, ordini e righe d'ordine. Supponendo che ciascun identificatore elencato determini i restanti attributi, queste tabelle soddisfano le forme normali illustrate. I prezzi di vendita memorizzati sono fatti storici, non copie del prezzo corrente del prodotto.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Incolla questo in Editor di Erd Go per vedere l'ERD visuale con tutte le relazioni mappate automaticamente.
Quando denormalizzare
Sebbene la normalizzazione sia generalmente una buona pratica, ci sono casi in cui la denormalizzazione migliora le prestazioni:
- Carichi di lavoro con molte letture — Se la tua applicazione legge molto più di quanto scriva, memorizzare dati calcolati o duplicati può evitare JOIN onerose.
- Reporting e analisi — Le tabelle denormalizzate o le viste materializzate vengono spesso utilizzate per le dashboard.
- Memorizzazione nella cache dei dati frequenti — Memorizzazione dei valori aggregati a cui si accede frequentemente direttamente in una tabella.
- Pattern di accesso in stile NoSQL — Quando le tue query necessitano sempre di una combinazione specifica di dati.
La chiave sta nel normalizza prima, poi denormalizza intenzionalmente dove le prestazioni lo richiedono, documentando il motivo per cui è stato accettato il compromesso.