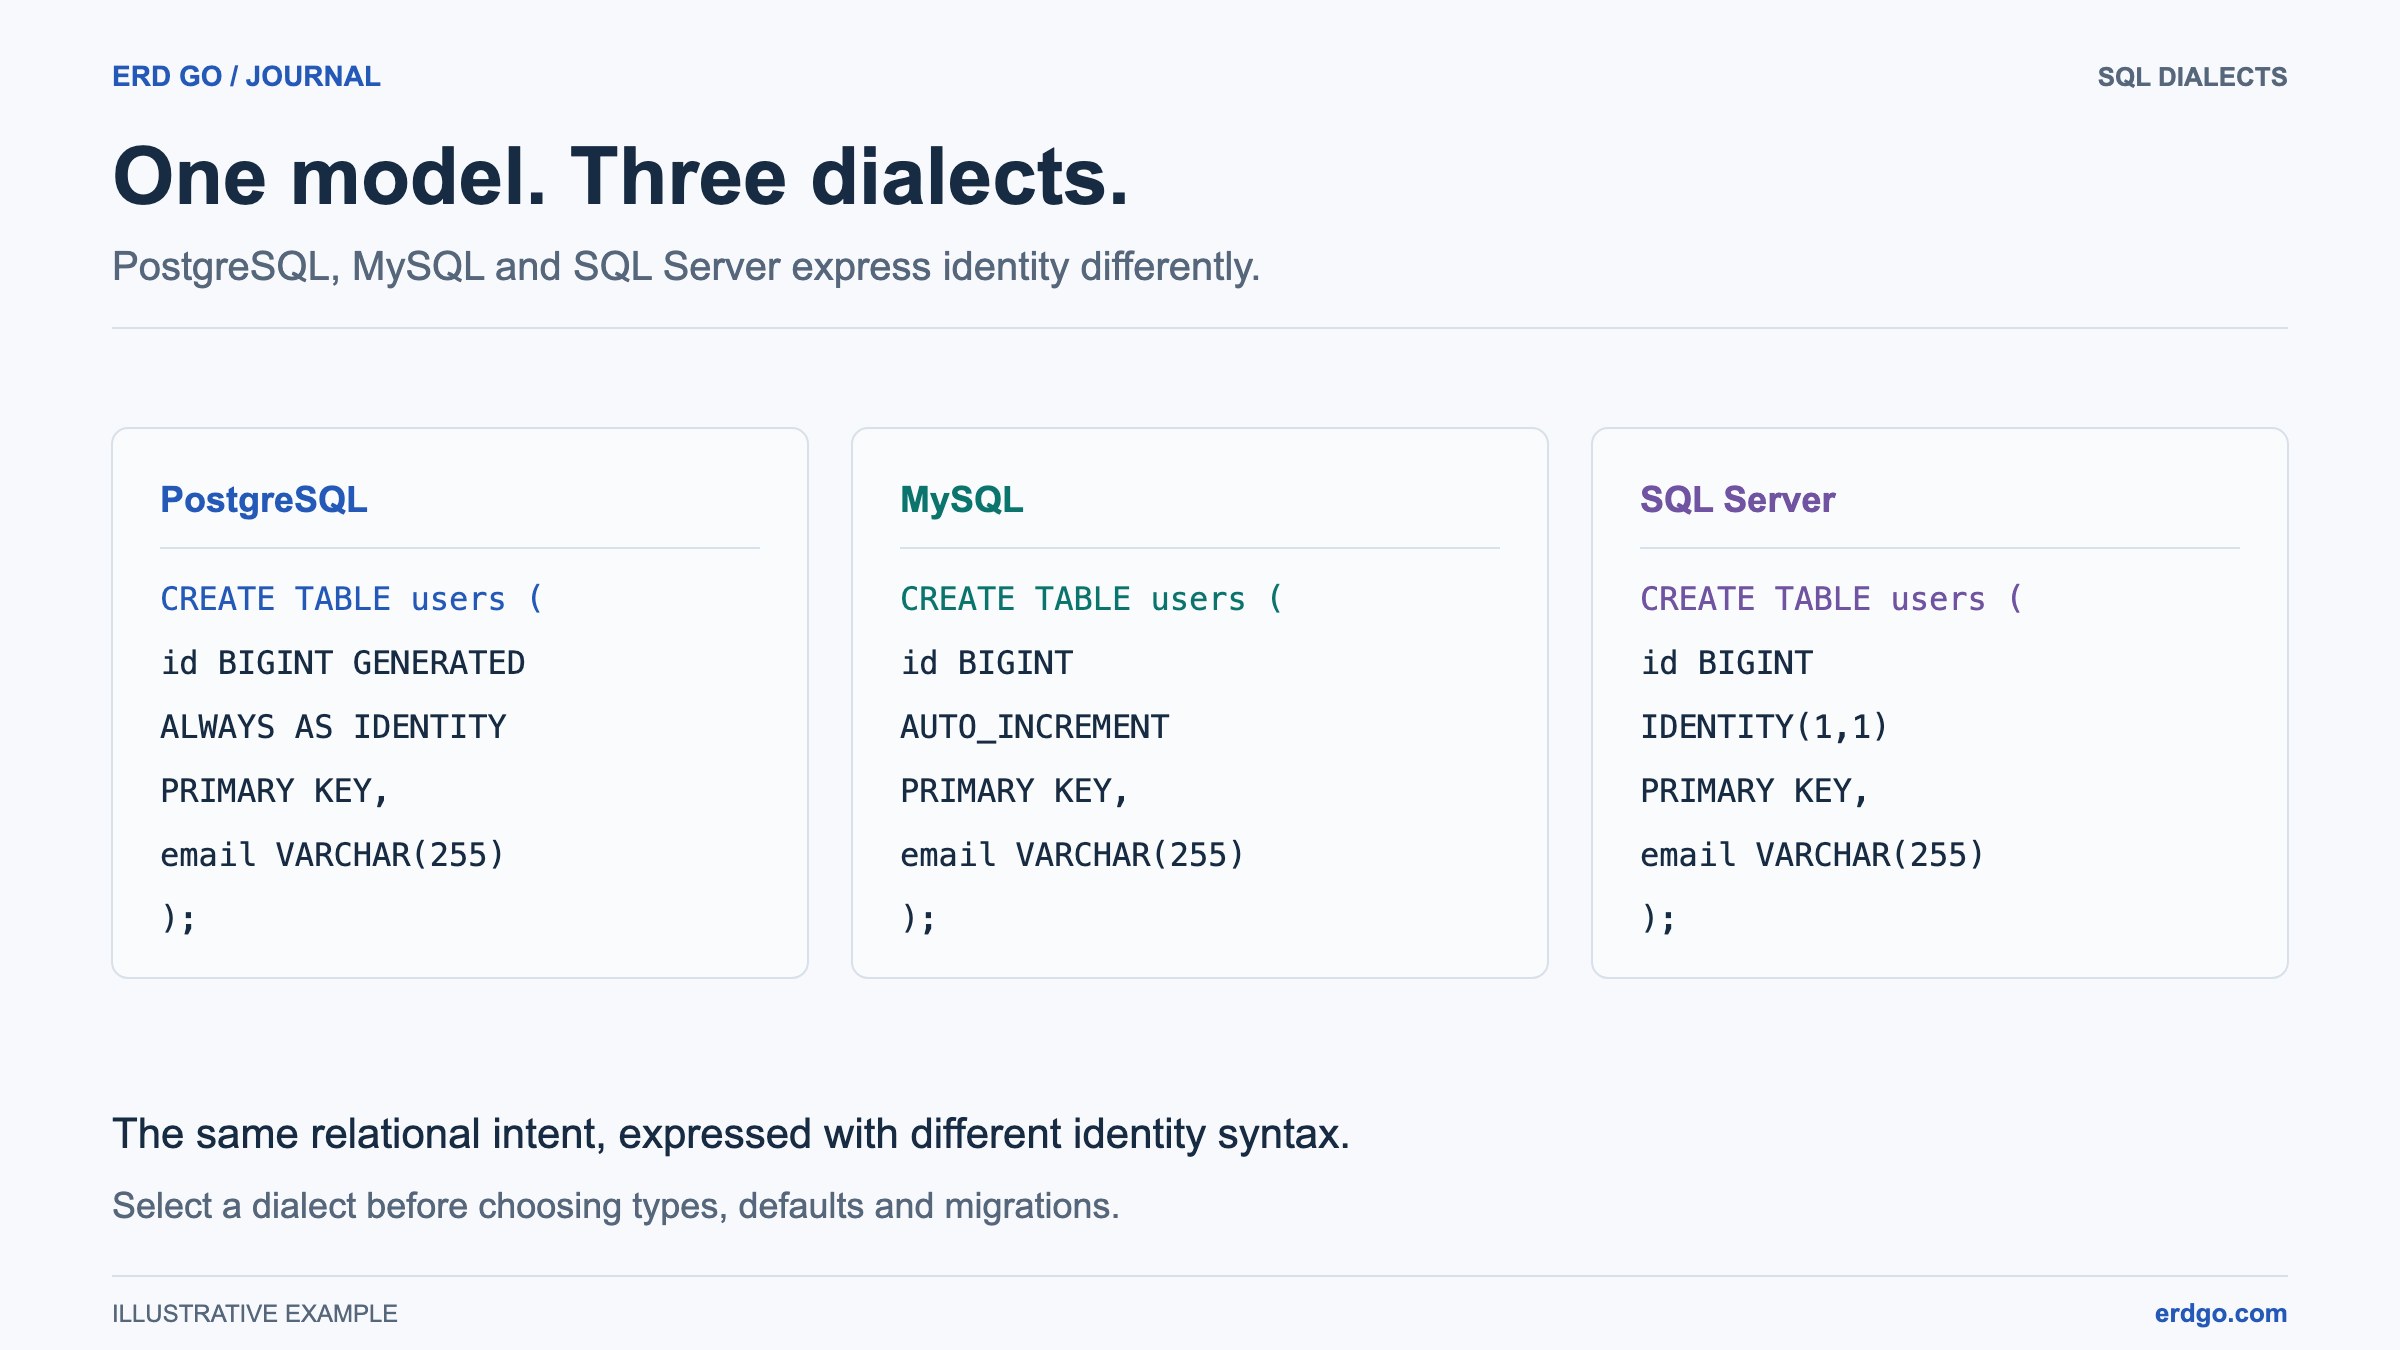
Gli esempi SQL utilizzano PostgreSQL a meno che non sia specificato un altro dialetto. Brevi frammenti presuppongono che le tabelle a cui fanno riferimento esistano già. Convalida il DDL nel tuo database di destinazione prima di applicarlo.
Cosa sono gli indici del database?
Un indice è una struttura dati gestita dal motore del database che fornisce un percorso di ricerca rapido per le righe in una tabella. Per i filtri selettivi, un indice può ridurre le righe o le pagine lette. L'ottimizzatore potrebbe comunque scegliere una scansione della tabella per tabelle piccole o query che restituiscono molte righe. Misura il piano e le tempistiche invece di presupporre un incremento di velocità fisso.
Come funzionano gli indici B-Tree
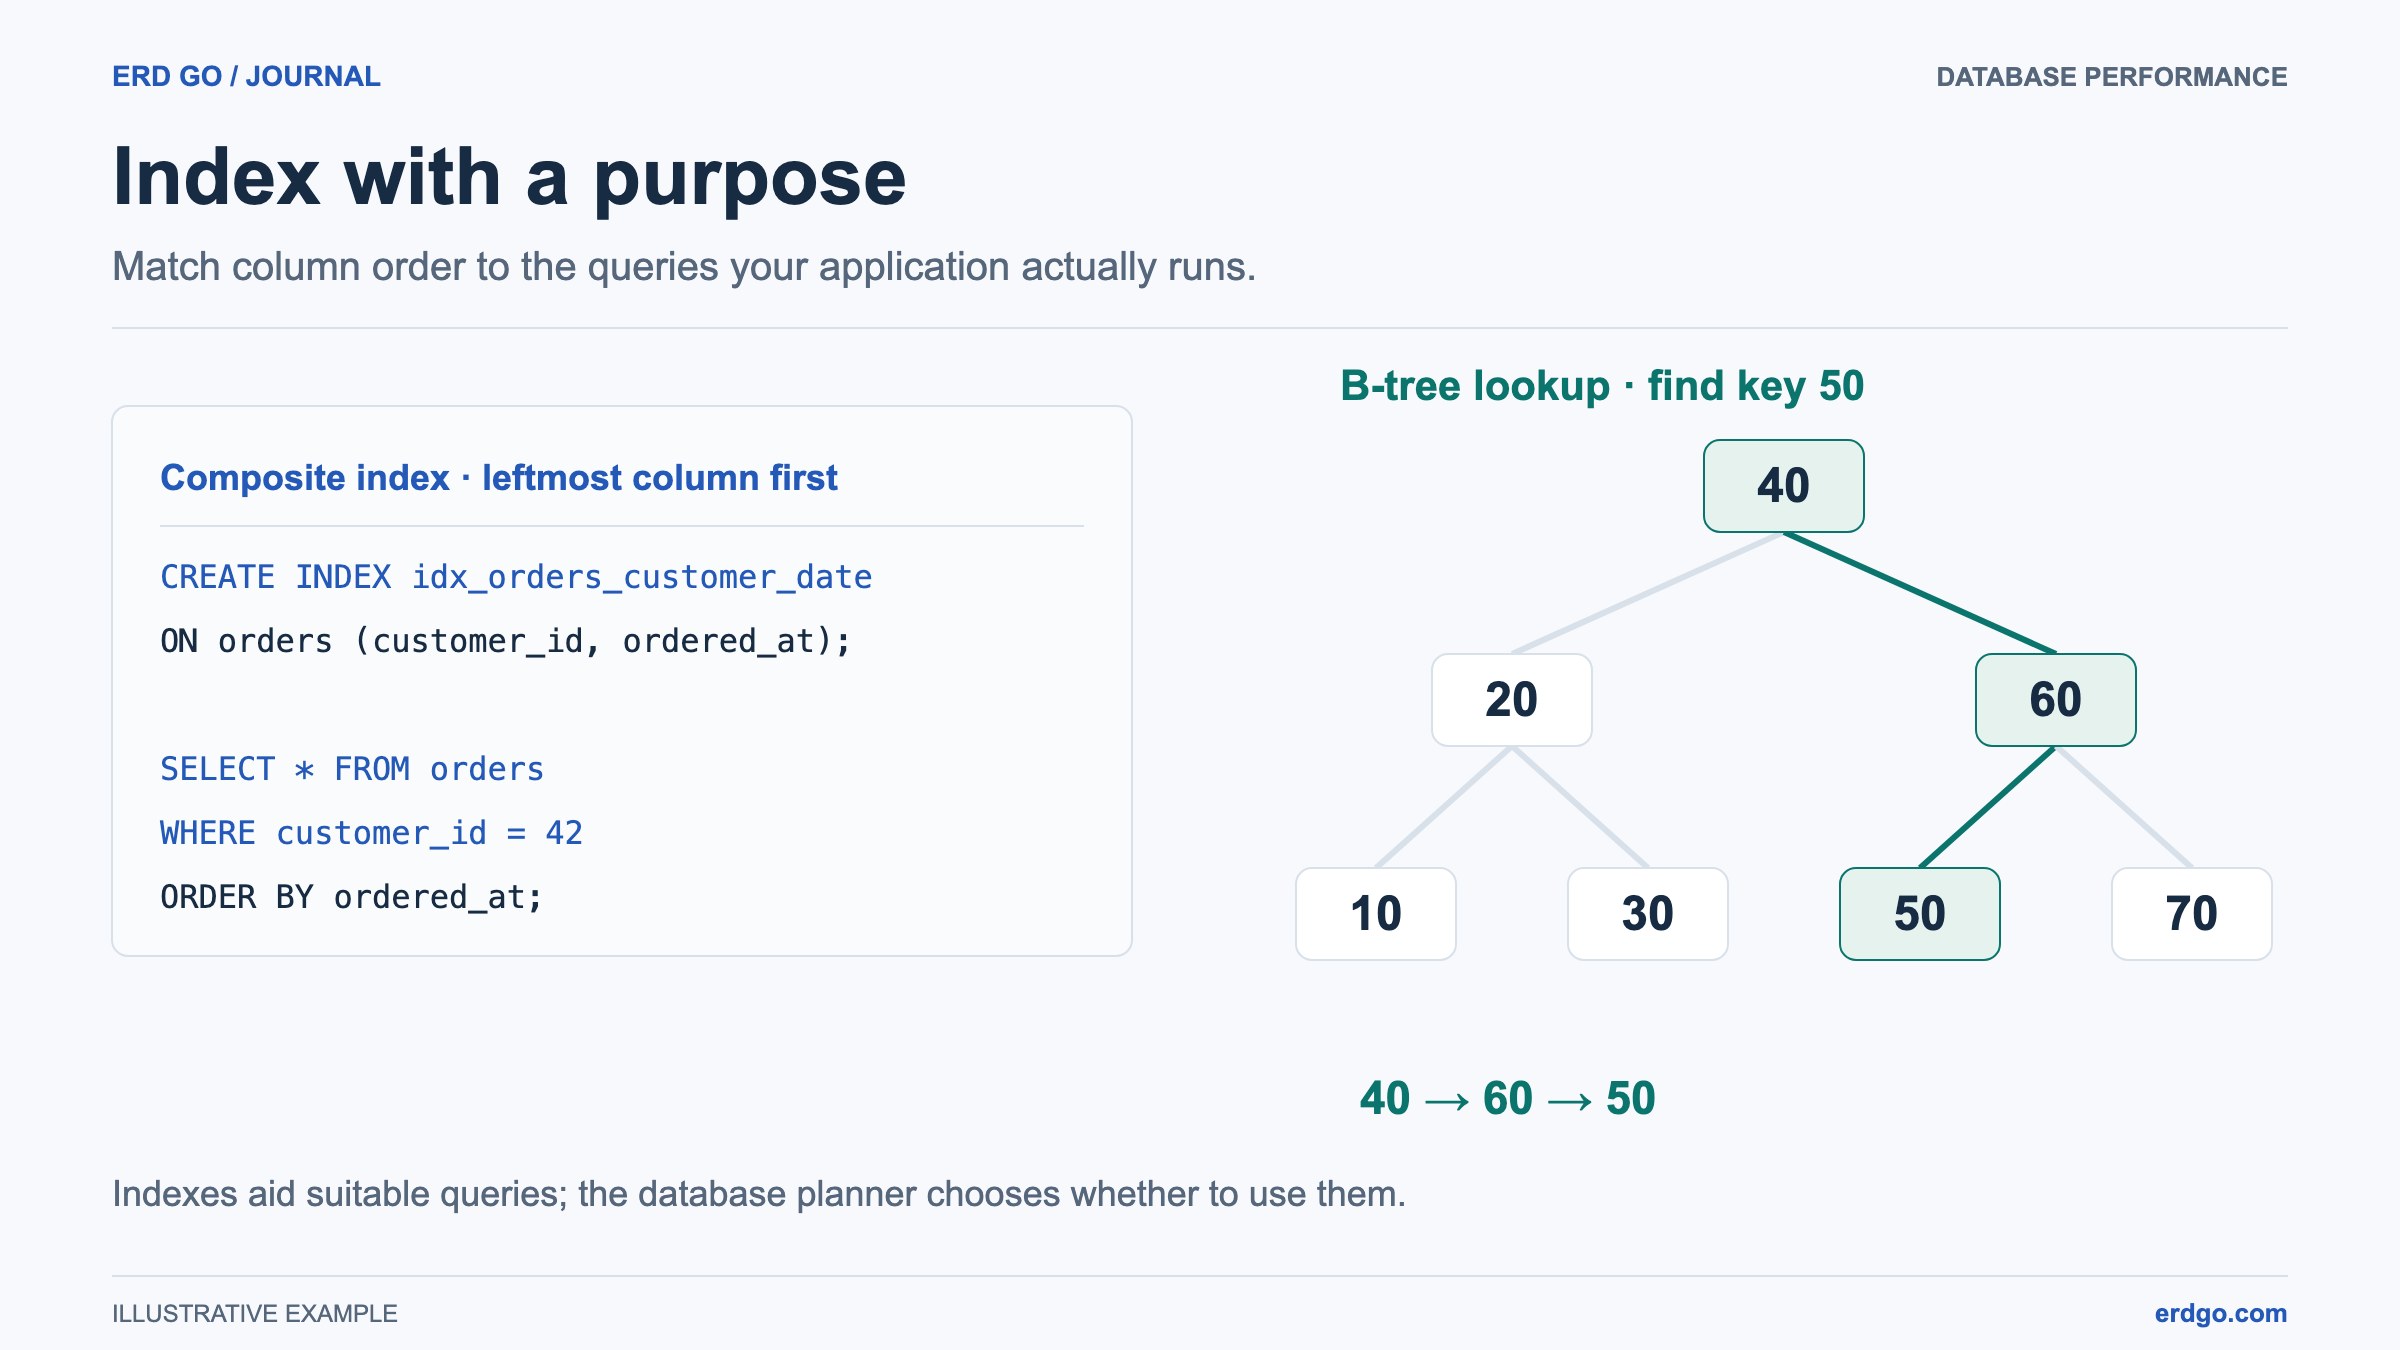
Il tipo di indice più comune in PostgreSQL, MySQL, SQL Server e SQLite è B-tree (albero bilanciato). Immaginalo come una rubrica telefonica: invece di leggere ogni nome da A a Z, apri nella sezione approssimativa, restringi alla pagina giusta e arrivi alla voce. Un albero B funziona in modo simile:
- L'albero è organizzato in nodi. Ogni nodo interno contiene chiavi ordinate e puntatori ai nodi figli.
- Una ricerca inizia presso il radice, confronta il valore di ricerca con le chiavi del nodo e segue il puntatore corretto verso il basso attraverso branch nodi.
- Raggiunge un foglia contenente le voci corrispondenti. A seconda del motore e dell'indice, le voci identificano le righe, contengono una chiave clusterizzata o conservano i dati stessi della riga.
- L'albero rimane bilanciato, ma la sua profondità e l'I/O dipendono dalla larghezza della chiave, dalla dimensione della pagina, dal numero di righe, dalla memorizzazione nella cache e dal fatto che la query recuperi o meno anche le pagine della tabella.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Quando dovresti usare gli indici?
Gli indici non sono gratuiti. Consumano spazio su disco e aggiungono overhead a ogni INSERT, UPDATE, e DELETE poiché il motore deve mantenere l'indice sincronizzato con i dati della tabella. Usali in modo strategico:
- Colonne in
WHEREclausole. Un indice adatto può aiutare un filtro selettivo frequente; il suo beneficio dipende dalla distribuzione dei Dati e dal piano scelto. - Colonne in
JOINcondizioni. Gli indici possono aiutare i join di chiavi esterne e gli aggiornamenti o le eliminazioni dei genitori; un join di grandi dimensioni può comunque favorire una scansione. - Colonne in
ORDER BYeGROUP BY. Un indice può fornire dati preordinati, eliminando un'operazione di ordinamento costosa. - Colonne ad alta cardinalità. Le colonne con molti valori distinti (come email o UUID) traggono maggiore vantaggio rispetto alle colonne con pochi valori distinti (come un booleano
is_activeflag). - Tabelle di grandi dimensioni. Una tabella con 100 righe raramente necessita di indici extra. Una tabella con 10 milioni di righe quasi certamente sì.
Come regola generale: inizia senza indici aggiuntivi, misura le prestazioni della query con EXPLAIN, quindi aggiungi gli indici dove i dati ti dicono di farlo.
Tipi di indici
Indice a colonna singola
La forma più semplice. Crea un B-tree su una singola colonna. Ideale per le query che filtrano o ordinano solo su quella colonna.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Indice composito (multicolonna)
Un indice su due o più colonne. Filtri di uguaglianza sulle colonne iniziali e un intervallo su quella successiva formano spesso un percorso di accesso B-tree efficiente. Altre condizioni possono comunque utilizzare una scansione o una skip scan; il supporto e il costo variano a seconda del motore e della versione.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Scegli l'ordine delle colonne in base ai filtri di uguaglianza, alle condizioni di intervallo, all'ordinamento e alle esigenze di copertura. "Il più selettivo prima" non è una regola universale. PostgreSQL 18 può utilizzare scansioni di salto B-tree per filtri non iniziali idonei.
Indice unico
Applica un vincolo di unicità fornendo al contempo prestazioni di ricerca basate su indice. La maggior parte dei database crea automaticamente un indice univoco quando definisci un UNIQUE vincolo o PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Indice parziale (filtrato)
Indica solo le righe che soddisfano una WHERE condizione. Questo mantiene l'indice di piccole dimensioni e mirato.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Un indice parziale o filtrato può aiutare un sottoinsieme piccolo e frequentemente interrogato. Il predicato della query deve implicare il filtro. La sintassi del filtro di SQL Server è più restrittiva rispetto a quella di PostgreSQL; non copiare predicati arbitrari tra di essi.
Altri tipi di indice
| Tipo di indice | Ideale per | Supporto database |
|---|---|---|
| Hash | Ricerche di uguaglianza esatta (=) | PostgreSQL, MySQL (motore Memory) |
| GIN | Ricerca full-text, JSONB, array | PostgreSQL |
| GiST | Tipi di dati geometrici e di intervallo | PostgreSQL |
| BRIN | Tabelle molto grandi con Dati ordinati naturalmente | PostgreSQL |
| Full-Text | Ricerca testuale con classificazione di rilevanza | MySQL, SQL Server |
Errori comuni di indicizzazione
Anche gli sviluppatori esperti cadono in queste trappole. Evitale per mantenere alte le prestazioni del tuo database.
1. Indicizzazione eccessiva
Aggiungere un indice su ogni colonna "per sicurezza" spreca spazio su disco e rallenta le scritture. Ogni indice deve essere aggiornato ad ogni inserimento, aggiornamento e eliminazione. Una tabella con 15 indici avrà una velocità di scrittura significativamente inferiore rispetto a una con 3 indici ben scelti.
2. Indicizzazione di colonne a bassa cardinalità
Indicizzazione di un booleano is_active colonna che contiene solo TRUE e FALSE può essere utile quando i valori sono fortemente sbilanciati o l'indice copre una query ristretta. La cardinalità da sola non determina se un indice sia d'aiuto. Se devi filtrare su tali colonne, combinale in un indice composito con una colonna a cardinalità più elevata o usa un indice parziale.
3. Ignorare i pattern di query
Un indice è utile solo se le tue query effettive possono sfruttarlo. Esamina sempre le query lente nella tua applicazione primo, quindi progetta indici che mirano a quei specifici pattern di accesso.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Dimenticanza di indicizzare le chiavi esterne
In PostgreSQL, le colonne chiave straniera sono non indicizzati automaticamente (a differenza di InnoDB di MySQL, che crea di default un indice sulle chiavi esterne). Un indice può aiutare join selettive e controlli referenziali, ma l'ottimizzatore potrebbe scegliere una scansione o un hash join. Verifica la presenza di un indice esistente le cui colonne principali coprano già la chiave esterna prima di aggiungerne un altro.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Mancata revisione degli indici inutilizzati
Con il tempo, il codice dell'applicazione cambia e i vecchi indici potrebbero non servire più alcuna query. Gli indici inutilizzati consumano comunque spazio di archiviazione e rallentano le scritture senza alcun vantaggio in lettura.
Monitoraggio dell'utilizzo degli indici
I database moderni forniscono viste di sistema che segnalano la frequenza di utilizzo di ciascun indice. La revisione regolare di queste aiuta a eliminare gli indici inutilizzati e a individuare quelli mancanti.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Considera zero letture come un candidato alla revisione, non come l'autorizzazione a eliminare un indice. Verifica quando i contatori sono stati azzerati, se lo strumento di misurazione è abilitato e se query stagionali, vincoli o controlli delle chiavi esterne ne hanno bisogno. Testa una proposta di rimozione con un carico di lavoro rappresentativo.
Indici nella progettazione dello schema e negli ERD
Sebbene gli ERD si concentrino principalmente su tabelle, colonne e relazioni, gli indici sono una parte importante della progettazione complessiva dello schema. Quando pianifichi il tuo database, considera gli indici insieme alle definizioni delle tabelle:
- A chiave primaria normalmente ha un percorso di accesso gestito dal motore. SQLite INTEGER PRIMARY KEY utilizza rowid anziché un indice univoco separato; controlla il motore prima di aggiungere un indice duplicato.
- Rivedi i percorsi di accesso per chiavi esterne. PostgreSQL non crea automaticamente indici sul lato figlio, ma un indice composto esistente potrebbe già coprire la relazione.
- Colonne con Vincoli UNIQUE ricevono un indice univoco automatico.
- Gli indici aggiuntivi per le colonne interrogate di frequente dovrebbero essere documentati insieme al DDL dello schema in modo da non essere dimenticati durante il rilascio.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualizza il tuo schema completo (tabelle, relazioni e le colonne che pianifichi di indicizzare) incollando il tuo DDL nel Editor di Erd Go. Vedere la struttura visivamente rivela spesso colonne che necessitano di indicizzazione (come chiavi esterne unite frequentemente) che potresti trascurare leggendo SQL grezzo.