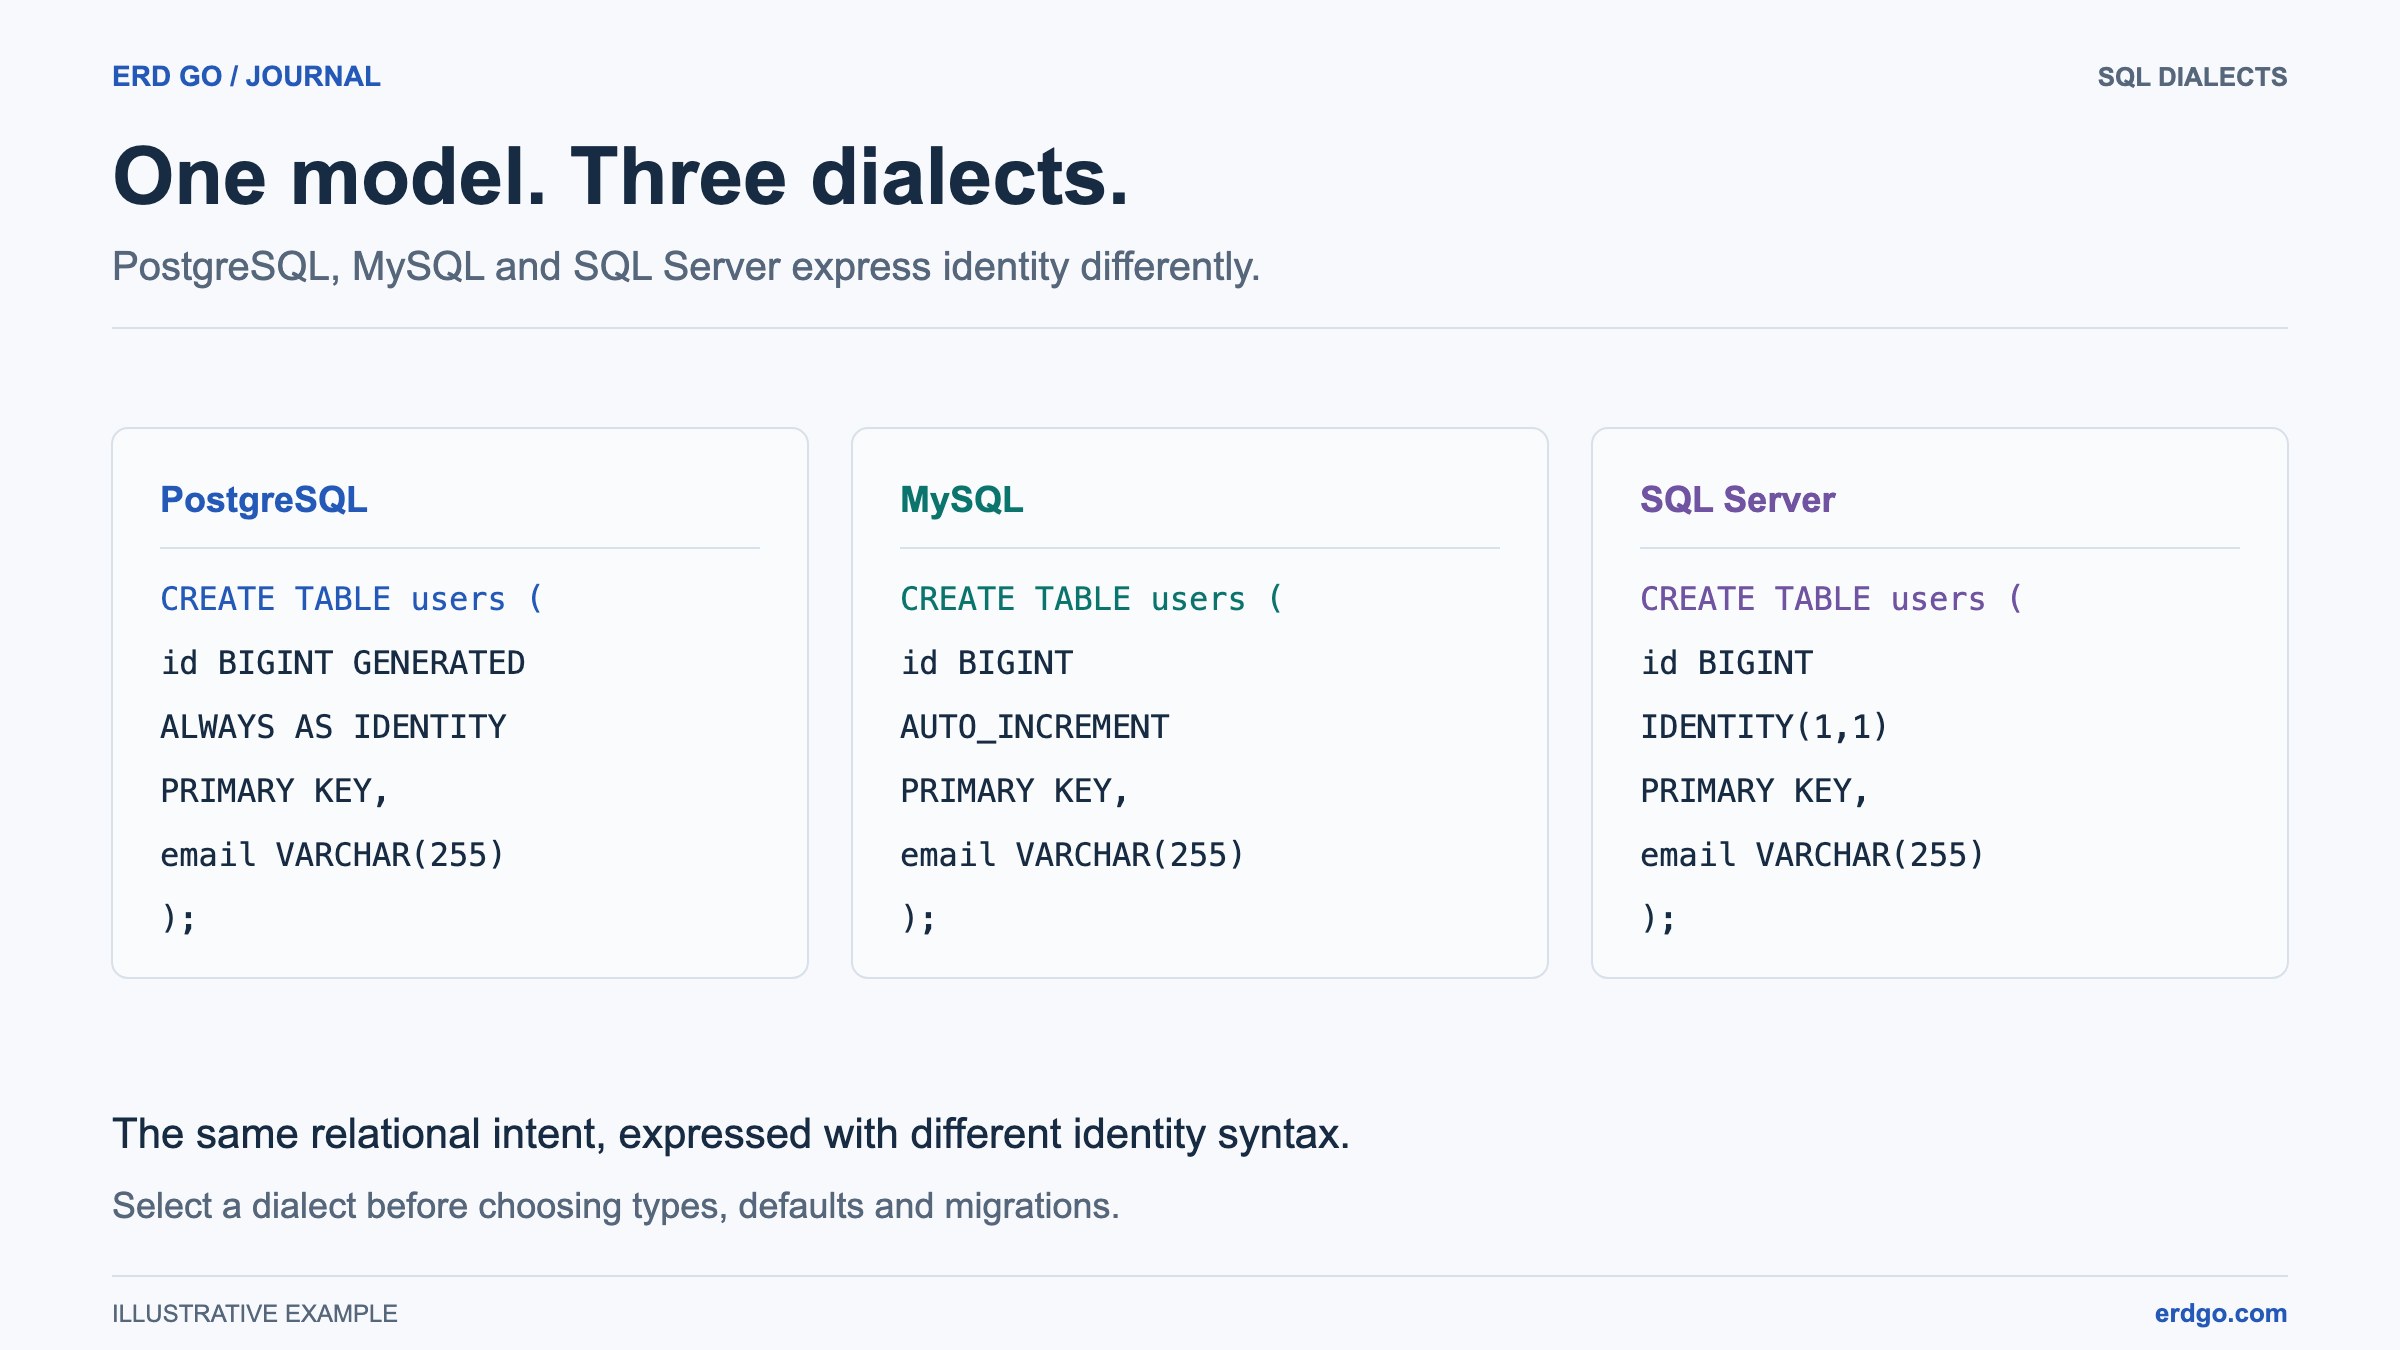
Contoh SQL menggunakan PostgreSQL kecuali dialek lain disebutkan. Cuplikan singkat mengasumsikan tabel yang direferensikan sudah ada. Validasi DDL di basis data target Anda sebelum menerapkannya.
Apa itu Indeks Basis Data?
Sebuah indeks adalah struktur data yang dipelihara oleh mesin database yang menyediakan jalur pencarian cepat ke baris dalam tabel. Untuk filter selektif, indeks dapat mengurangi baris atau halaman yang dibaca. Pengoptimal mungkin tetap memilih pemindaian tabel untuk tabel kecil atau kueri yang mengembalikan banyak baris. Ukur rencana dan waktu alih-alih berasumsi adanya peningkatan kecepatan tetap.
Cara Kerja Indeks B-Tree
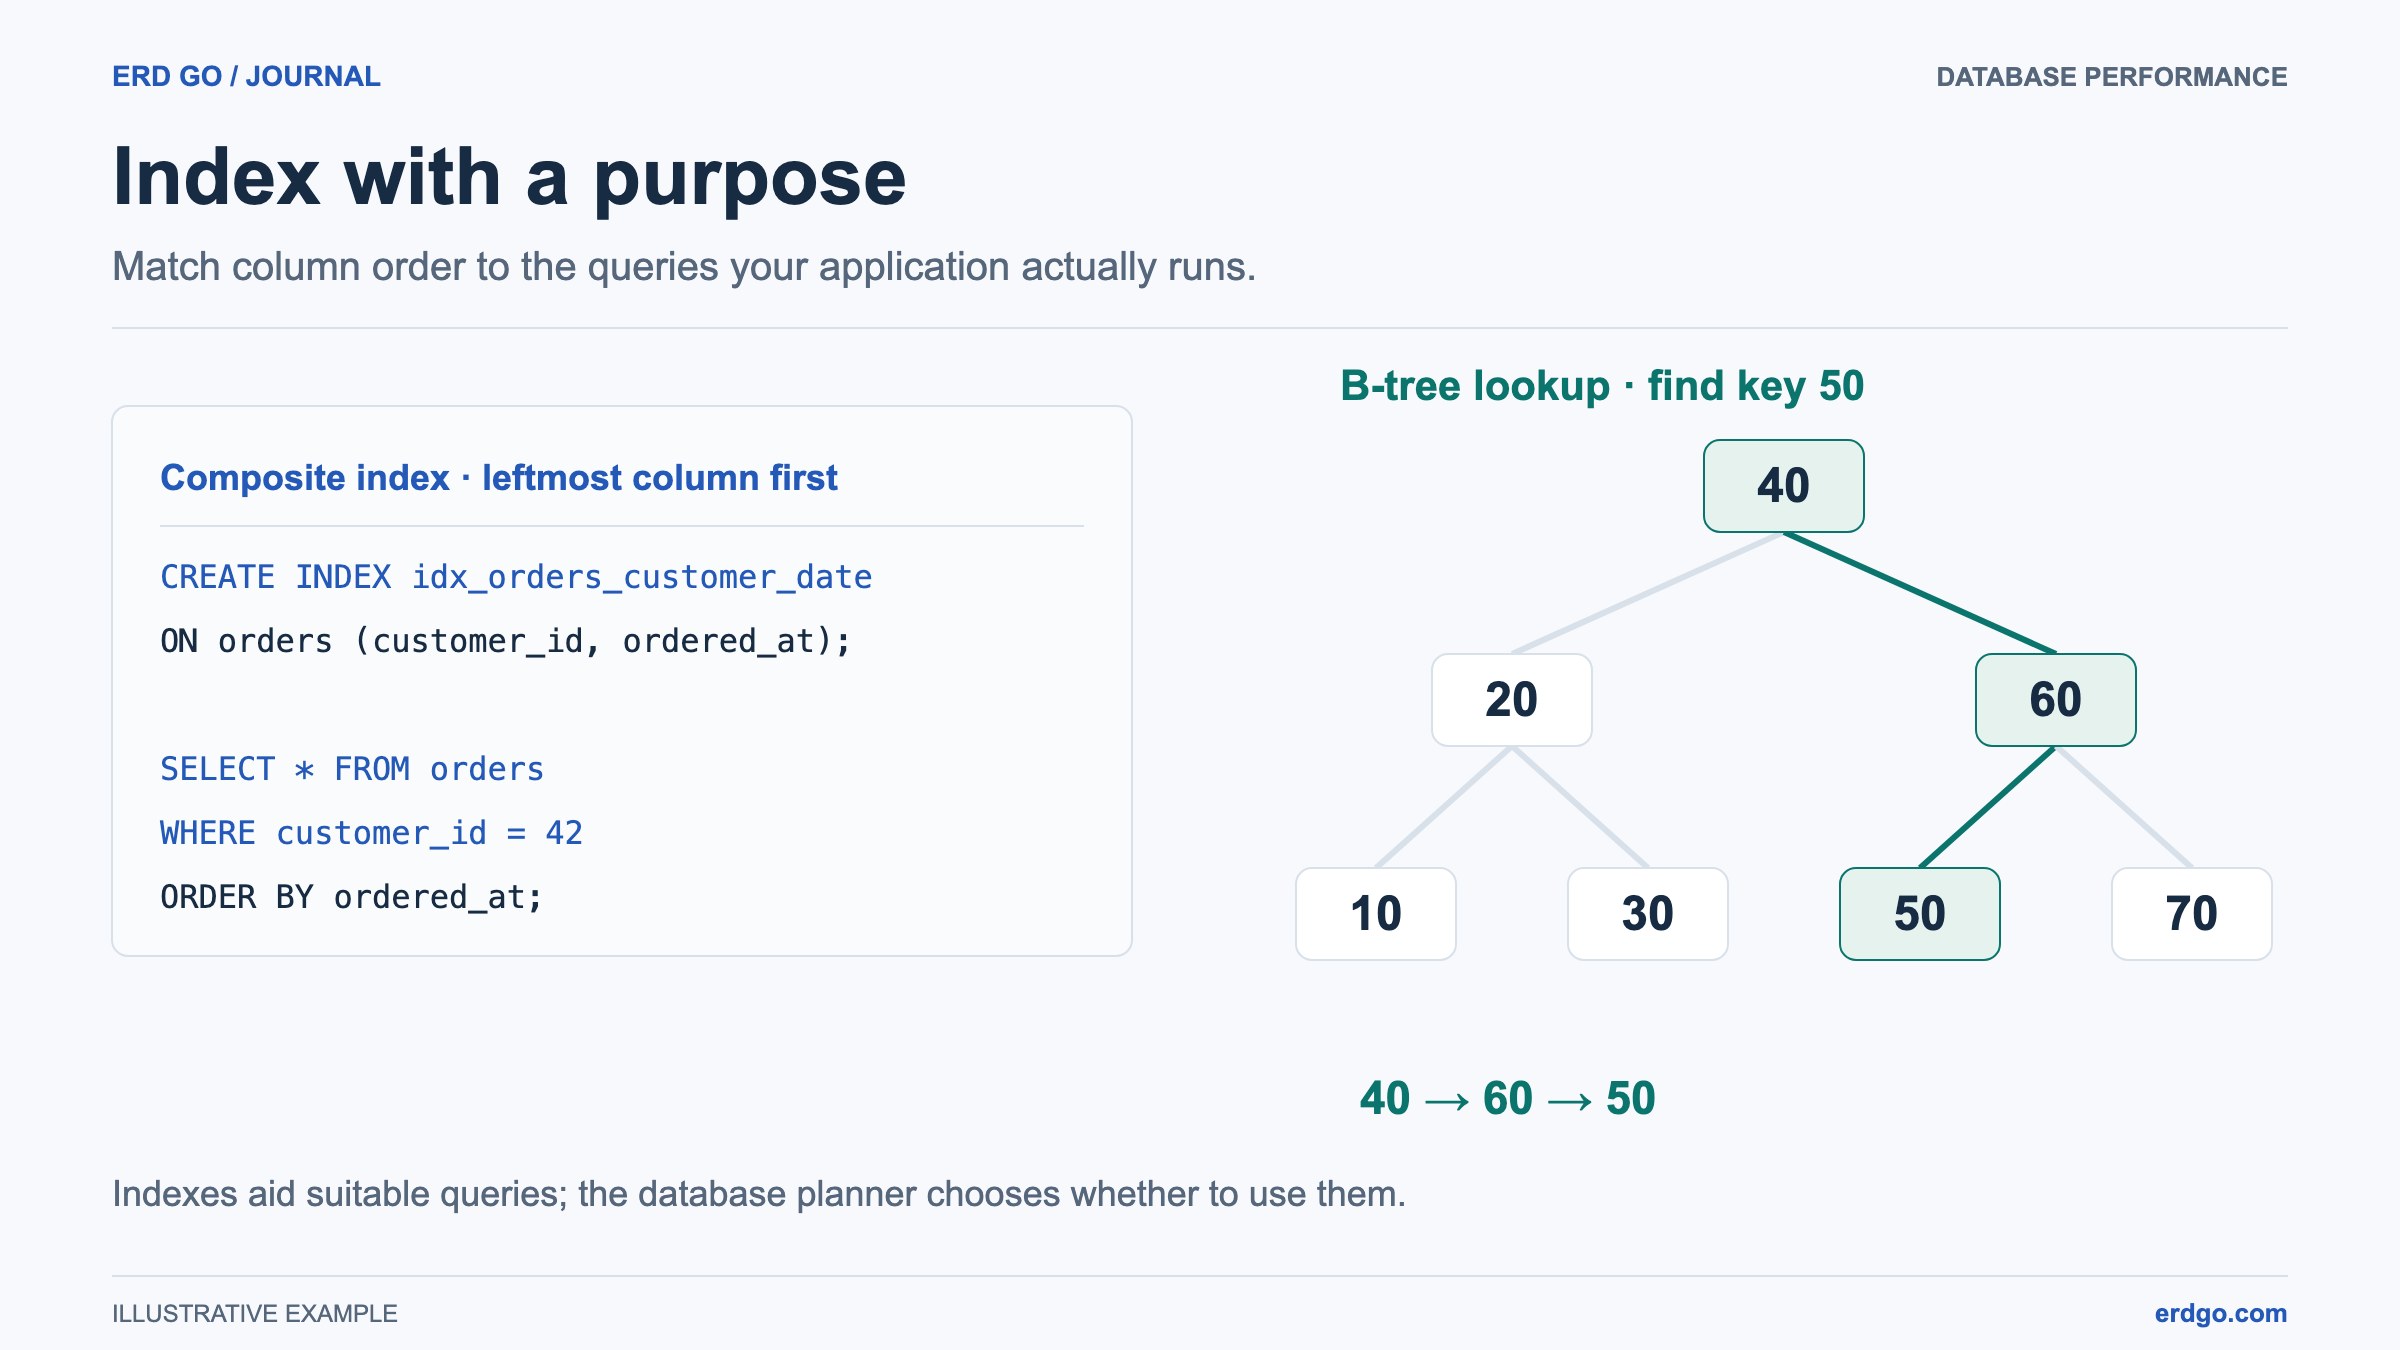
Tipe indeks yang paling umum di PostgreSQL, MySQL, SQL Server, dan SQLite adalah B-tree (pohon seimbang). Pikirkan seperti buku telepon: alih-alih membaca setiap nama dari A hingga Z, Anda membuka bagian perkiraan, mempersempit ke halaman yang tepat, dan mendarat di entri tersebut. B-tree bekerja serupa:
- Pohon diatur ke dalam nodes. Setiap simpul internal berisi kunci terurut dan pointer ke simpul anak.
- Pencarian dimulai dari root, membandingkan nilai pencarian dengan kunci node, dan mengikuti penunjuk yang benar ke bawah melalui cabang nodes.
- Ini mencapai leaf yang berisi entri yang cocok. Bergantung pada mesin dan indeks, entri mengidentifikasi baris, berisi kunci kluster, atau menampung data baris itu sendiri.
- Pohon tetap seimbang, tetapi kedalaman dan I/O-nya bergantung pada lebar kunci, ukuran halaman, jumlah baris, caching, dan apakah kueri juga mengambil halaman tabel.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Kapan Anda Harus Menggunakan Indeks?
Indeks tidak gratis. Indeks mengonsumsi ruang disk dan menambah overhead pada setiap INSERT, UPDATE, dan DELETE karena mesin harus menjaga indeks tetap sinkron dengan data tabel. Gunakan secara strategis:
- Kolom di
WHEREklausa. Indeks yang sesuai dapat membantu filter selektif yang sering; manfaatnya bergantung pada distribusi data dan rencana yang dipilih. - Kolom di
JOINkondisi. Indeks dapat membantu join kunci asing dan pembaruan atau penghapusan induk; join besar masih bisa lebih memilih pemindaian. - Kolom di
ORDER BYdanGROUP BY. Indeks dapat menyediakan data yang telah diurutkan sebelumnya, menghilangkan operasi pengurutan yang mahal. - Kolom dengan kardinalitas tinggi. Kolom dengan banyak nilai berbeda (seperti email atau UUID) lebih bermanfaat daripada kolom dengan sedikit nilai berbeda (seperti boolean
is_activebendera). - Tabel besar. Tabel dengan 100 baris jarang membutuhkan indeks tambahan. Tabel dengan 10 juta baris hampir pasti membutuhkannya.
Sebagai aturan umum: mulai tanpa indeks tambahan, ukur performa kueri dengan EXPLAIN, lalu tambahkan indeks di mana data memberi tahu Anda.
Jenis-jenis Indeks
Indeks Kolom Tunggal
Bentuk paling sederhana. Membuat B-tree pada satu kolom. Ideal untuk kueri yang memfilter atau mengurutkan pada kolom itu saja.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Indeks Komposit (Multi-Kolom)
Indeks pada dua kolom atau lebih. Filter kesetaraan pada kolom terdepan dan rentang pada kolom berikutnya sering kali membentuk jalur akses B-tree yang efisien. Kondisi lain mungkin tetap menggunakan pemindaian atau pemindaian lewati; dukungan dan biaya bervariasi menurut mesin dan versinya.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Pilih urutan kolom dari filter kesetaraan, kondisi rentang, pengurutan, dan kebutuhan cakupan. "Paling selektif terlebih dahulu" bukanlah aturan universal. PostgreSQL 18 dapat menggunakan pemindaian lewati B-tree untuk filter non-leading yang sesuai.
Indeks Unik
Menerapkan batasan keunikan sekaligus memberikan performa pencarian berbasis indeks. Sebagian besar basis data secara otomatis membuat indeks unik saat Anda mendefinisikan UNIQUE kendala atau PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Indeks Parsial (Terfilter)
Mengindeks hanya baris yang memenuhi WHERE kondisi. Ini menjaga indeks tetap kecil dan sangat ditargetkan.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Indeks parsial atau terfilter dapat membantu subset kecil yang sering dikueri. Predikat kueri harus menyiratkan filter. Sintaks filter SQL Server lebih terbatas daripada PostgreSQL; jangan menyalin predikat arbitrer di antara keduanya.
Tipe Indeks Lainnya
| Tipe Indeks | Terbaik Untuk | Dukungan Database |
|---|---|---|
| Hash | Pencarian kesamaan persis (=) | PostgreSQL, MySQL (mesin Memory) |
| GIN | Pencarian teks lengkap, JSONB, array | PostgreSQL |
| GiST | Tipe data geometris dan rentang | PostgreSQL |
| BRIN | Tabel sangat besar dengan data yang diurutkan secara alami | PostgreSQL |
| Teks Lengkap | Pencarian teks dengan peringkat relevansi | MySQL, SQL Server |
Kesalahan Pengindeksan Umum
Bahkan pengembang berpengalaman pun terjebak dalam jebakan ini. Hindari jebakan tersebut agar kinerja database Anda tetap baik.
1. Pengindeksan Berlebih
Menambahkan indeks pada setiap kolom "untuk berjaga-jaga" membuang ruang disk dan memperlambat penulisan. Setiap indeks harus diperbarui pada setiap operasi insert, update, and delete. Tabel dengan 15 indeks akan memiliki throughput penulisan yang jauh lebih lambat daripada tabel dengan 3 indeks yang dipilih dengan baik.
2. Mengindeks Kolom Kardinalitas Rendah
Mengindeks boolean is_active kolom yang hanya berisi TRUE dan FALSE dapat berguna ketika nilai sangat condong atau indeks mencakup kueri yang sempit. Kardinalitas saja tidak menentukan apakah suatu indeks membantu. Jika Anda harus memfilter pada kolom tersebut, gabungkan dalam indeks komposit dengan kolom kardinalitas yang lebih tinggi, atau gunakan indeks parsial.
3. Mengabaikan Pola Kueri
Indeks hanya berguna jika kueri aktual Anda dapat memanfaatkannya. Selalu periksa kueri lambat di aplikasi Anda pertama, lalu rancang indeks yang menargetkan pola akses khusus tersebut.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Lupa Mengindeks Kunci Asing
Dalam PostgreSQL, kolom kunci asing adalah not diindeks secara otomatis (tidak seperti InnoDB MySQL, yang membuat indeks pada kunci asing secara default). Indeks dapat membantu penggabungan selektif dan pemeriksaan referensial, tetapi pengoptimal dapat memilih pemindaian (scan) atau penggabungan hash (hash join). Periksa indeks yang sudah ada yang kolom utamanya telah mencakup kunci asing sebelum menambahkan yang lain.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Tidak Pernah Meninjau Indeks yang Tidak Digunakan
Seiring waktu, kode aplikasi berubah dan indeks lama mungkin tidak lagi melayani kueri apa pun. Indeks yang tidak digunakan tetap memakan penyimpanan dan memperlambat penulisan tanpa manfaat pembacaan.
Memantau Penggunaan Indeks
Basis data modern menyediakan tampilan sistem yang melaporkan seberapa sering setiap indeks digunakan. Meninjau hal ini secara berkala membantu Anda menghapus indeks yang tidak digunakan dan menemukan indeks yang hilang.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Perlakukan nol pembacaan sebagai kandidat peninjauan, bukan izin untuk menghapus indeks. Periksa kapan penghitung disetel ulang, apakah instrumentasi diaktifkan, dan apakah kueri musiman, batasan, atau pemeriksaan kunci asing membutuhkannya. Uji penghapusan yang diusulkan dengan beban kerja yang representatif.
Indeks dalam Desain Skema dan ERD
Meskipun ERD terutama berfokus pada tabel, kolom, dan hubungan, indeks adalah bagian penting dari desain skema keseluruhan. Saat merencanakan basis data Anda, pertimbangkan indeks bersamaan dengan definisi tabel Anda:
- A primary key biasanya memiliki jalur akses yang dikelola mesin database. SQLite INTEGER PRIMARY KEY menggunakan rowid, bukan indeks unik terpisah; periksa mesin database sebelum menambahkan indeks duplikat.
- Tinjau jalur akses untuk kunci asing. PostgreSQL tidak membuat indeks sisi anak secara otomatis, tetapi indeks komposit yang ada mungkin sudah mencakup relasi tersebut.
- Kolom dengan Batasan UNIQUE receive an automatic unique index.
- Indeks tambahan untuk kolom yang sering dikueri harus didokumentasikan bersama DDL skema Anda agar tidak terlupakan selama penerapan (deployment).
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualisasikan skema lengkap Anda—tabel, hubungan, dan kolom yang ingin Anda indeks—dengan menempelkan DDL Anda ke dalam Editor Erd Go. Melihat struktur secara visual sering kali mengungkapkan kolom yang memerlukan pengindeksan (seperti kunci asing yang sering digabungkan) yang mungkin Anda lewatkan saat membaca SQL mentah.