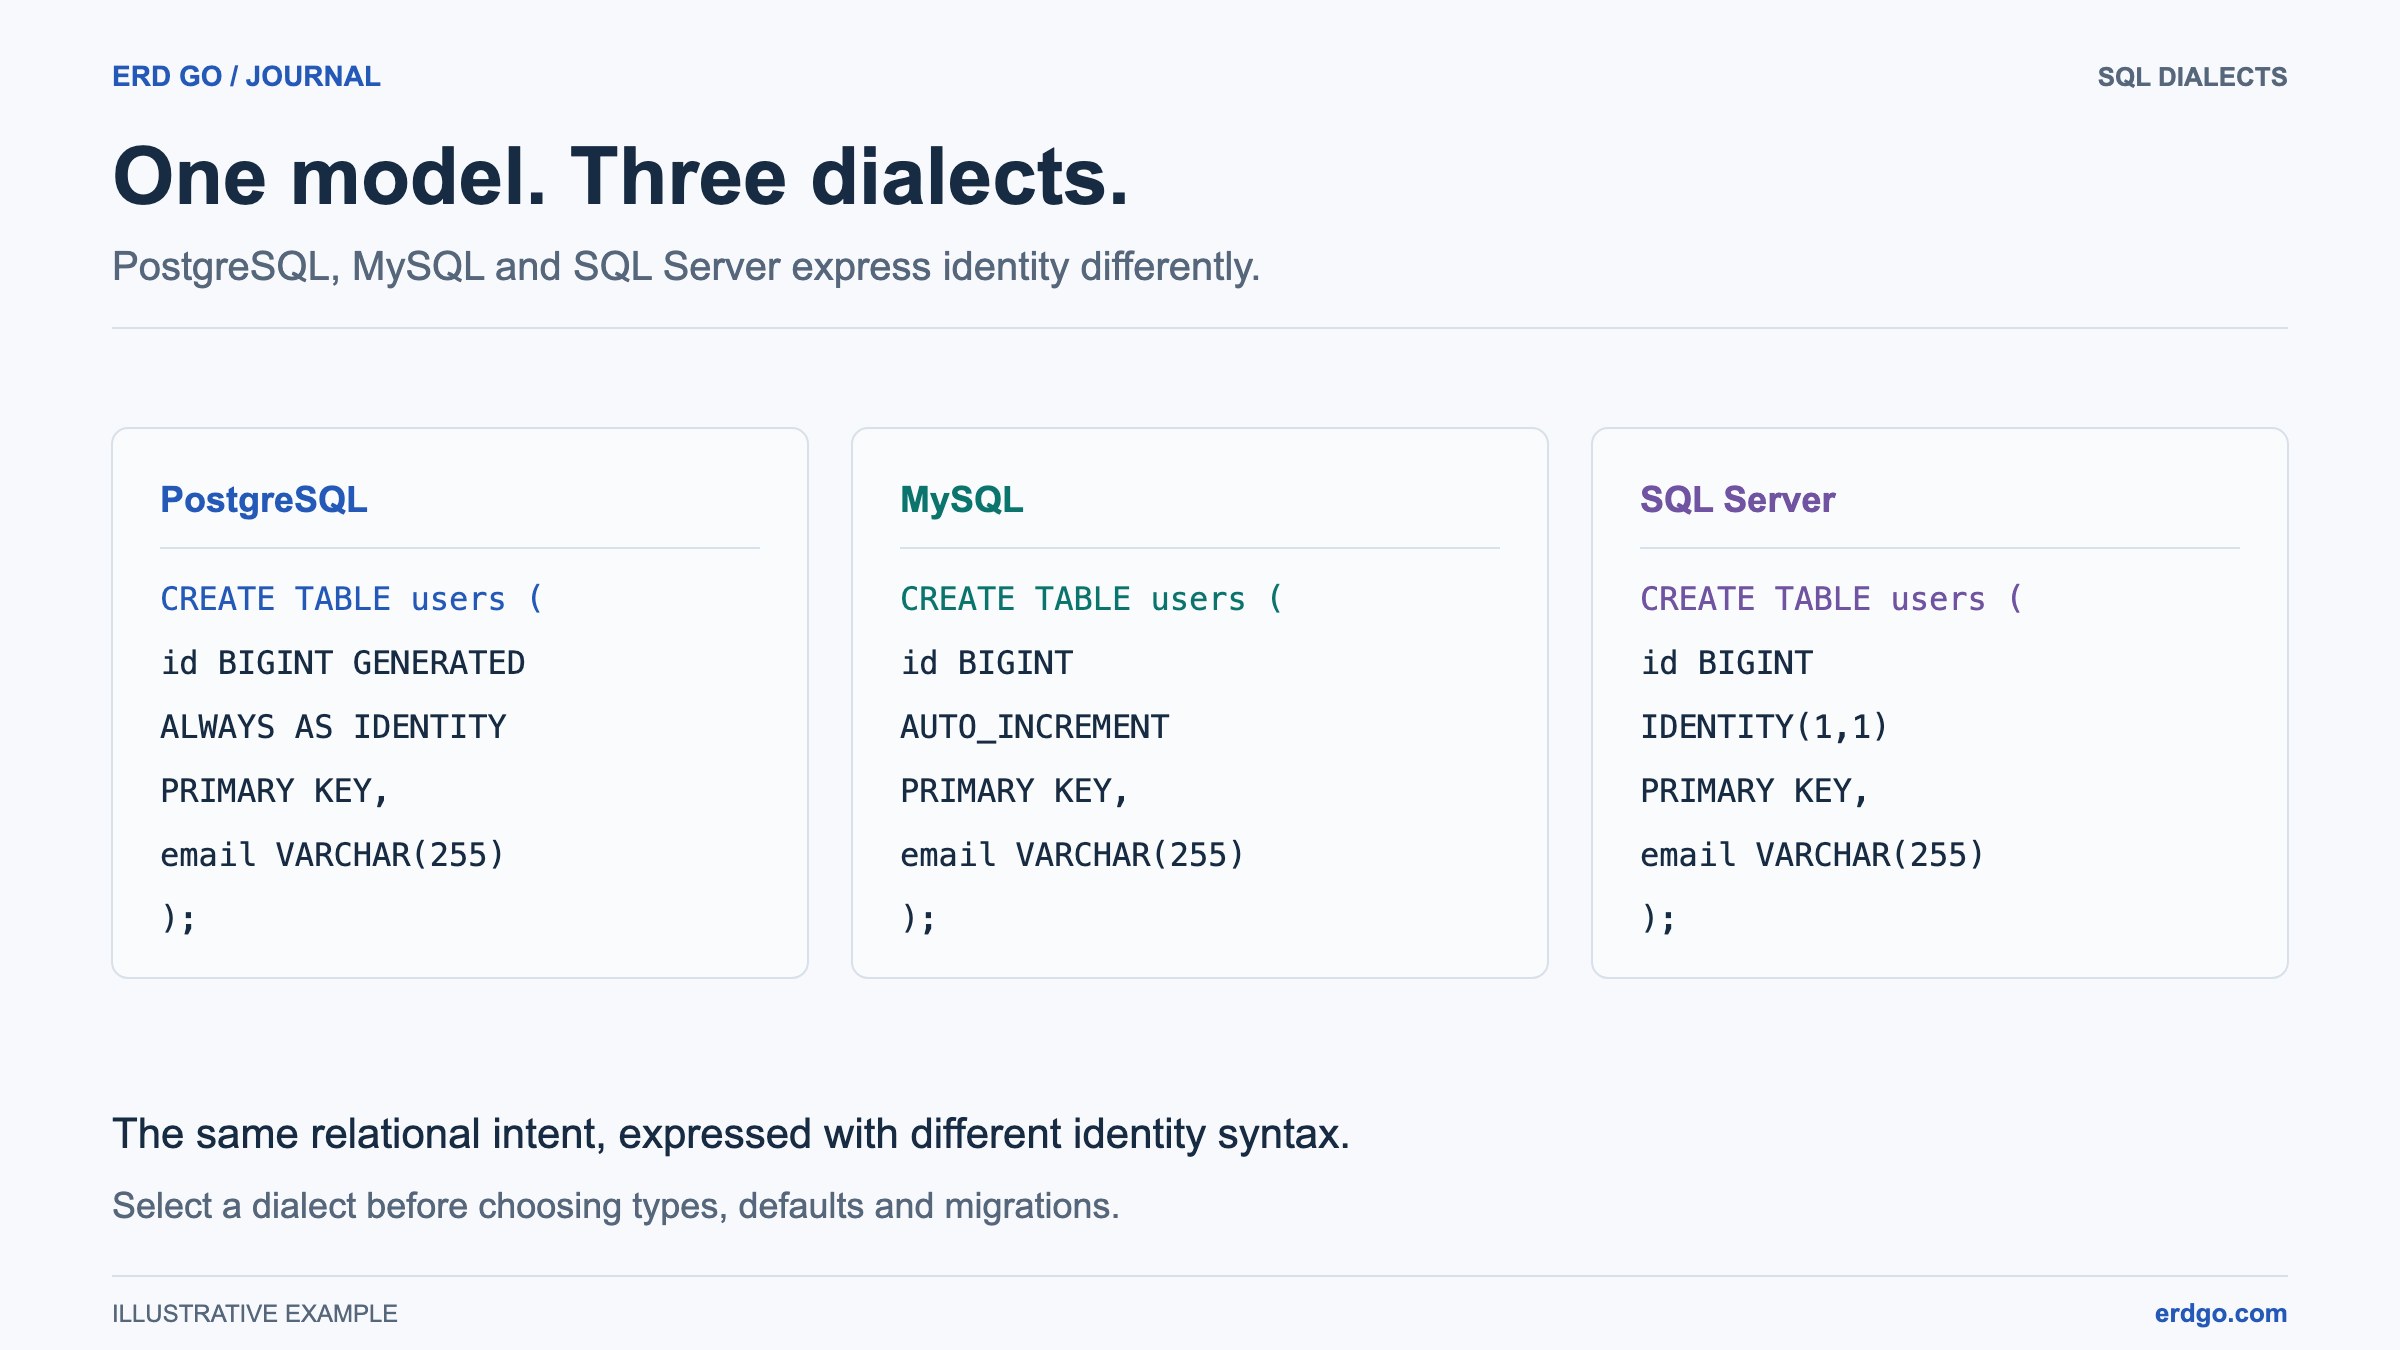
Les exemples SQL utilisent PostgreSQL à moins qu'un autre dialecte ne soit nommé. Les extraits courts supposent que leurs tables référencées existent déjà. Validez le DDL dans votre base de données cible avant de l'appliquer.
Que sont les index de base de données ?
Un index est une structure de données maintenue par le moteur de base de données qui fournit un chemin de recherche rapide vers les lignes d'une table. Pour les filtres sélectifs, un index peut réduire les lignes ou les pages lues. L'optimiseur peut toujours choisir un parcours de table pour les petites tables ou les requêtes retournant de nombreuses lignes. Mesurez le plan et le temps au lieu de supposer une accélération fixe.
Fonctionnement des index B-Tree
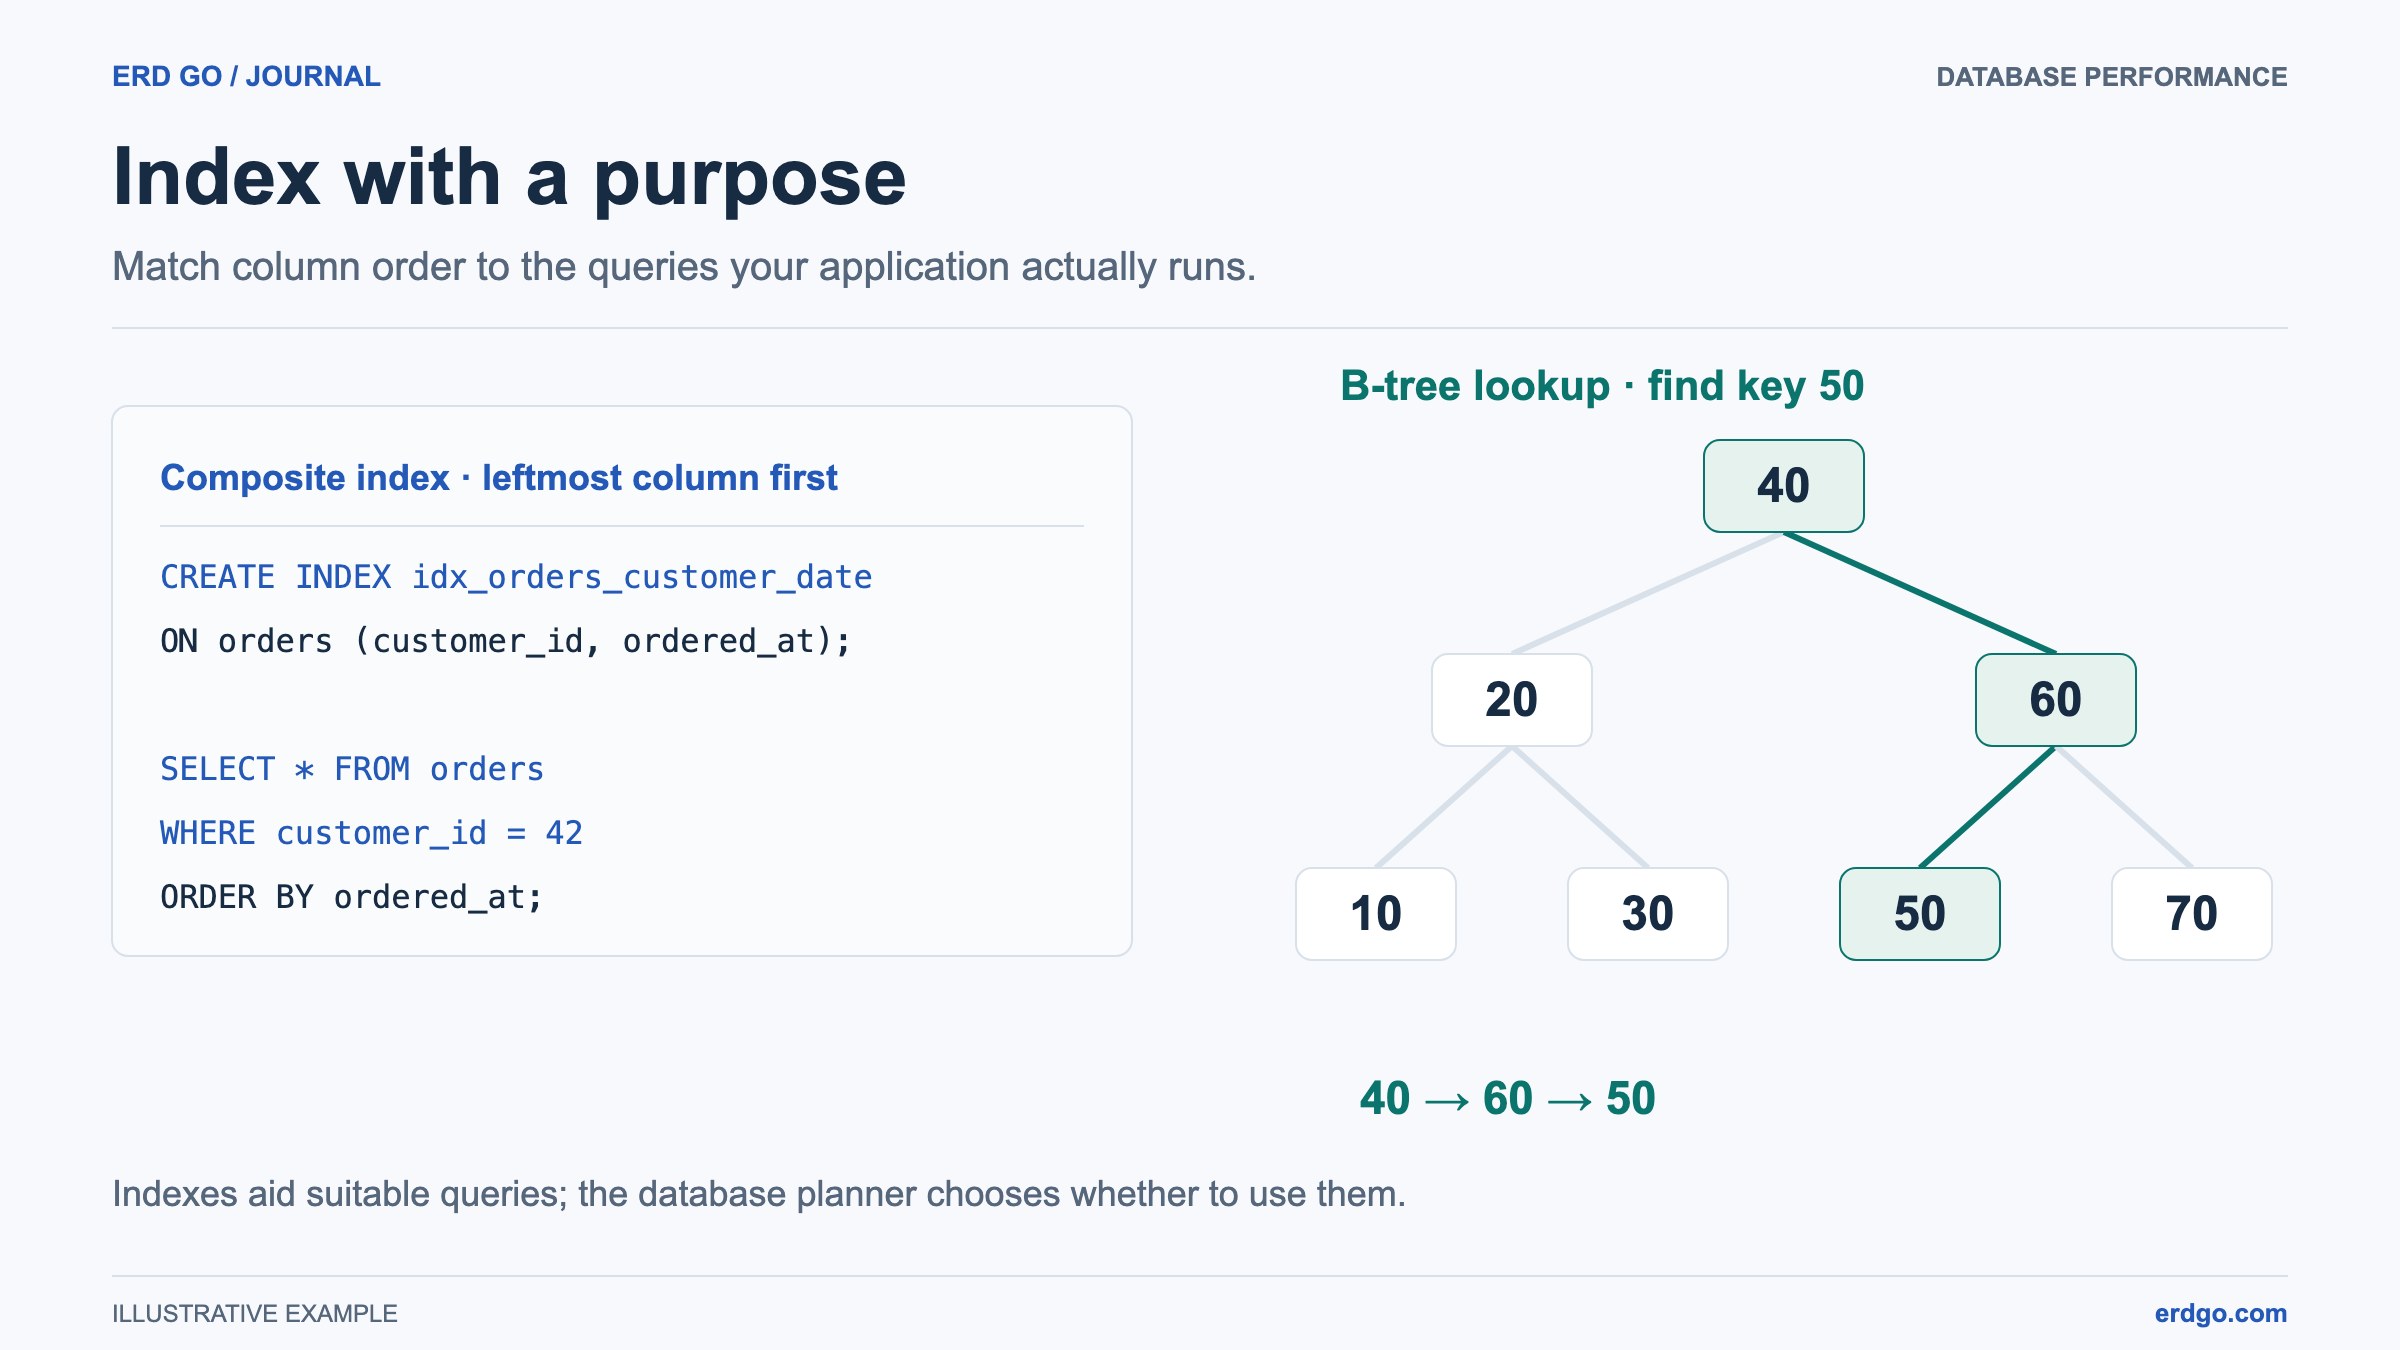
Le type d'index le plus courant dans PostgreSQL, MySQL, SQL Server et SQLite est le B-tree (arbre équilibré). Pensez-y comme à un annuaire téléphonique : au lieu de lire chaque nom de A à Z, vous l'ouvrez à la section approximative, vous affinez jusqu'à la bonne page et vous tombez sur l'entrée. Un arbre B fonctionne de manière similaire :
- L'arborescence est organisée en nœuds. Chaque nœud interne contient des clés triées et des pointeurs vers les nœuds enfants.
- Une recherche commence au racine, compare la valeur recherchée aux clés de nœud et suit le bon pointeur à travers branche nœuds.
- Il atteint un feuille contenant des entrées correspondantes. Selon le moteur et l'index, les entrées identifient des lignes, contiennent une clé en cluster ou détiennent les données de la ligne elles-mêmes.
- L'arborescence reste équilibrée, mais sa profondeur et ses E/S dépendent de la largeur des clés, de la taille des pages, du nombre de lignes, de la mise en cache et du fait que la requête récupère également ou non les pages de table.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Quand devez-vous utiliser des index ?
Les index ne sont pas gratuits. Ils consomment de l'espace disque et ajoutent une surcharge à chaque INSERT, UPDATE, et DELETE car le moteur doit maintenir l'index synchronisé avec les données de la table. Utilisez-les stratégiquement :
- Colonnes dans
WHEREclauses. Un index approprié peut aider un filtre sélectif fréquent ; son utilité dépend de la distribution des données et du plan choisi. - Colonnes dans
JOINconditions. Les index peuvent aider les jointures de clés étrangères ainsi que les mises à jour ou suppressions de parents ; une grande jointure peut tout de même privilégier un parcours complet (scan). - Colonnes dans
ORDER BYetGROUP BY. Un index peut fournir des Données pré-triées, éliminant ainsi une opération de tri coûteuse. - Colonnes à haute cardinalité. Les colonnes ayant de nombreuses valeurs distinctes (comme un e-mail ou un UUID) en profitent davantage que les colonnes ayant peu de valeurs distinctes (comme un booléen
is_activeindicateur). - Grandes tables. Une table de 100 lignes a rarement besoin d'index supplémentaires. Une table de 10 millions de lignes en a presqu'assurément besoin.
En règle générale : commencer sans index supplémentaires, mesurer les performances des requêtes avec EXPLAIN, puis ajoutez des index là où les données vous l'indiquent.
Types d'index
Index à une seule colonne
La forme la plus simple. Crée un arbre B (B-tree) sur une colonne. Idéal pour les requêtes qui filtrent ou trient sur cette colonne seule.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Index composite (multicolonne)
Un index sur deux colonnes ou plus. Les filtres d'égalité sur les colonnes principales et une plage sur la suivante forment souvent un chemin d'accès B-tree efficace. D'autres conditions peuvent toujours utiliser un parcours ou un parcours avec saut (skip scan) ; la prise en charge et le coût varient selon le moteur et la version.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Choisissez l'ordre des colonnes en fonction des filtres d'égalité, des conditions de plage, du tri et des besoins de couverture. « Le plus sélectif en premier » n'est pas une règle universelle. PostgreSQL 18 peut utiliser des parcours avec saut B-tree pour les filtres non principaux appropriés.
Index unique
Applique une contrainte d'unicité tout en offrant des performances de recherche basées sur les index. La plupart des bases de données créent automatiquement un index unique lorsque vous définissez un UNIQUE contrainte ou PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Index partiel (filtré)
Indexe uniquement les lignes qui satisfont à WHERE condition. Cela maintient l'index petit et hautement ciblé.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Un index partiel ou filtré peut aider un sous-ensemble restreint et fréquemment interrogé. Le prédicat de la requête doit impliquer le filtre. La syntaxe de filtre de SQL Server est plus restrictive que celle de PostgreSQL ; ne copiez pas de prédicats arbitraires entre eux.
Autres types d'index
| Type d'index | Idéal pour | Prise en charge des bases de données |
|---|---|---|
| Hachage | Recherches d'égalité exacte (=) | PostgreSQL, MySQL (moteur Memory) |
| GIN | Recherche en texte intégral, JSONB, tableaux | PostgreSQL |
| GiST | Types de données géométriques et de plage | PostgreSQL |
| BRIN | Très grandes tables avec des données naturellement ordonnées | PostgreSQL |
| Texte intégral | Recherche textuelle avec classement par pertinence | MySQL, SQL Server |
Erreurs d'indexation courantes
Même les développeurs expérimentés tombent dans ces pièges. Évitez-les pour maintenir les performances de votre base de données.
1. Sur-indexation
Ajouter un index sur chaque colonne « au cas où » gaspille de l'espace disque et ralentit les écritures. Chaque index doit être mis à jour à chaque insertion, mise à jour et suppression. Une table comportant 15 index aura un débit d'écriture nettement plus lent qu'une table comportant 3 index bien choisis.
2. Indexation de colonnes à faible cardinalité
Indexation d'un booléen is_active colonne qui contient uniquement TRUE et FALSE peut être utile lorsque les valeurs sont très asymétriques ou que l'index couvre une requête étroite. La cardinalité seule ne détermine pas si un index aide. Si vous devez filtrer sur de telles colonnes, combinez-les dans un index composite avec une colonne à plus forte cardinalité, ou utilisez un index partiel.
3. Ignorer les modèles de requête
Un index n'est utile que si vos Requêtes réelles peuvent l'exploiter. Examinez toujours les Requêtes lentes dans votre application d'abord, puis concevez des index qui ciblent ces schémas d'accès spécifiques.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Oublier d'indexer les clés étrangères
Dans PostgreSQL, les colonnes de clés étrangères sont pas indexé automatiquement (contrairement à InnoDB de MySQL, qui crée un index sur les clés étrangères par défaut). Un index peut aider les jointures sélectives et les vérifications référentielles, mais l'optimiseur peut choisir un parcours ou une jointure par hachage. Vérifiez la présence d'un index existant dont les colonnes principales couvrent déjà la clé étrangère avant d'en ajouter un autre.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Ne jamais examiner les index inutilisés
Au fil du temps, le code de l'application change et les anciens index peuvent ne plus servir à aucune requête. Les index inutilisés consomment toujours du stockage et ralentissent les écritures sans aucun avantage en lecture.
Surveillance de l'utilisation des index
Les bases de données modernes fournissent des vues système qui indiquent la fréquence d'utilisation de chaque index. Les examiner régulièrement vous aide à supprimer les index inutilisés et à repérer ceux qui manquent.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Traitez zéro lecture comme un candidat à l'examen, et non comme une autorisation de supprimer un index. Vérifiez quand les compteurs ont été réinitialisés, si l'instrumentation est activée et si des requêtes saisonnières, des contraintes ou des vérifications de clés étrangères en ont besoin. Testez une suppression proposée avec une charge de travail représentative.
Les index dans la conception de schémas et les diagrammes ERD
Bien que les ERD se concentrent principalement sur les tables, les colonnes et les relations, les index constituent une partie importante de la conception globale du schéma. Lors de la planification de votre base de données, considérez les index parallèlement aux définitions de vos tables :
- A clé primaire a normalement un chemin d'accès géré par le moteur. SQLite INTEGER PRIMARY KEY utilise le rowid plutôt qu'un index unique séparé ; vérifiez le moteur avant d'ajouter un index en double.
- Examiner les chemins d'accès pour clés étrangères. PostgreSQL ne crée pas automatiquement d'index du côté enfant, mais un index composite existant peut déjà couvrir la relation.
- Colonnes avec Contraintes UNIQUE reçoivent un index unique automatique.
- Les index supplémentaires pour les colonnes fréquemment interrogées doivent être documentés avec le DDL de votre schéma afin qu'ils ne soient pas oubliés lors du déploiement.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualisez votre schéma complet — tables, relations et colonnes que vous prévoyez d'indexer — en collant votre DDL dans le Éditeur Erd Go. Visualiser la structure met souvent en évidence des colonnes qui nécessitent d'être indexées (comme des clés étrangères fréquemment jointes) que vous pourriez négliger en lisant du code SQL brut.