Los ejemplos de SQL utilizan PostgreSQL a menos que se mencione otro dialecto. Los fragmentos cortos asumen que las tablas a las que se hace referencia ya existen. Valide el DDL en su base de datos de destino antes de aplicarlo.
¿Por qué los esquemas de PostgreSQL necesitan buenos diagramas?
Los esquemas de PostgreSQL a menudo contienen más que simples tablas. Los proyectos reales usan ENUM tipos, columnas de identidad, nombres calificados por esquema, campos JSON, tipos de matriz, claves compuestas, columnas generadas, índices parciales y claves foráneas con reglas de cascada. Un diagrama ayuda al equipo a entender toda esa estructura más rápido que leyendo DDL línea por línea.
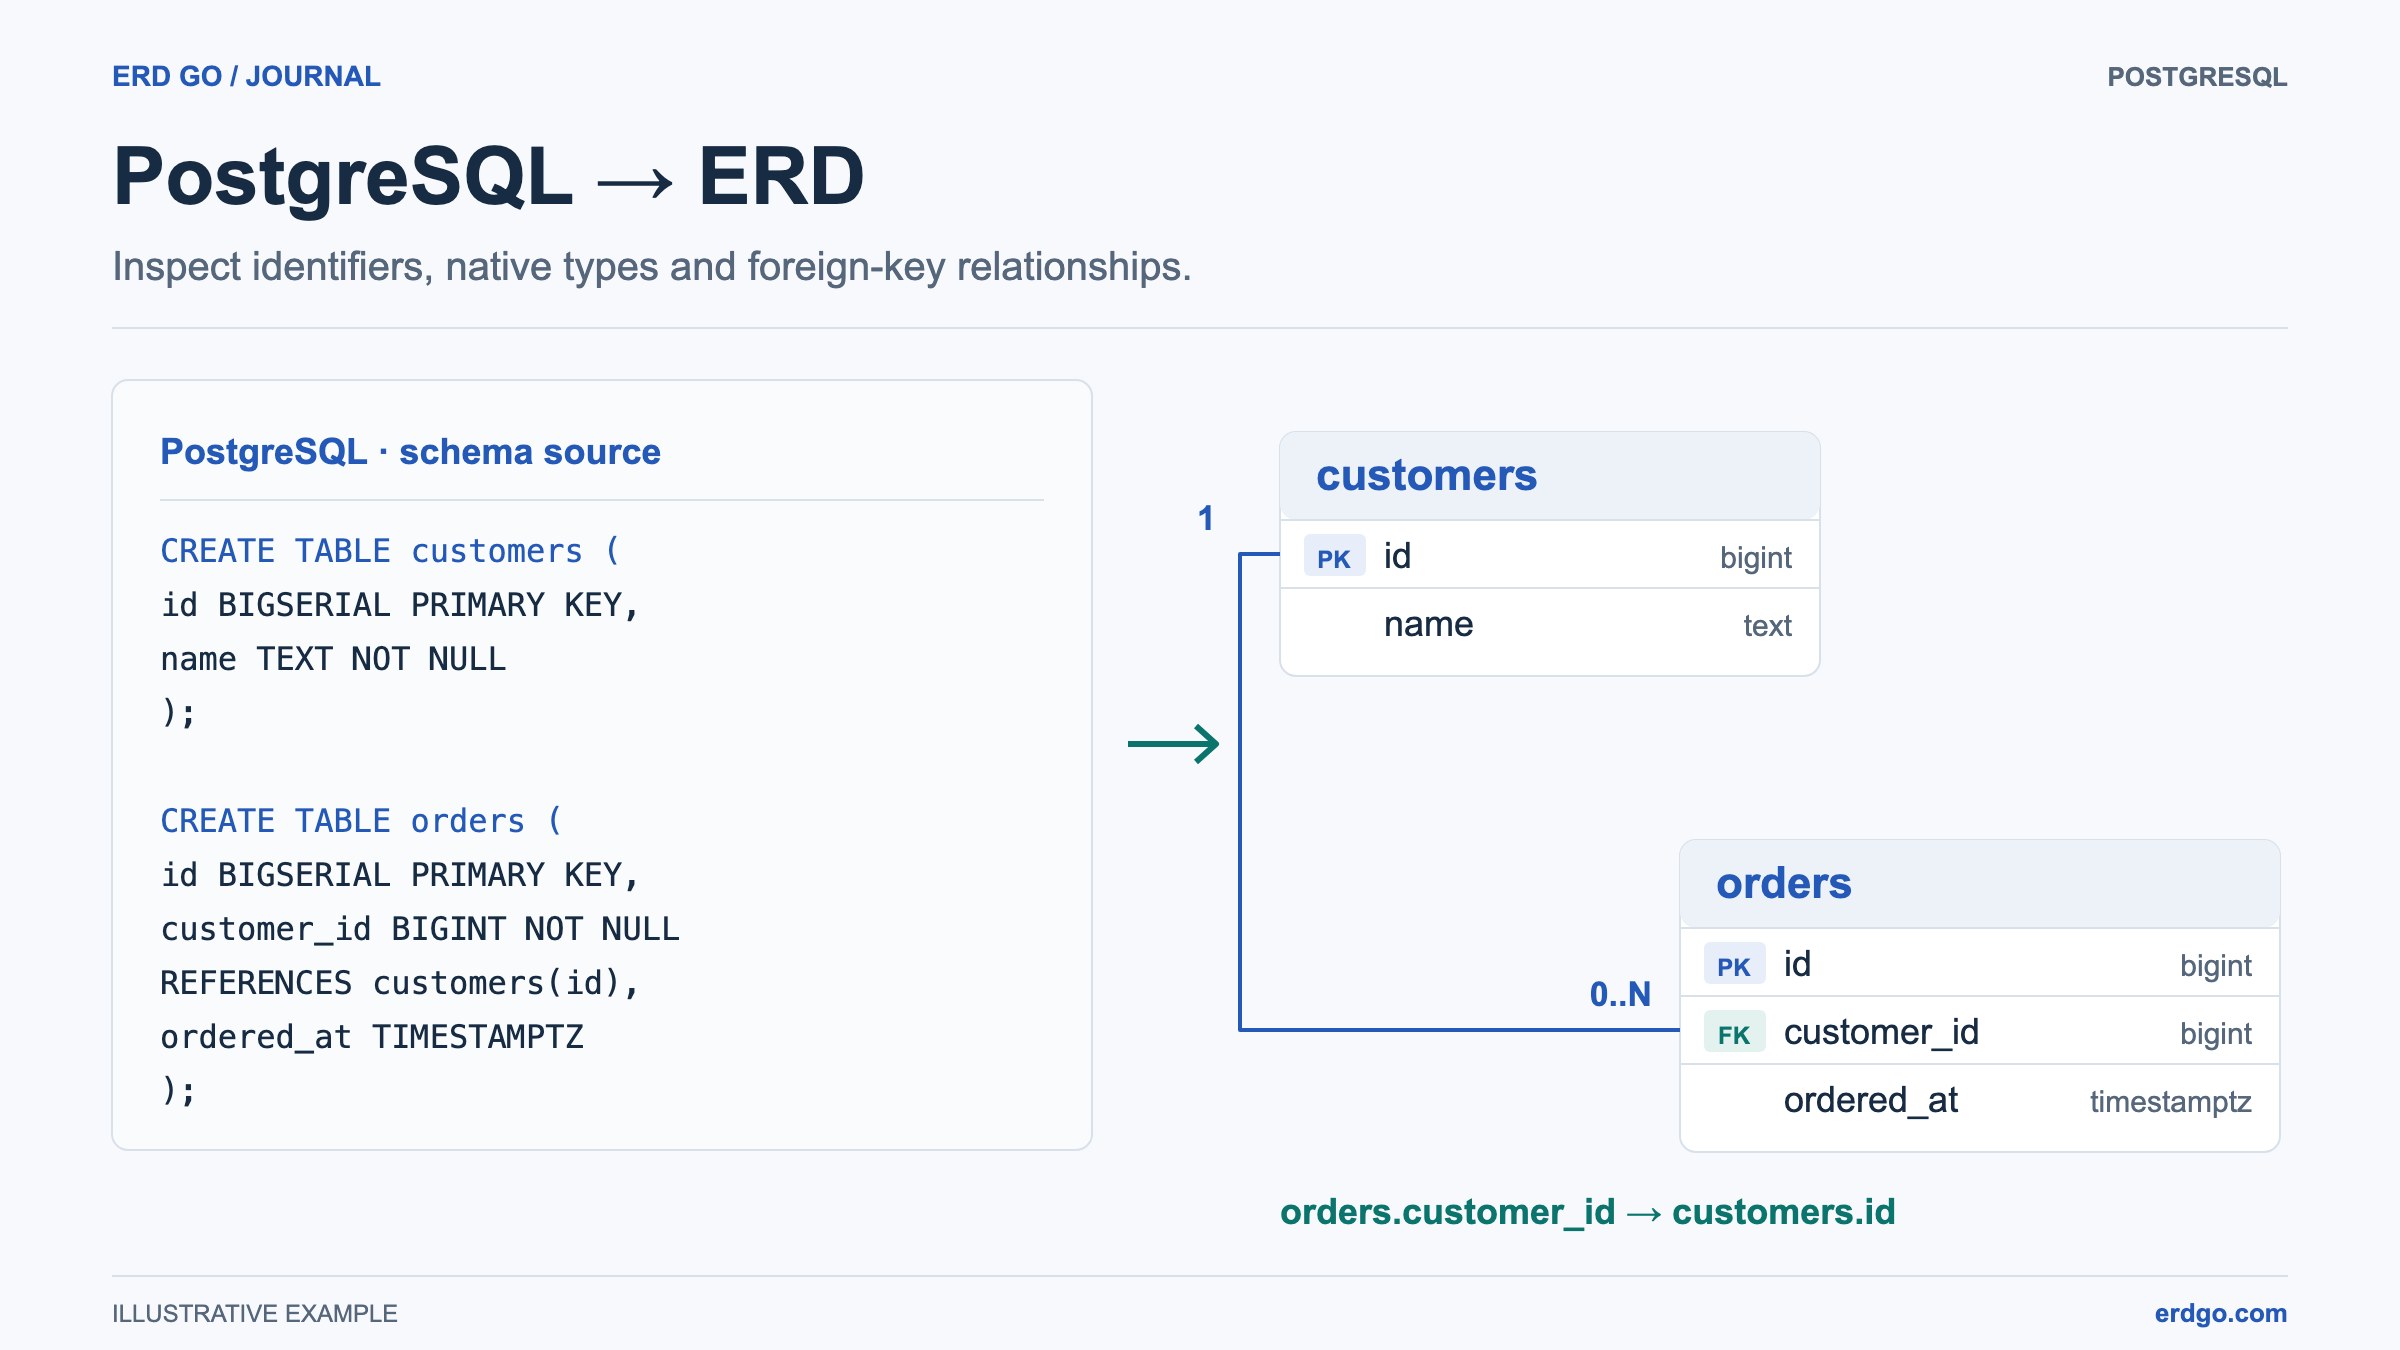
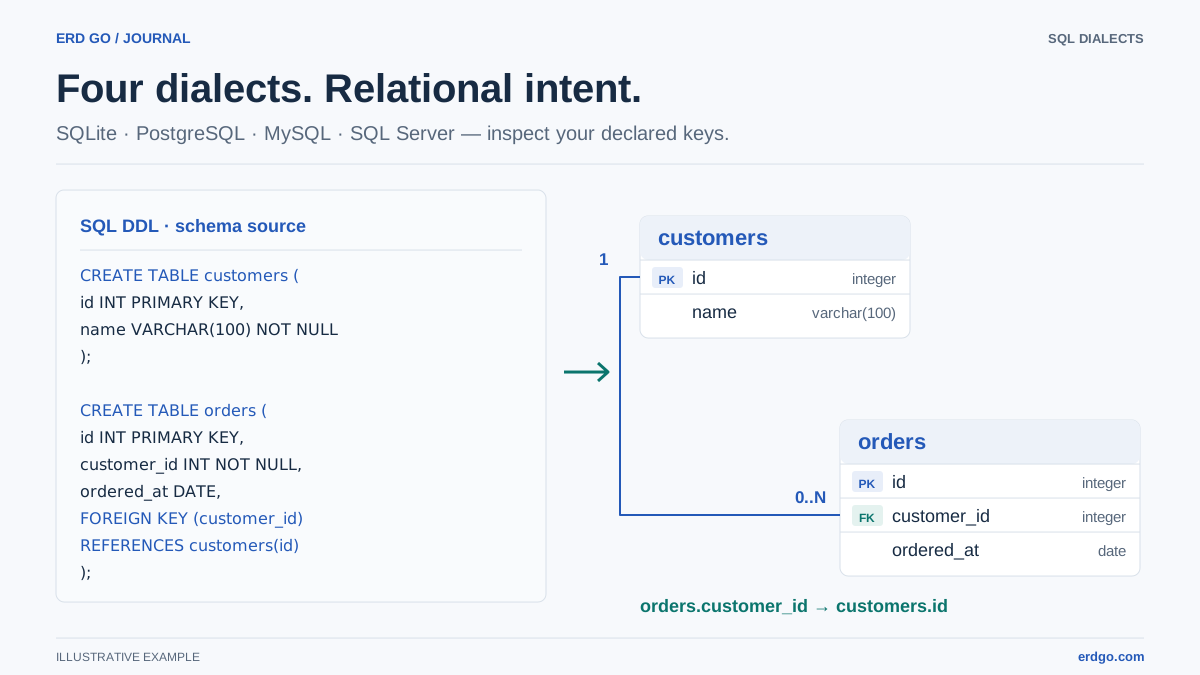
Un generador de ERD de PostgreSQL lee su DDL y crea un diagrama de relación de entidades con tablas, columnas, claves primarias, claves foráneas y restricciones. El Editor SQL a ERD de Erd Go admite definiciones de esquema al estilo de PostgreSQL para que pueda pegar DDL e inspeccionar el modelo de inmediato.
Características de PostgreSQL que vale la pena visualizar
Al elegir un flujo de trabajo de diagramas para Postgres, asegúrese de que la herramienta entienda las características de la base de datos que su aplicación realmente utiliza.
- Columnas de identidad y seriales. Claves primarias como
SERIAL,BIGSERIAL, yGENERATED ALWAYS AS IDENTITYdeben reconocerse como identificadores generados. - Tipos personalizados.
CREATE TYPE ... AS ENUMlos valores deben permanecer visibles en lugar de ser aplanados en cadenas genéricas. - Claves foráneas. En línea
REFERENCESy las restricciones a nivel de tabla con nombre deben producir relaciones de diagrama. - Objetos cualificados por esquema. Nombres como
billing.invoicesyauth.usersdeben permanecer comprensibles en el diagrama.
Ejemplo de DDL de PostgreSQL
Pegue este ejemplo en el editor para generar un Diagrama de clases al estilo PostgreSQL:
CREATE TYPE order_status AS ENUM ('draft', 'paid', 'shipped', 'cancelled');

CREATE TABLE customers (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    email       TEXT NOT NULL UNIQUE,
    full_name   TEXT NOT NULL,
    metadata    JSONB DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE orders (
    id          BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers (id),
    status      order_status NOT NULL DEFAULT 'draft',
    total       NUMERIC(12, 2) NOT NULL CHECK (total >= 0),
    tags        TEXT[] DEFAULT ARRAY[]::TEXT[],
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE order_events (
    id          BIGSERIAL PRIMARY KEY,
    order_id    BIGINT NOT NULL REFERENCES orders (id) ON DELETE CASCADE,
    event_name  TEXT NOT NULL,
    payload     JSONB NOT NULL DEFAULT '{}'::jsonb,
    created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_events_order_id ON order_events (order_id);
Las relaciones importantes son customers → orders y orders → order_events. El enum personalizado, las columnas JSONB, los arreglos, las comprobaciones e índices añaden detalles de implementación sin ocultar el modelo de datos principal.
Flujo de trabajo de ERD en Postgres
Para los equipos que usan PostgreSQL, un flujo de trabajo de diagramas centrado en SQL suele ser el más confiable.
- Exportar o copiar el DDL actual de sus archivos de migración, volcado de esquema o solicitud de extracción.
- Péguelo en Erd Go para generar el diagrama automáticamente.
- Mueva las tablas importantes a clústeres legibles como auth, billing, catalog y audit.
- Utilice el diagrama durante la revisión para comprobar claves foráneas faltantes y límites de propiedad confusos.
- Después de que se apruebe la migración, regenera el ERD a partir del DDL actualizado para que el diagrama se mantenga sincronizado.