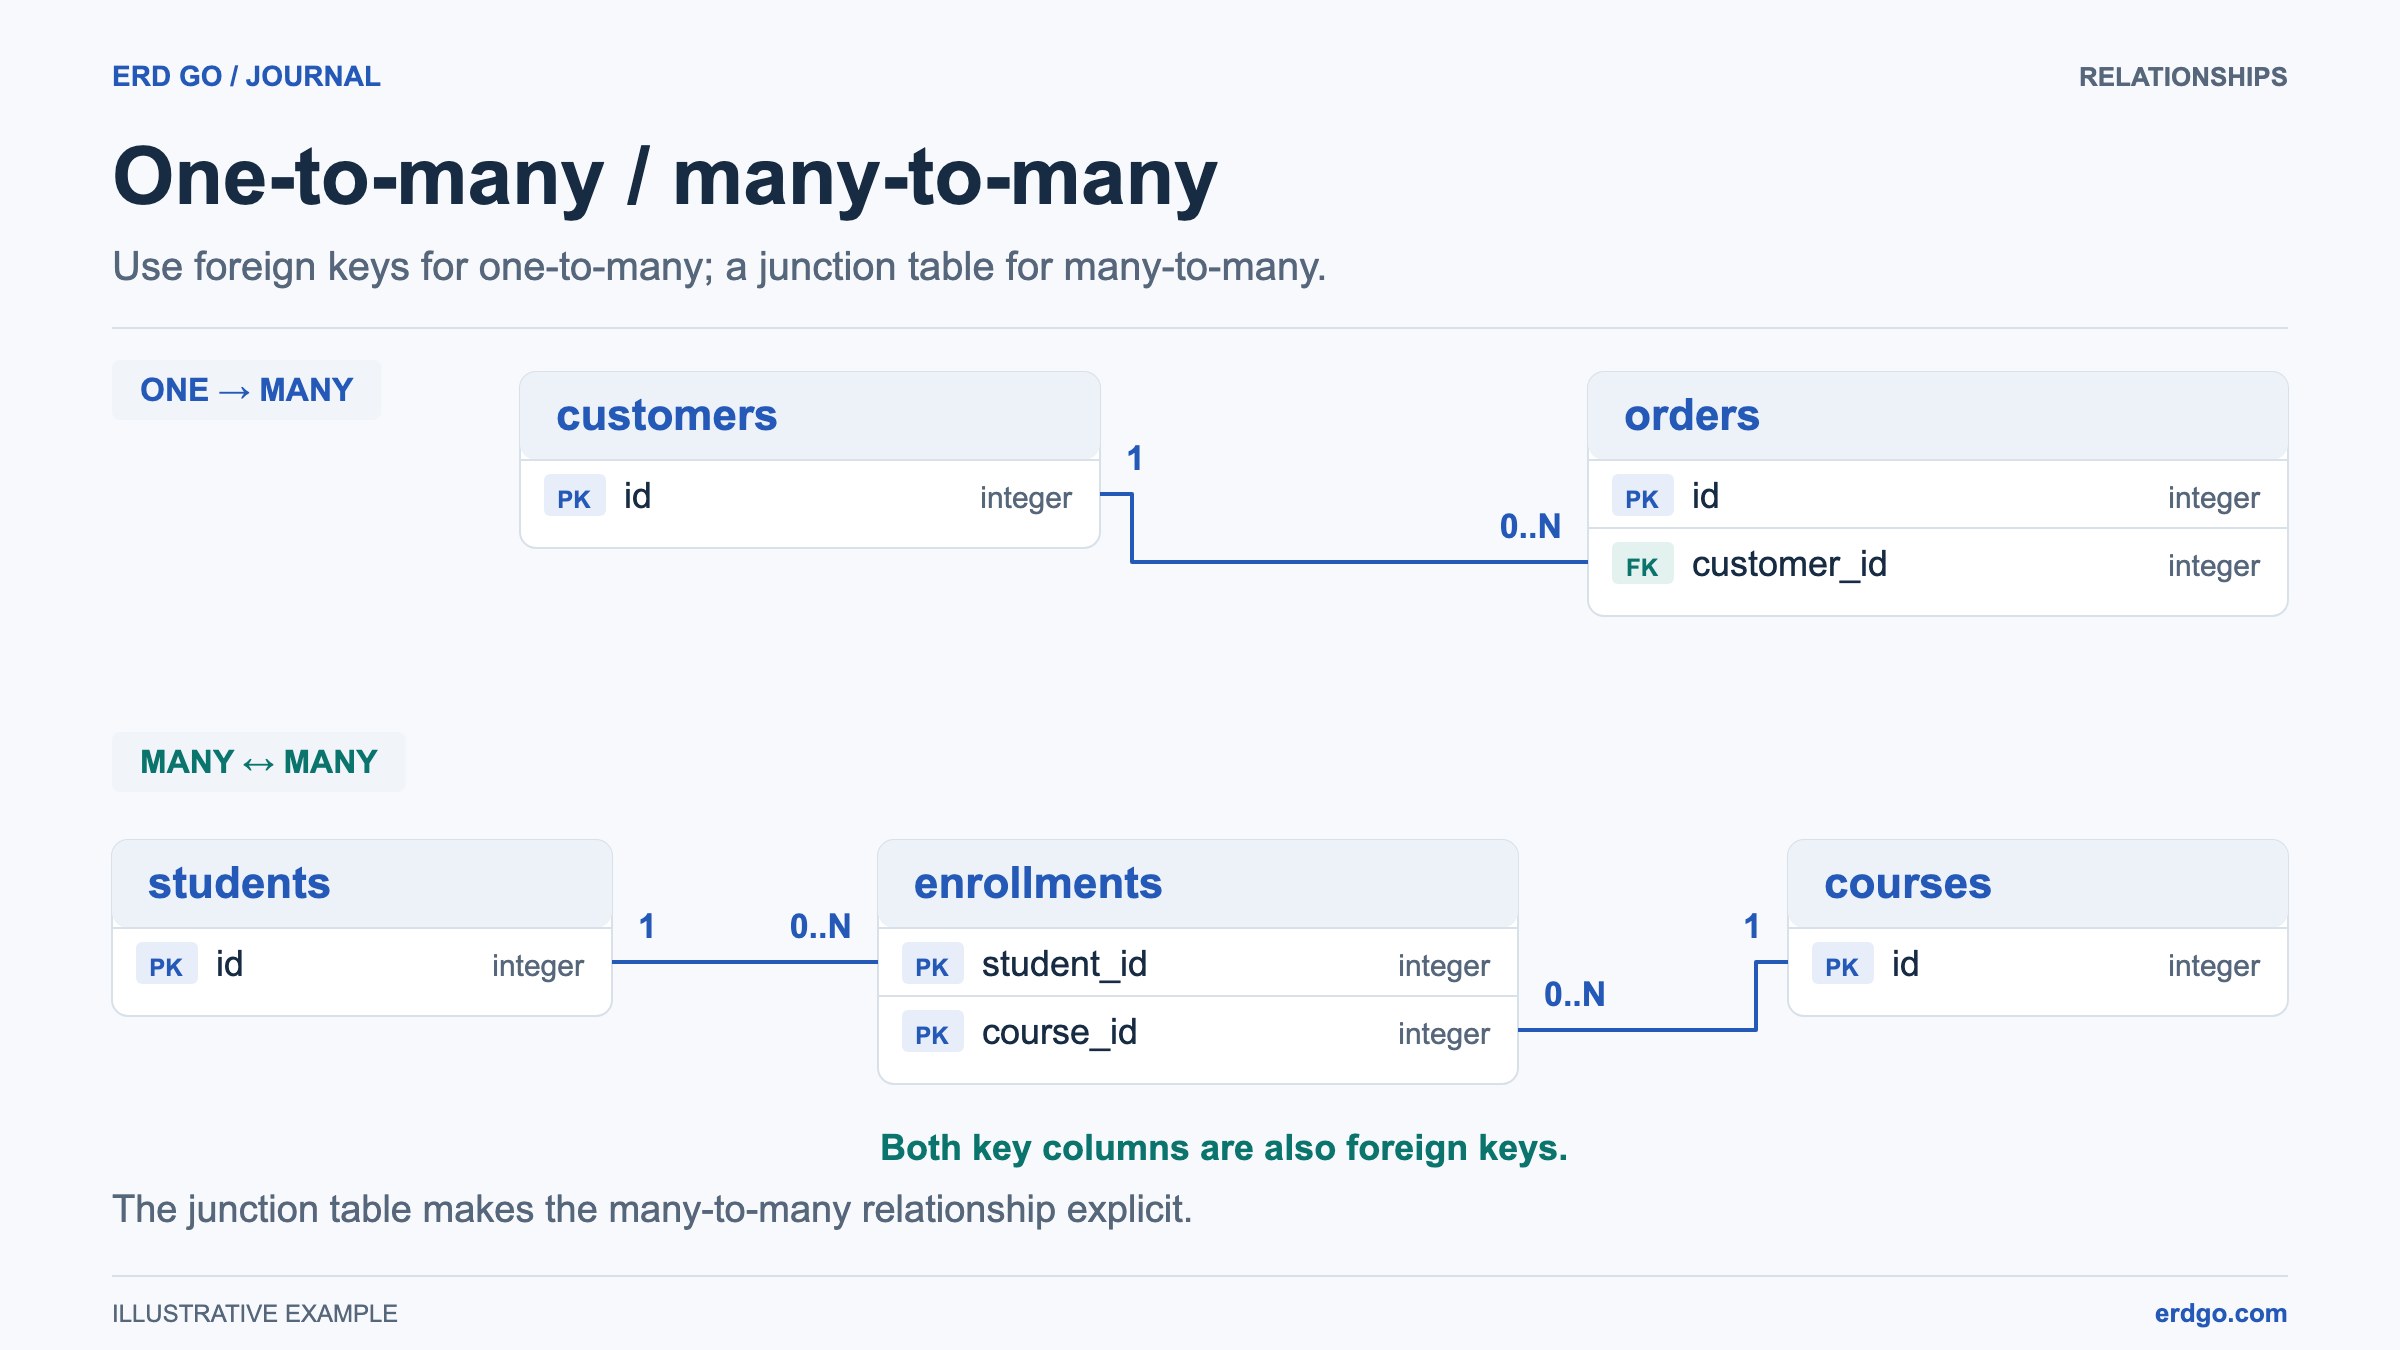
Los ejemplos de SQL utilizan PostgreSQL a menos que se mencione otro dialecto. Los fragmentos cortos asumen que las tablas a las que se hace referencia ya existen. Valide el DDL en su base de datos de destino antes de aplicarlo.
¿Qué es la normalización de bases de datos?
Normalización de bases de datos es el proceso de organizar una base de datos relacional para reducir la redundancia de datos y mejorar la integridad de los datos. Introducido por Edgar F. Codd en la década de 1970, la normalización implica dividir tablas grandes en tablas más pequeñas y relacionadas, y definir las relaciones entre ellas.
El objetivo es representar las dependencias de manera consistente y reducir la duplicación evitable. Las instantáneas históricas, como un precio de venta, pueden pertenecer a una tabla diferente porque representan hechos distintos.
¿Por qué normalizar?
- Eliminar redundancia — Evita almacenar los mismos datos en múltiples lugares.
- Prevenir anomalías de actualización — Los cambios en los datos solo necesitan ocurrir en un lugar.
- Prevenir anomalías de inserción — Puede agregar nuevos datos sin requerir datos no relacionados.
- Prevenir anomalías de eliminación — Eliminar un registro no elimina accidentalmente datos no relacionados.
- Admitir consultas mantenibles — Las dependencias claras hacen que las consultas sean más fáciles de razonar. El rendimiento depende de los patrones de acceso, índices y uniones; la normalización por sí sola no hace que una consulta sea más rápida.
Primera Forma Normal (1FN)
Una tabla está en 1NF cuando:
- Cada columna contiene solo valores atómicos (indivisibles)
- Cada columna contiene valores de un solo tipo
- Las filas son distinguibles por una clave candidata; declare una clave primaria para forzar un identificador elegido en SQL
- No hay grupos repetidos ni matrices
Antes de 1NF (Violando)
-- BAD: phone_numbers contains multiple values
| id | name  | phone_numbers          |
|----|-------|------------------------|
| 1  | Alice | 555-0100, 555-0101     |
| 2  | Bob   | 555-0200               |
Después de 1NF
CREATE TABLE contacts (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE phone_numbers (
  id SERIAL PRIMARY KEY,
  contact_id INTEGER REFERENCES contacts(id),
  phone VARCHAR(20) NOT NULL
);

-- Each phone number is in its own row
-- | id | contact_id | phone    |
-- |----|-----------|----------|
-- | 1  | 1         | 555-0100 |
-- | 2  | 1         | 555-0101 |
-- | 3  | 2         | 555-0200 |
Segunda Forma Normal (2NF)
Una tabla está en 2NF cuando:
- Ya está en 1FN
- Cada atributo no primo depende de cada completo clave candidata, sin dependencia de solo una parte de una clave
Una clave candidata es un conjunto mínimo de atributos que identifica de forma única una fila. Los atributos que aparecen en cualquier clave candidata son atributos primos. Las dependencias parciales importan cuando una clave candidata contiene varias columnas; las claves candidatas incluyen identificadores únicos alternativos, no solo la clave primaria elegida. Si una columna que no es clave depende solo de una parte de la clave, debe moverse a una tabla separada.
Antes de 2NF (Violando)
-- BAD: course_name depends only on course_id, not the full key
-- PK: (student_id, course_id)
| student_id | course_id | course_name | grade |
|-----------|-----------|-------------|-------|
| 1         | 101       | Math        | A     |
| 1         | 102       | Physics     | B     |
| 2         | 101       | Math        | C     |
Después de 2NF
CREATE TABLE students (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE courses (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE enrollments (
  student_id INTEGER REFERENCES students(id),
  course_id INTEGER REFERENCES courses(id),
  grade CHAR(2),
  PRIMARY KEY (student_id, course_id)
);

-- course_name now lives only in the courses table
-- grade depends on both student_id AND course_id
Tercera Forma Normal (3NF)
Una tabla está en 3NF cuando:
- Ya está en 2FN
- Para cada dependencia funcional no trivial X → A, X es una superclave o A pertenece a una clave candidata. En los ejemplos a continuación, esto elimina las dependencias transitivas entre atributos que no son clave.
Antes de 3NF (Violando)
-- BAD: department_name depends on department_id, not on id
| id | name  | department_id | department_name |
|----|-------|---------------|-----------------|
| 1  | Alice | 10            | Engineering     |
| 2  | Bob   | 10            | Engineering     |
| 3  | Carol | 20            | Marketing       |
Después de 3NF
CREATE TABLE departments (
  id INTEGER PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE employees (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL,
  department_id INTEGER REFERENCES departments(id)
);

-- department_name is stored only in the departments table
-- employees references it via foreign key
Un ejemplo normalizado completo
Aquí hay un esquema de comercio electrónico que separa productos, clientes, direcciones, pedidos y líneas de pedido. Suponiendo que cada identificador enumerado determina los atributos restantes, estas tablas satisfacen las formas normales ilustradas. Los precios de venta almacenados son hechos históricos, no copias del precio actual del producto.
CREATE TABLE categories (
  id SERIAL PRIMARY KEY,
  name VARCHAR(100) NOT NULL UNIQUE
);

CREATE TABLE products (
  id SERIAL PRIMARY KEY,
  name VARCHAR(200) NOT NULL,
  price NUMERIC(10, 2) NOT NULL CHECK (price >= 0),
  category_id INTEGER REFERENCES categories(id)
);

CREATE TABLE customers (
  id SERIAL PRIMARY KEY,
  email TEXT UNIQUE NOT NULL,
  full_name VARCHAR(150) NOT NULL
);

CREATE TABLE addresses (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  street VARCHAR(200) NOT NULL,
  city VARCHAR(100) NOT NULL,
  state VARCHAR(50),
  zip VARCHAR(20) NOT NULL
);

CREATE TABLE orders (
  id SERIAL PRIMARY KEY,
  customer_id INTEGER REFERENCES customers(id),
  shipping_address_id INTEGER REFERENCES addresses(id),
  status VARCHAR(20) DEFAULT 'pending',
  created_at TIMESTAMP DEFAULT now()
);

CREATE TABLE order_items (
  order_id INTEGER REFERENCES orders(id),
  product_id INTEGER REFERENCES products(id),
  quantity INTEGER NOT NULL CHECK (quantity > 0),
  unit_price NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
Pegue esto en Editor de Erd Go para ver el Diagrama de clases visual con todas las relaciones mapeadas automáticamente.
Cuándo desnormalizar
Si bien la normalización es generalmente una buena práctica, hay casos en los que la desnormalización mejora el rendimiento:
- Cargas de trabajo con uso intensivo de lectura — Si tu aplicación lee mucho más de lo que escribe, almacenar datos calculados o duplicados puede evitar JOINs costosos.
- Informes y analítica — Las tablas desnormalizadas o vistas materializadas se utilizan a menudo para paneles de control.
- Almacenamiento en caché de Datos calientes — Almacenar valores agregados de acceso frecuente directamente en una tabla.
- Patrones de acceso al estilo NoSQL — Cuando sus consultas siempre necesitan una combinación específica de datos.
La clave es normalice primero, luego desnormalice intencionalmente donde el rendimiento lo requiera, documentando por qué se tomó la decisión de compromiso.