Los ejemplos de SQL utilizan PostgreSQL a menos que se mencione otro dialecto. Los fragmentos cortos asumen que las tablas a las que se hace referencia ya existen. Valide el DDL en su base de datos de destino antes de aplicarlo.
¿Qué son los índices de base de datos?
Un índice es una estructura de datos mantenida por el motor de base de datos que proporciona una ruta de búsqueda rápida a las filas en una tabla. Para filtros selectivos, un índice puede reducir las filas o páginas leídas. El optimizador aún puede elegir un escaneo de tabla para tablas pequeñas o consultas que devuelven muchas filas. Mide el plan y el tiempo en lugar de asumir una aceleración fija.
¿Cómo funcionan los índices B-Tree?
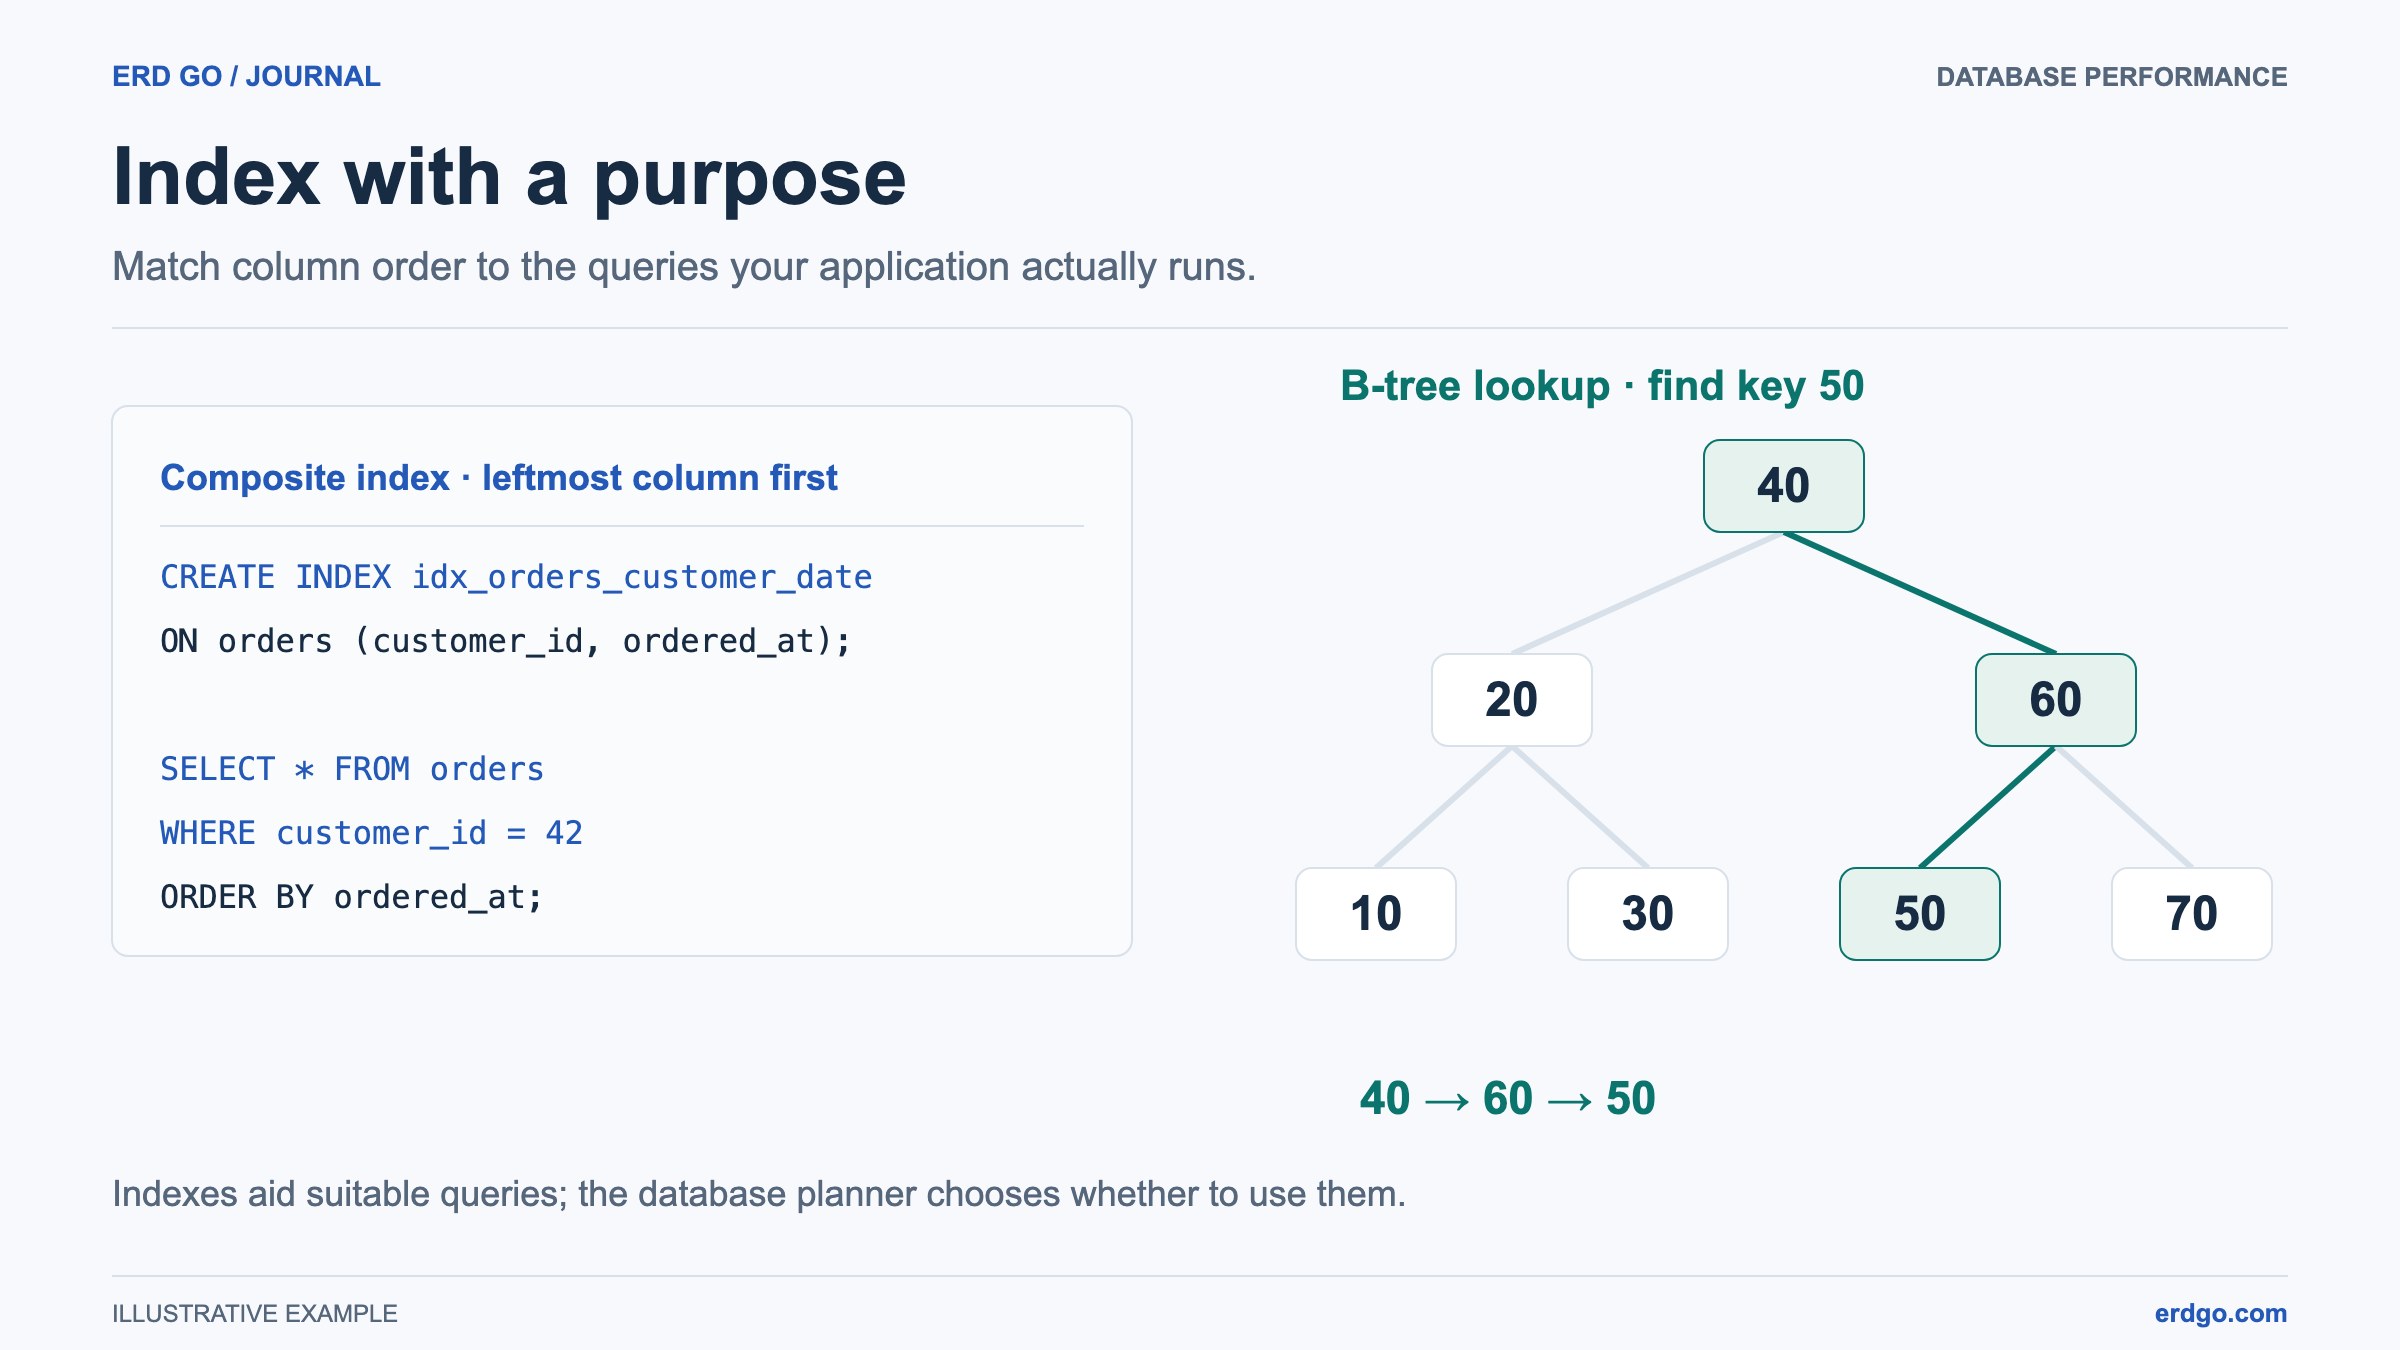
El tipo de índice más común en PostgreSQL, MySQL, SQL Server y SQLite es el B-tree (árbol balanceado). Piénselo como una guía telefónica: en lugar de leer cada nombre de la A a la Z, abre la sección aproximada, se reduce a la página correcta y llega a la entrada. Un B-tree funciona de manera similar:
- El árbol está organizado en nodos. Cada nodo interno contiene claves ordenadas y punteros a nodos hijos.
- Una búsqueda comienza en el raíz, compara el valor de búsqueda con las claves de los nodos y sigue el puntero correcto hacia abajo a través de rama nodos.
- Alcanza un hoja que contienen entradas coincidentes. Dependiendo del motor y el índice, las entradas identifican filas, contienen una clave agrupada o mantienen los datos de la fila en sí.
- El árbol se mantiene equilibrado, pero su profundidad y E/S dependen del ancho de la clave, el tamaño de la página, el recuento de filas, el almacenamiento en caché y si la consulta también obtiene páginas de tabla.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
¿Cuándo debería usar índices?
Los índices no son gratuitos. Consumen espacio en disco y añaden sobrecarga a cada INSERT, UPDATE, y DELETE porque el motor debe mantener el índice sincronizado con los datos de la tabla. Úselos estratégicamente:
- Columnas en
WHEREcláusulas. Un índice adecuado puede ayudar a un filtro selectivo frecuente; su beneficio depende de la distribución de los Datos y del plan elegido. - Columnas en
JOINcondiciones. Los índices pueden ayudar a las uniones de claves foráneas y a las actualizaciones o eliminaciones de padres; una unión grande aún puede favorecer un escaneo. - Columnas en
ORDER BYyGROUP BY. Un índice puede proporcionar Datos preordenados, eliminando una costosa operación de ordenación. - Columnas de alta cardinalidad. Las columnas con muchos valores distintos (como correo electrónico o UUID) se benefician más que las columnas con pocos valores distintos (como un booleano
is_activebandera). - Tablas grandes. Una tabla con 100 filas rara vez necesita índices adicionales. Una tabla con 10 millones de filas casi con seguridad los necesita.
Como regla general: comienza sin índices adicionales, mide el rendimiento de la consulta con EXPLAIN, luego agregue índices donde los Datos le indiquen.
Tipos de índices
Índice de una sola columna
La forma más simple. Crea un árbol B en una columna. Ideal para consultas que filtran u ordenan solo en esa columna.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Índice compuesto (multicolumna)
Un índice sobre dos o más columnas. Los filtros de igualdad en las columnas principales y un rango en la siguiente suelen formar una ruta de acceso de árbol B eficiente. Otras condiciones pueden seguir utilizando un escaneo o un escaneo de salto; el soporte y el costo varían según el motor y la versión.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Elija el orden de las columnas según los filtros de igualdad, las condiciones de rango, la ordenación y las necesidades de cobertura. “El más selectivo primero” no es una regla universal. PostgreSQL 18 puede utilizar exploraciones salteadas de árbol B para filtros no iniciales adecuados.
Índice único
Impone una restricción de unicidad al tiempo que proporciona un rendimiento de búsqueda basado en índices. La mayoría de las bases de datos crean automáticamente un índice único cuando se define un UNIQUE restricción o PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Índice parcial (filtrado)
Indexa solo las filas que satisfacen una WHERE condición. Esto mantiene el índice pequeño y altamente dirigido.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Un índice parcial o filtrado puede ayudar a un subconjunto pequeño y consultado con frecuencia. El predicado de la Consulta debe implicar el filtro. La sintaxis de filtro de SQL Server es más restringida que la de PostgreSQL; no copies predicados arbitrarios entre ellos.
Otros tipos de índice
| Tipo de índice | Ideal para | Soporte de bases de datos |
|---|---|---|
| Hash | Búsquedas de igualdad exacta (=) | PostgreSQL, MySQL (motor de memoria) |
| GIN | Búsqueda de texto completo, JSONB, arrays | PostgreSQL |
| GiST | Tipos de datos geométricos y de rango | PostgreSQL |
| BRIN | Tablas muy grandes con datos ordenados naturalmente | PostgreSQL |
| Texto completo | Búsqueda de texto con clasificación de relevancia | MySQL, SQL Server |
Errores comunes de indexación
Incluso los desarrolladores experimentados caen en estas trampas. Evítelas para que su base de datos siga funcionando bien.
1. Sobreindexación
Añadir un índice en cada columna “por si acaso” desperdicia espacio en disco y ralentiza las escrituras. Cada índice debe actualizarse en cada insert, update y delete. Una tabla con 15 índices tendrá un rendimiento de escritura significativamente más lento que una con 3 índices bien elegidos.
2. Indexación de columnas de baja cardinalidad
Indexación de un booleano is_active columna que contiene solo TRUE y FALSE puede ser útil cuando los valores están altamente sesgados o el índice cubre una consulta estrecha. La cardinalidad por sí sola no decide si un índice ayuda. Si debe filtrar en dichas columnas, combínelas en un índice compuesto con una columna de mayor cardinalidad, o use un índice parcial.
3. Ignorar patrones de consulta
Un índice solo es útil si sus consultas reales pueden aprovecharlo. Examine siempre las consultas lentas en su aplicación. primero, luego diseñe índices que apunten a esos patrones de acceso específicos.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Olvidar indexar las claves foráneas
En PostgreSQL, las columnas de clave foránea son no indexado automáticamente (a diferencia de InnoDB de MySQL, que crea un índice en las claves foráneas de forma predeterminada). Un índice puede ayudar con uniones selectivas y comprobaciones referenciales, pero el optimizador puede elegir un escaneo o una unión hash. Compruebe si existe un índice cuyas columnas principales ya cubran la clave foránea antes de añadir otro.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. No revisar nunca los índices sin uso
Con el tiempo, el código de la aplicación cambia y es posible que los índices antiguos ya no sirvan para ninguna consulta. Los índices no utilizados siguen consumiendo almacenamiento y ralentizan las escrituras sin aportar ningún beneficio de lectura.
Monitoreo del uso de índices
Las bases de datos modernas proporcionan vistas del sistema que informan con qué frecuencia se usa cada índice. Revisarlas periódicamente le ayuda a eliminar índices no utilizados y a detectar los que faltan.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Trate las lecturas cero como un candidato a revisión, no como un permiso para eliminar un índice. Verifique cuándo se restablecieron los contadores, si la instrumentación está habilitada y si las consultas estacionales, las restricciones o las comprobaciones de claves foráneas lo necesitan. Pruebe una eliminación propuesta con una carga de trabajo representativa.
Índices en el diseño de esquemas y ERD
Si bien los ERD se centran principalmente en tablas, columnas y relaciones, los índices son una parte importante del diseño general del esquema. Al planificar su base de datos, considere los índices junto con las definiciones de sus tablas:
- A clave primaria normalmente tiene una ruta de acceso gestionada por el motor. SQLite INTEGER PRIMARY KEY utiliza el rowid en lugar de un índice único separado; verifique el motor antes de agregar un índice duplicado.
- Revise las rutas de acceso para claves foráneas. PostgreSQL no crea índices del lado hijo automáticamente, pero un índice compuesto existente ya puede cubrir la relación.
- Columnas con Restricciones UNIQUE reciben un índice único automático.
- Los índices adicionales para las columnas consultadas con frecuencia deben documentarse junto con el DDL de su esquema para que no se olviden durante el despliegue.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualice su esquema completo (tablas, relaciones y las columnas que planea indexar) pegando su DDL en el Editor de Erd Go. Ver la estructura de forma visual a menudo revela columnas que necesitan indexación (como claves foráneas unidas con frecuencia) que podrías pasar por alto al leer SQL en bruto.