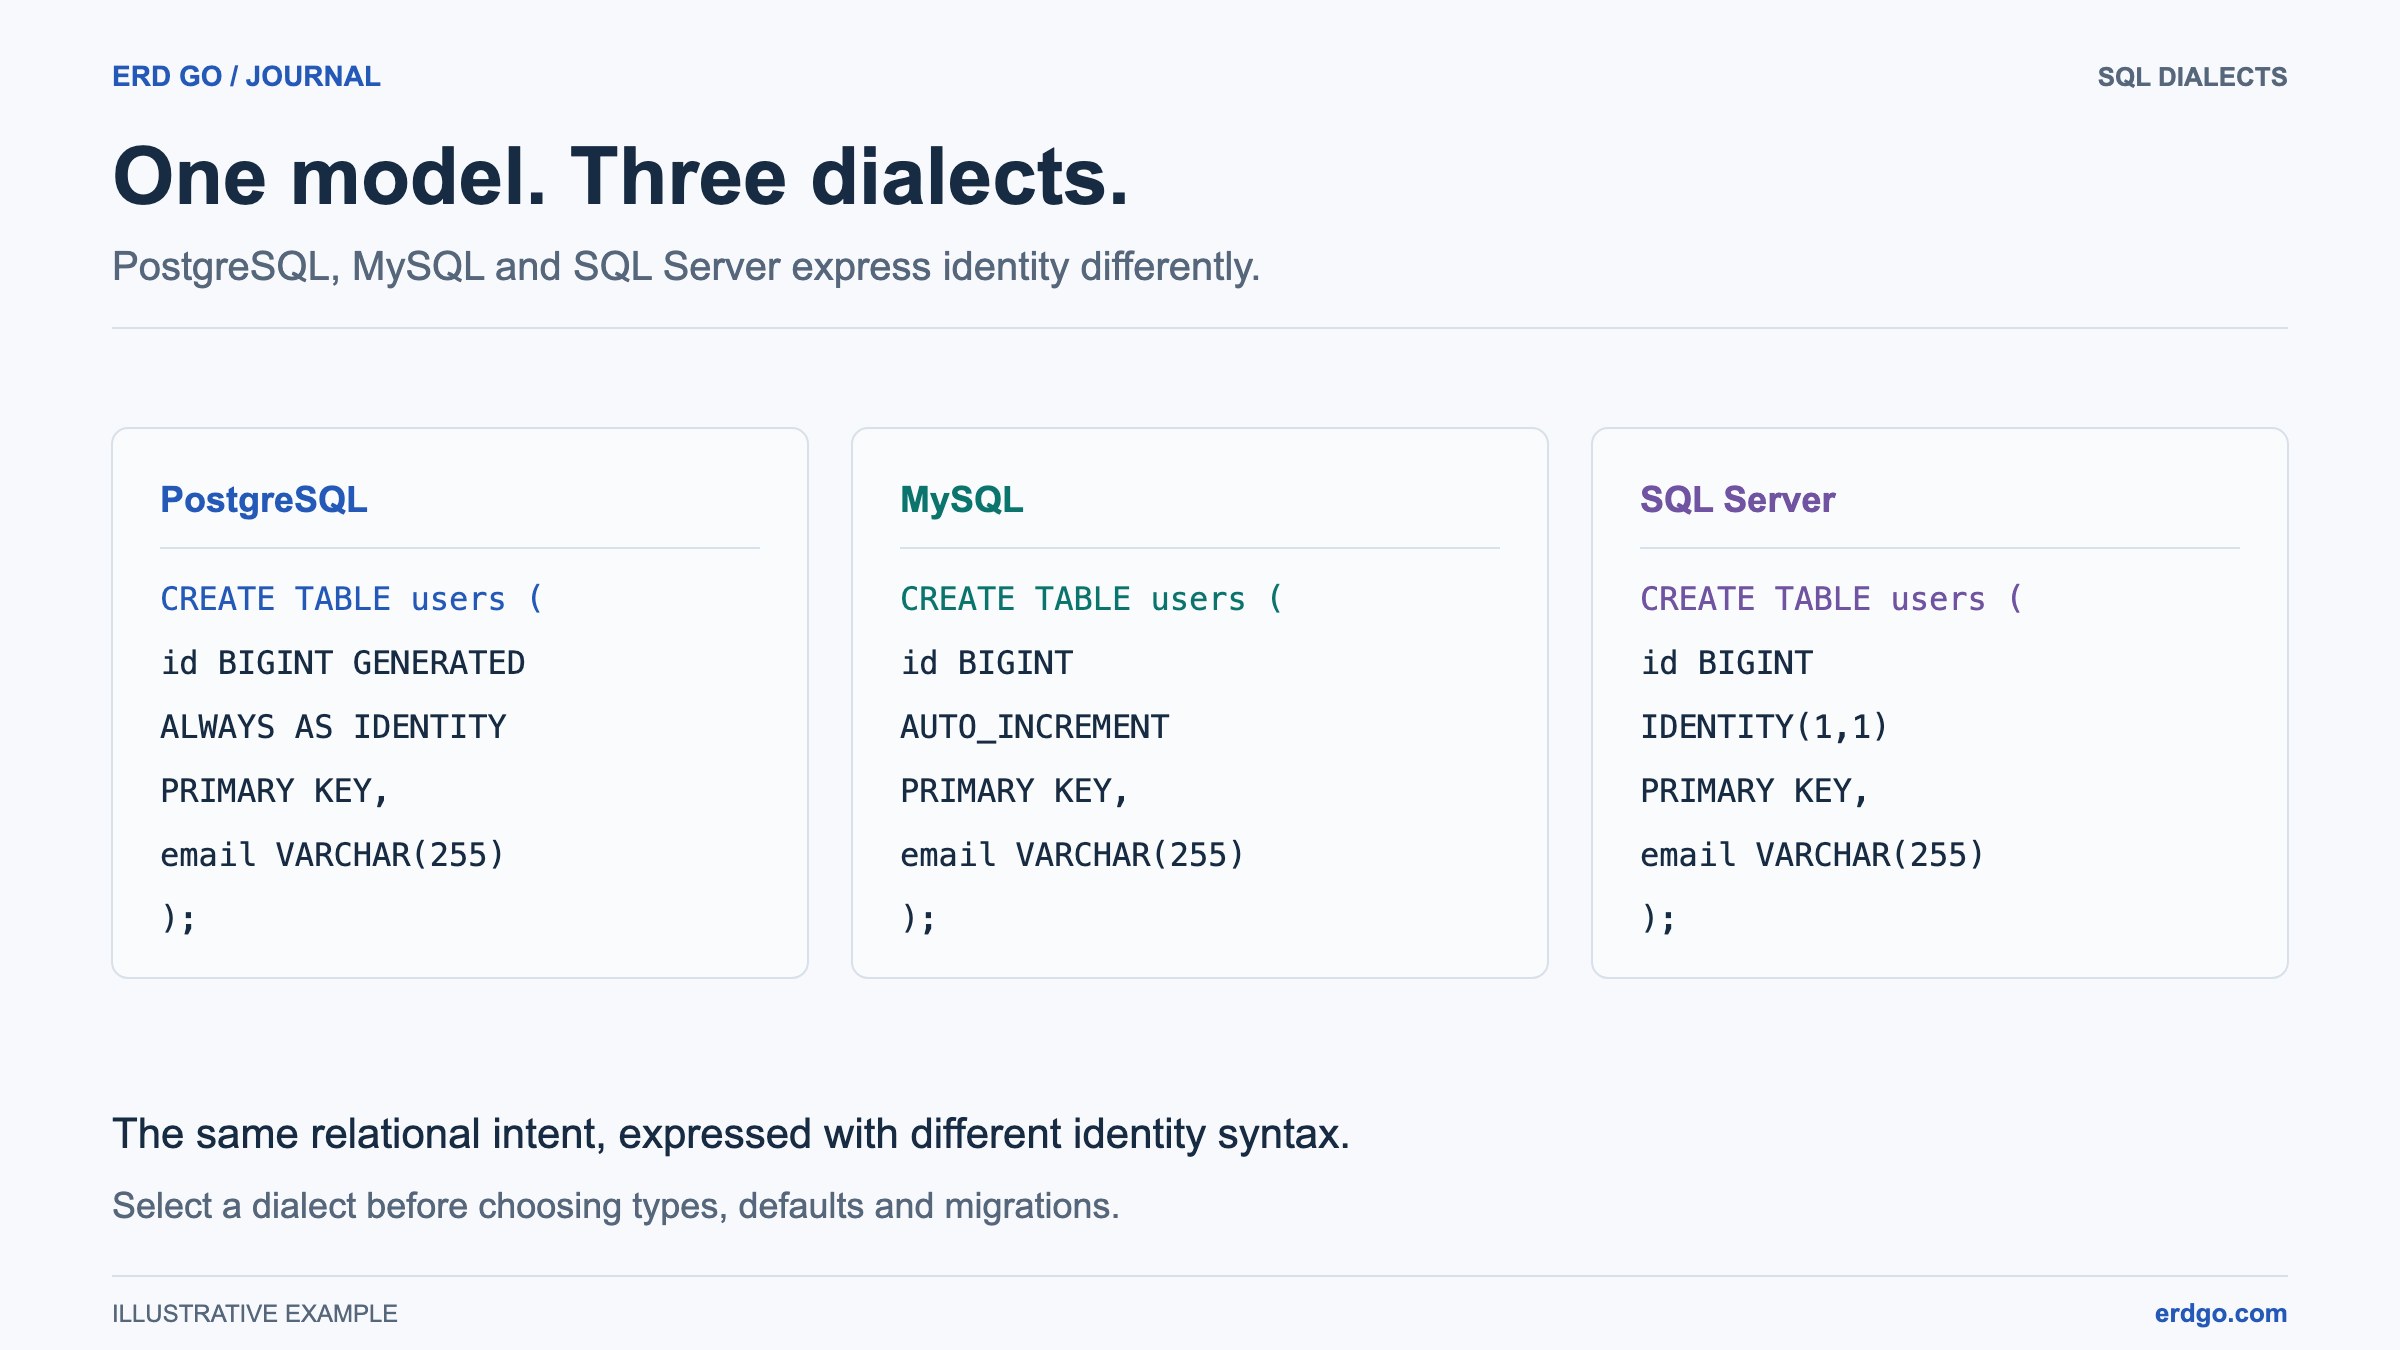
SQL-Beispiele verwenden PostgreSQL, sofern kein anderes Dialekt genannt wird. Kurze Schnipsel setzen voraus, dass ihre referenzierten Tabellen bereits existieren. Validieren Sie DDL in Ihrer Zieldatenbank, bevor Sie sie anwenden.
Was sind Datenbankindizes?
Ein Index ist eine Datenstruktur, die von der Datenbank-Engine verwaltet wird und einen schnellen Zugriffspfad zu Zeilen in einer Tabelle bereitstellt. Bei selektiven Filtern kann ein Index die gelesenen Zeilen oder Seiten reduzieren. Der Optimierer kann für kleine Tabellen oder Abfragen, die viele Zeilen zurückgeben, dennoch einen Tabellenscan wählen. Messen Sie den Ausführungsplan und die Zeit, anstatt eine feste Beschleunigung anzunehmen.
Wie B-Tree-Indizes funktionieren
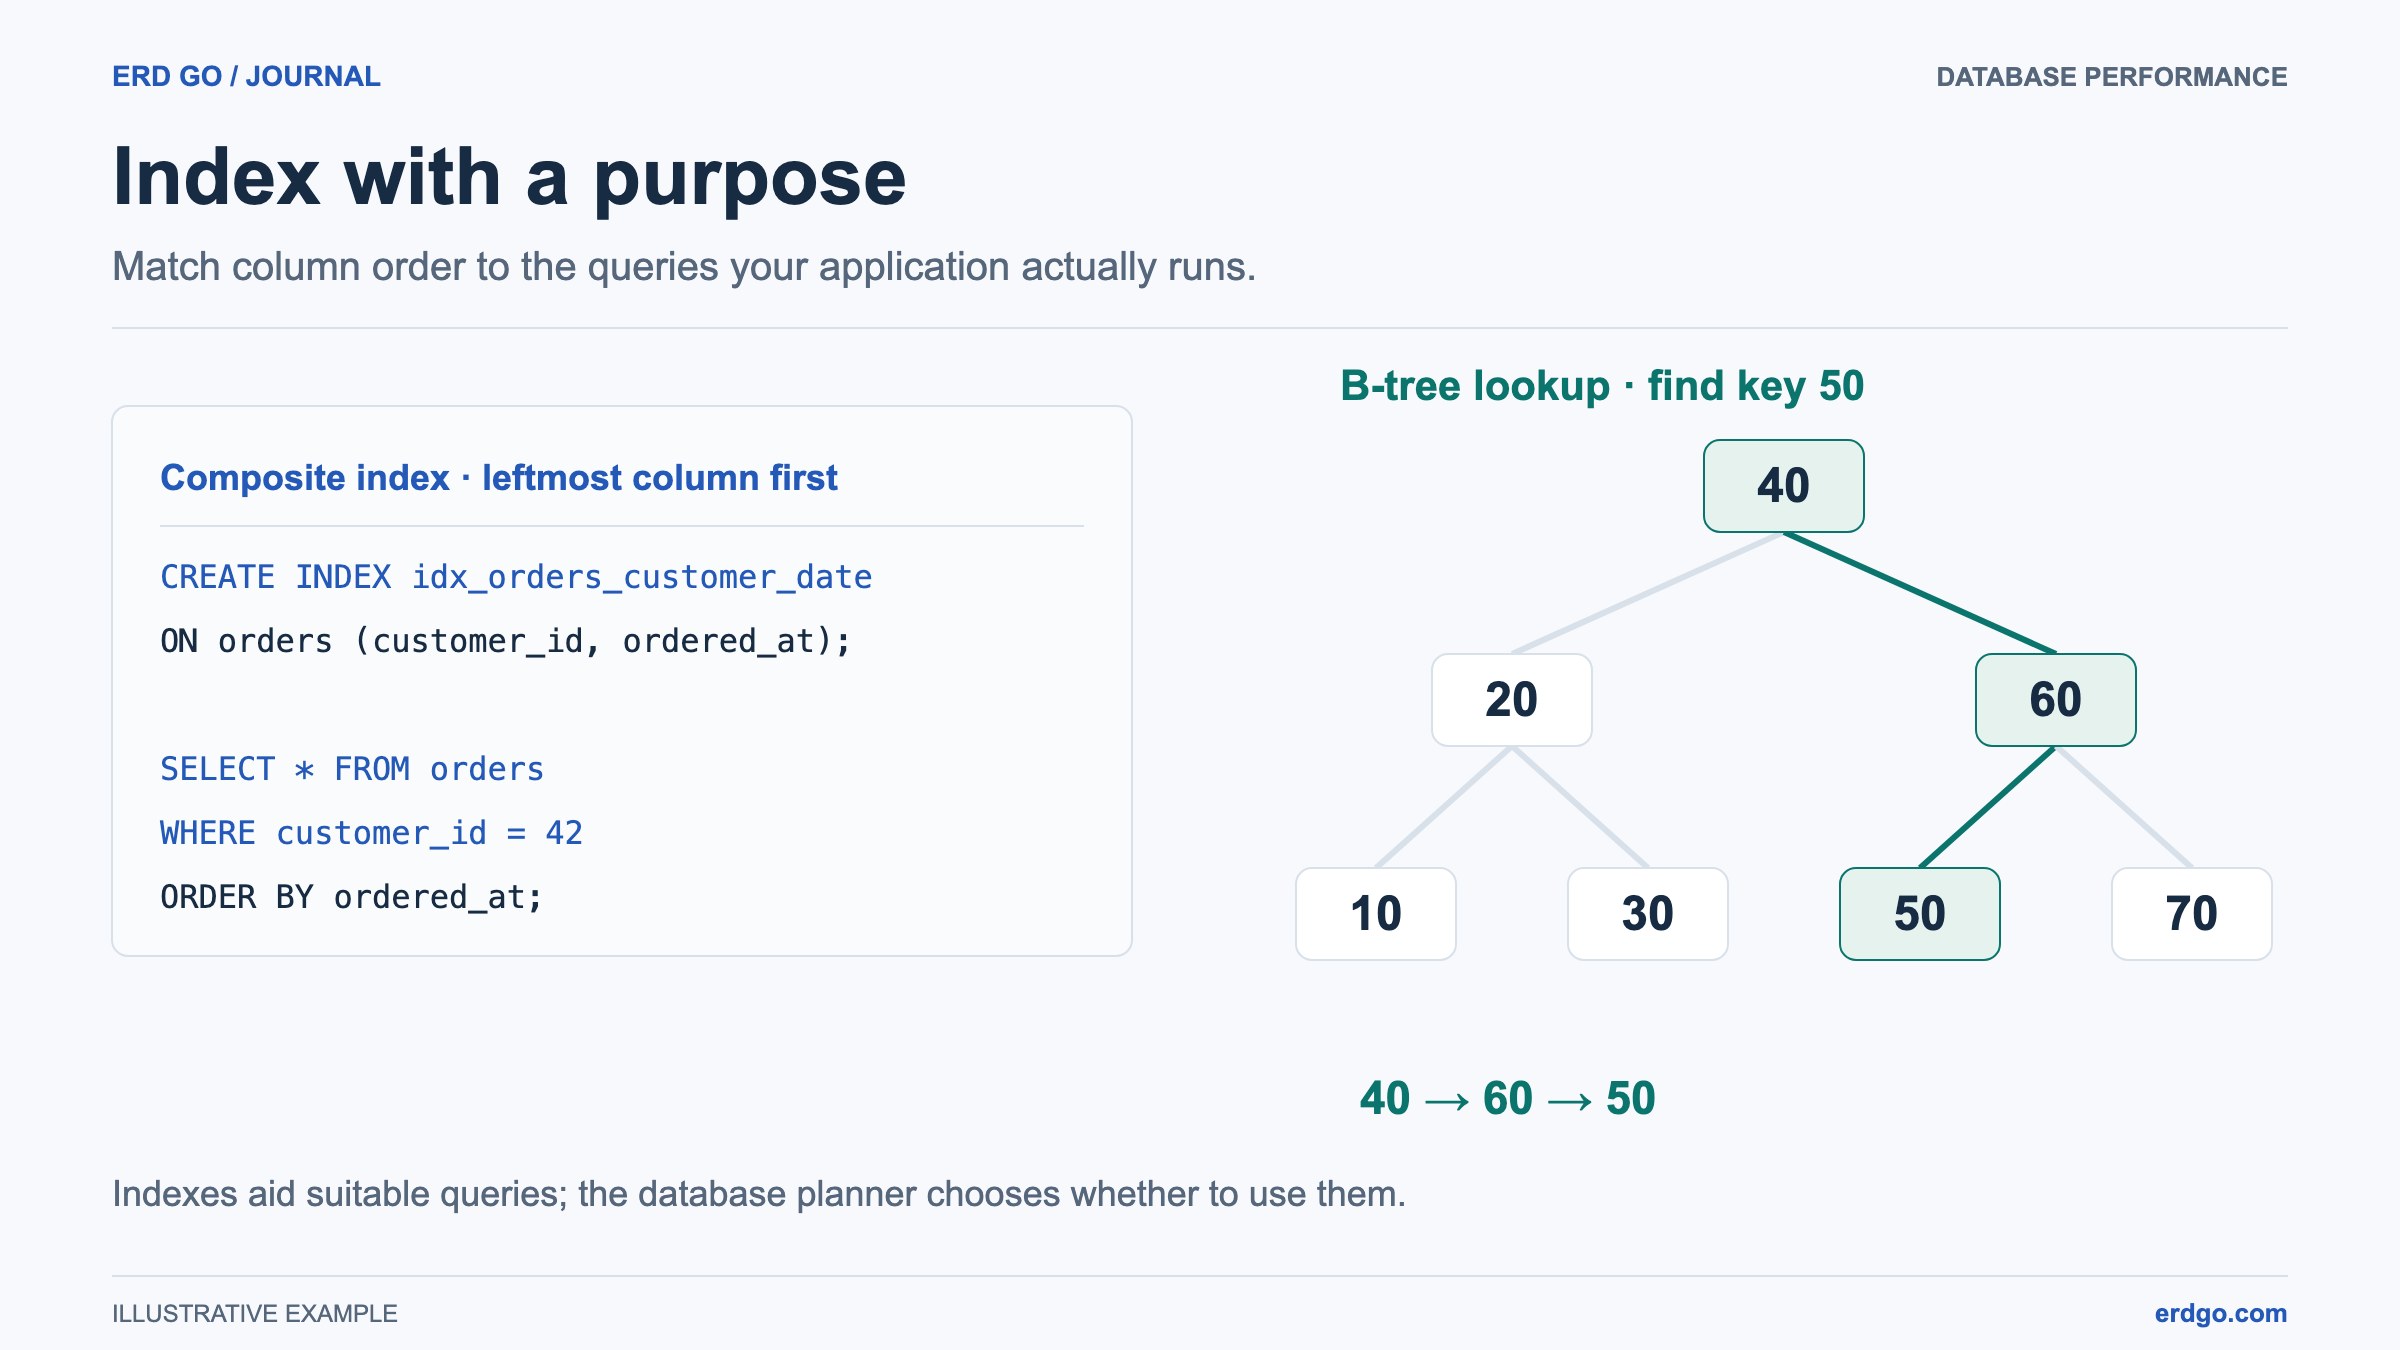
Der gebräuchlichste Indextyp über PostgreSQL, MySQL, SQL Server und SQLite hinweg ist der B-Baum (balancierter Baum). Stellen Sie es sich wie ein Telefonbuch vor: Anstatt jeden Namen von A bis Z zu lesen, öffnen Sie den ungefähren Abschnitt, grenzen Sie die richtige Seite ein und landen Sie beim Eintrag. Ein B-Baum funktioniert ähnlich:
- Der Baum ist organisiert in Knoten. Jeder interne Knoten enthält sortierte Schlüssel und Zeiger auf untergeordnete Knoten.
- Ein Nachschlagen beginnt bei der Stamm, vergleicht den Suchwert mit Knotenschlüsseln und folgt dem richtigen Zeiger nach unten durch Zweig Knoten.
- Es erreicht ein Blatt die übereinstimmende Einträge enthalten. Abhängig von der Engine und dem Index identifizieren Einträge Zeilen, enthalten einen geclusterten Schlüssel oder halten die Zeilendaten selbst.
- Der Baum bleibt balanciert, aber seine Tiefe und E/A hängen von der Schlüsselbreite, Seitengröße, Zeilenanzahl, Caching und davon ab, ob die Abfrage auch Tabellenseiten abruft.
-- Basic index on a single column
CREATE INDEX idx_employees_email ON employees (email);

-- The database now maintains a B-tree on the email column.
-- A selective filter is a candidate for an index lookup; check EXPLAIN:
SELECT * FROM employees WHERE email = '[email protected]';
Wann sollten Sie Indizes verwenden?
Indizes sind nicht kostenlos. Sie verbrauchen Speicherplatz und verursachen zusätzlichen Aufwand für jeden INSERT, UPDATE, und DELETE weil die Engine den Index synchron mit den Tabellendaten halten muss. Setzen Sie sie strategisch ein:
- Spalten in
WHEREKlauseln. Ein geeigneter Index kann einen häufigen selektiven Filter unterstützen; sein Nutzen hängt von der Datenverteilung und dem gewählten Plan ab. - Spalten in
JOINBedingungen. Indizes können Fremdschlüssel-Joins und Eltern-Updates oder -Löschungen unterstützen; ein großer Join kann immer noch einen Scan begünstigen. - Spalten in
ORDER BYundGROUP BY. Ein Index kann vorsortierte Daten liefern und so eine teure Sortieroperation eliminieren. - Spalten mit hoher Kardinalität. Spalten mit vielen unterschiedlichen Werten (wie E-Mail oder UUID) profitieren mehr als Spalten mit wenigen unterschiedlichen Werten (wie ein Boolean
is_activeFlag). - Große Tabellen. Eine Tabelle mit 100 Zeilen benötigt selten zusätzliche Indizes. Eine Tabelle mit 10 Millionen Zeilen fast sicher.
Als allgemeine Regel gilt: ohne zusätzliche Indizes starten, Abfrageleistung messen mit EXPLAIN, dann fügen Sie Indizes hinzu, wo die Daten es Ihnen sagen.
Arten von Indizes
Einzelspalten-Index
Die einfachste Form. Erstellt einen B-Baum auf einer Spalte. Ideal für Abfragen, die nur nach dieser Spalte filtern oder sortieren.
-- PostgreSQL / MySQL / SQLite
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- SQL Server
CREATE NONCLUSTERED INDEX idx_orders_customer ON orders (customer_id);
Zusammengesetzter (Mehrspalten-)Index
Ein Index über zwei oder mehr Spalten. Gleichheitsfilter auf führenden Spalten und ein Bereich auf der nächsten Spalte bilden oft einen effizienten B-Baum-Zugriffspfad. Andere Bedingungen können immer noch einen Scan oder Skip-Scan verwenden; Unterstützung und Kosten variieren je nach Engine und Version.
CREATE INDEX idx_orders_status_date
    ON orders (status, ordered_at);

-- Leading equality plus a date range is a candidate for this index:
SELECT * FROM orders
WHERE status = 'shipped' AND ordered_at > '2025-01-01';

-- Filtering on the leading column may also use this index:
SELECT * FROM orders WHERE status = 'pending';

-- A date-only filter may scan or use a skip scan; inspect the plan:
SELECT * FROM orders WHERE ordered_at > '2025-01-01';
Wählen Sie die Spaltenreihenfolge anhand von Gleichheitsfiltern, Bereichsbedingungen, Sortier- und Abdeckungsanforderungen. „Am selektivsten zuerst“ ist keine allgemeingültige Regel. PostgreSQL 18 kann B-Tree-Skip-Scans für geeignete nicht führende Filter verwenden.
Eindeutiger Index
Erzwingt eine Eindeutigkeitsbeschränkung und bietet gleichzeitig indexbasierte Suchleistung. Die meisten Datenbanken erstellen automatisch einen eindeutigen Index, wenn Sie eine definieren: UNIQUE Bedingung oder PRIMARY KEY.
CREATE UNIQUE INDEX idx_users_email ON users (email);

-- Enforces uniqueness; constraint metadata and eligible FK targets vary by engine:
-- ALTER TABLE users ADD CONSTRAINT uq_email UNIQUE (email);
Teilweiser (gefilterter) Index
Indiziert nur die Zeilen, die eine erfüllen WHERE Bedingung. Dies hält den Index klein und hochspezifisch.
-- PostgreSQL partial index
CREATE INDEX idx_orders_active
    ON orders (customer_id)
    WHERE status NOT IN ('delivered', 'cancelled');

-- SQL Server: a supported simple comparison filter
CREATE INDEX idx_orders_pending
    ON orders (customer_id)
    WHERE status = 'pending';
Ein partieller oder gefilterter Index kann eine kleine, häufig abgefragte Teilmenge unterstützen. Die Abfrageprädikat muss den Filter implizieren. Die Filter-Syntax von SQL Server ist restriktiver als die von PostgreSQL; kopieren Sie keine beliebigen Prädikate zwischen ihnen.
Andere Indextypen
| Index-Typ | Am besten für | Datenbankunterstützung |
|---|---|---|
| Hash | Exakte Gleichheits-Lookups (=) | PostgreSQL, MySQL (Memory Engine) |
| GIN | Volltextsuche, JSONB, Arrays | PostgreSQL |
| GiST | Geometrische und Bereichs-Datentypen | PostgreSQL |
| BRIN | Sehr große Tabellen mit natürlich sortierten Daten | PostgreSQL |
| Volltext | Textsuche mit Relevanzranking | MySQL, SQL Server |
Gängige Indexierungsfehler
Selbst erfahrene Entwickler tappen in diese Fallen. Vermeiden Sie sie, um die Leistung Ihrer Datenbank zu erhalten.
1. Überindizierung
Das Hinzufügen eines Index zu jeder Spalte „nur für den Fall“ verschwendet Speicherplatz und verlangsamt Schreibvorgänge. Jeder Index muss bei jedem INSERT, UPDATE und DELETE aktualisiert werden. Eine Tabelle mit 15 Indizes hat einen deutlich geringeren Schreibdurchsatz als eine mit 3 gut gewählten Indizes.
2. Indizierung von Spalten mit geringer Kardinalität
Indizierung eines Booleans is_active Spalte, die nur enthält TRUE und FALSE kann nützlich sein, wenn Werte stark verzerrt sind oder der Index eine enge Abfrage abdeckt. Die Kardinalität allein entscheidet nicht darüber, ob ein Index hilft. Wenn Sie nach solchen Spalten filtern müssen, kombinieren Sie sie in einem zusammengesetzten Index mit einer Spalte höherer Kardinalität oder verwenden Sie einen Teilindex.
3. Abfragemuster ignorieren
Ein Index ist nur dann nützlich, wenn Ihre tatsächlichen Abfragen ihn nutzen können. Untersuchen Sie immer die langsamen Abfragen in Ihrer Anwendung zuerst, dann entwerfen Sie Indizes, die auf diese spezifischen Zugriffsmuster abzielen.
-- Use EXPLAIN to see if your index is being used
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 7 AND status = 'shipped';

-- Look for "Index Scan" or "Index Only Scan" in the output.
-- Bitmap Index Scan is another index access path. Seq Scan can be appropriate.
4. Vergessen, Fremdschlüssel zu indizieren
In PostgreSQL sind Fremdschlüsselspalten nicht automatisch indiziert (im Gegensatz zu MySQL InnoDB, das standardmäßig einen Index für Fremdschlüssel erstellt). Ein Index kann bei selektiven Joins und referenziellen Prüfungen helfen, aber der Optimierer kann sich für einen Scan oder Hash Join entscheiden. Prüfen Sie vor dem Hinzufügen eines weiteren Indexes, ob bereits ein Index vorhanden ist, dessen führende Spalten den Fremdschlüssel abdecken.
-- Consider these only when equivalent access paths do not exist
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
CREATE INDEX idx_order_items_order_id ON order_items (order_id);
CREATE INDEX idx_order_items_product_id ON order_items (product_id);
5. Niemals ungenutzte Indizes überprüfen
Im Laufe der Zeit ändert sich der Anwendungscode, und alte Indizes bedienen möglicherweise keine Abfrage mehr. Ungenutzte Indizes verbrauchen dennoch Speicherplatz und verlangsamen Schreibvorgänge ohne jeglichen Lesenutzernutzen.
Überwachung der Indexnutzung
Moderne Datenbanken stellen Systemansichten bereit, die berichten, wie oft jeder Index verwendet wird. Die regelmäßige Überprüfung dieser Ansichten hilft Ihnen, ungenutzte Indizes zu löschen und fehlende zu erkennen.
PostgreSQL
-- Find unused indexes (0 scans since last stats reset)
SELECT
    schemaname,
    relname AS table_name,
    indexrelname AS index_name,
    idx_scan AS times_used,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
ORDER BY pg_relation_size(indexrelid) DESC;
MySQL
-- MySQL: no row fetches recorded since these counters were reset
SELECT
    object_schema,
    object_name AS table_name,
    index_name,
    count_fetch AS row_fetches
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
  AND count_fetch = 0
  AND object_schema = 'your_database';
Betrachten Sie Null-Lesevorgänge als Kandidaten für eine Überprüfung, nicht als Erlaubnis, einen Index zu löschen. Prüfen Sie, wann die Zähler zurückgesetzt wurden, ob die Instrumentierung aktiviert ist und ob saisonale Abfragen, Einschränkungen oder Fremdschlüsselprüfungen ihn benötigen. Testen Sie eine vorgeschlagene Entfernung mit einer repräsentativen Arbeitslast.
Indizes im Schemaentwurf und in ERDs
Obwohl sich ERD-Builder in erster Linie auf Tabellen, Spalten und Beziehungen konzentrieren, sind Indizes ein wichtiger Teil des gesamten Schemadesigns. Berücksichtigen Sie bei der Planung Ihrer Datenbank Indizes neben Ihren Tabellendefinitionen:
- A Primärschlüssel hat normalerweise einen von der Engine verwalteten Zugriffspfad. SQLite INTEGER PRIMARY KEY verwendet die rowid anstelle eines separaten eindeutigen Index; überprüfen Sie die Engine, bevor Sie einen doppelten Index hinzufügen.
- Zugriffspfade überprüfen für Fremdschlüssel. PostgreSQL erstellt nicht automatisch Indizes auf der untergeordneten Seite, aber ein vorhandener zusammengesetzter Index deckt die Beziehung möglicherweise bereits ab.
- Spalten mit UNIQUE-Constraints erhalten einen automatischen eindeutigen Index.
- Zusätzliche Indizes für häufig abgefragte Spalten sollten zusammen mit Ihrem Schema-DDL dokumentiert werden, damit sie bei der Bereitstellung nicht vergessen werden.
-- Include indexes in your schema DDL files for reproducibility
CREATE TABLE products (
    id          SERIAL PRIMARY KEY,
    name        VARCHAR(200) NOT NULL,
    category_id INT REFERENCES categories (id),
    price       NUMERIC(10, 2) NOT NULL,
    created_at  TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_products_category ON products (category_id);
CREATE INDEX idx_products_price ON products (price);
CREATE INDEX idx_products_created ON products (created_at DESC);
Visualisieren Sie Ihr vollständiges Schema – Tabellen, Beziehungen und die Spalten, die Sie indizieren möchten –, indem Sie Ihr DDL einfügen in den Erd Go Editor. Die visuelle Betrachtung der Struktur offenbart oft Spalten, die indiziert werden müssen (wie häufig verknüpfte Fremdschlüssel), die man beim Lesen von rohem SQL möglicherweise übersieht.